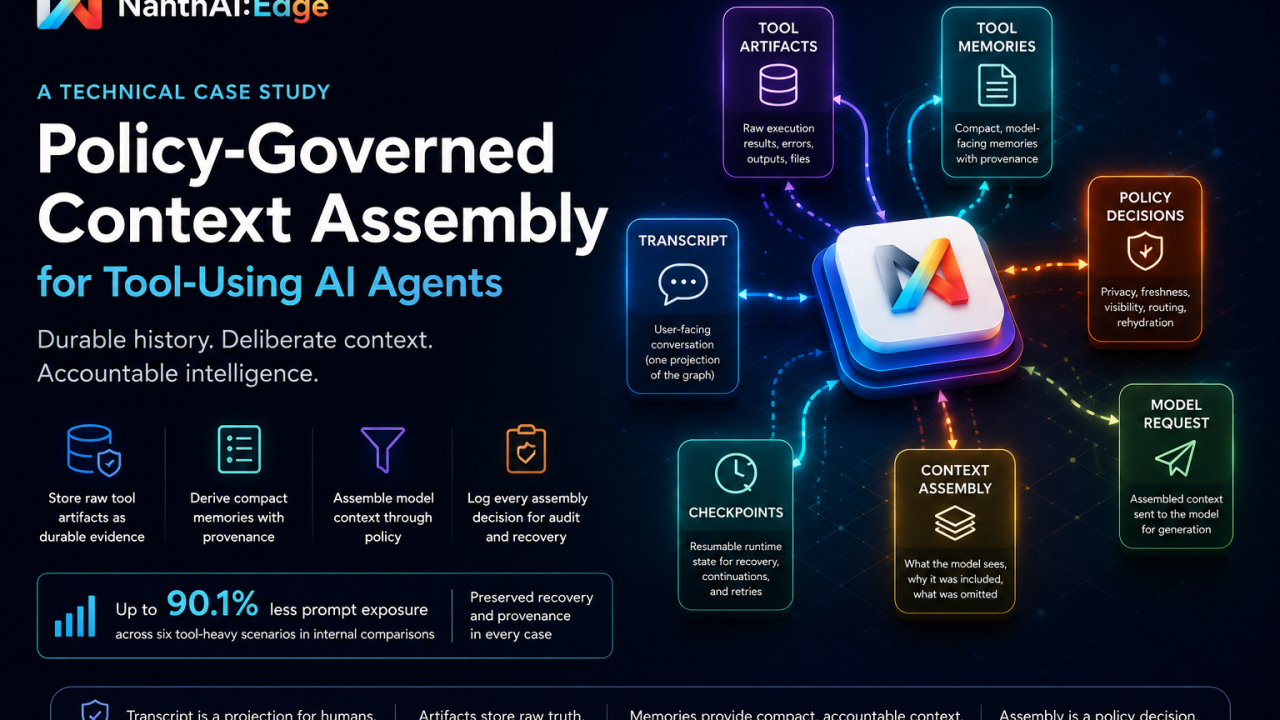
Un estudio de caso técnico de NanthAI:Edge.
La mayoría de los agentes de IA que usan herramientas escalan el historial de la forma equivocada: cada llamada a una herramienta, resultado, archivo generado, reintento, resumen, error y continuación se vuelve a enviar a través del historial visible del chat hasta que se recorta, se compacta o se pierde.
En NanthAI:Edge, esto no es solo una teoría. En pruebas comparativas internas, el contexto ensamblado a partir del grafo redujo la exposición del prompt de 1905 a 221 tokens en un flujo de generación de archivos con varias herramientas, de 1986 a 197 tokens en un flujo de contradicción/sustitución y de 1020 a 142 tokens en un flujo de selector de documentos diferido. Eso no demuestra un mayor éxito en las tareas, pero sí demuestra que la superficie de contexto expuesta al modelo puede reducirse considerablemente conservando el estado de recuperación y procedencia.
La forma más fácil de construir un agente de IA sigue siendo añadir cosas al chat sin parar.
El usuario hace una pregunta. El modelo llama a una herramienta. La herramienta devuelve un resultado. El resultado se incorpora a la conversación. El modelo llama a otra herramienta. Se añade otro resultado. El agente escribe un archivo, encuentra un error, reintenta, resume, crea una rama, retoma el trabajo más tarde, quizá crea un subagente, y el historial sigue creciendo.
Al principio parece natural. El historial está ahí. Está ordenado. Es legible. Parece una memoria. Pero, para los agentes que usan herramientas, el historial es una trampa.
El historial es lo que el usuario debería poder leer. No es lo mismo que lo que el modelo debería ver a continuación. Cuando un agente ejecuta herramientas, maneja archivos, llama a API, trabaja en distintas ramas, compara modelos o lleva un estado de ejecución privado, el registro visible del chat se convierte en una fuente de verdad deficiente. Mezcla la experiencia de usuario del producto, las evidencias, la memoria, el estado de reintentos, los límites de privacidad, las observaciones desactualizadas y los registros de auditoría en un solo flujo cronológico.
El patrón más adecuado consiste en tratar el historial como una proyección de un grafo de ejecución más rico. Las salidas en bruto de las herramientas se almacenan como artefactos persistentes. De esos artefactos se derivan memorias compactas. La procedencia vincula la memoria con las evidencias. Las ramas, los participantes, las ejecuciones de modelos, las llamadas a herramientas, los puntos de control y las decisiones de políticas son entidades independientes. Cada solicitud al modelo recibe un contexto ensamblado a partir de ese grafo y regido por políticas, en lugar de reproducir a ciegas los antiguos mensajes del chat.
Esa es la arquitectura que defiende este artículo: no «más memoria», ni «basta con usar una ventana de contexto más grande», ni «GraphRAG para todo». La idea es más precisa: el historial de un agente debe ser persistente sin reproducirse eternamente, y el contexto del modelo debe ensamblarse de forma deliberada en lugar de heredarse del orden de los mensajes.
Resumen
Los agentes basados en grandes modelos de lenguaje (LLM) que usan herramientas afrontan una tensión estructural entre el historial de conversación, el estado de ejecución, las evidencias de herramientas, la memoria, la privacidad y la economía del contexto. Un patrón habitual de implementación trata el historial visible tanto como historial para el usuario como contexto para el modelo: los mensajes anteriores, las llamadas a herramientas, sus resultados, los resúmenes, los errores y los artefactos generados se vuelven a incluir en solicitudes posteriores hasta que se recortan, se compactan o se pierden. Este enfoque es sencillo, pero acopla la experiencia de usuario a la cognición del entorno de ejecución y hace que la selección de contexto sea un subproducto accidental del orden de los mensajes.
Este artículo desarrolla el patrón de diseño del ensamblado del contexto regido por políticas, en el que el historial se trata como una proyección de un grafo de ejecución más rico y no como la fuente de verdad del modelo. El entorno de ejecución almacena por separado los artefactos en bruto y las memorias compactas de herramientas, conserva la procedencia que vincula la memoria derivada con las evidencias, lleva un registro de la titularidad de participantes y ramas y registra las decisiones de ensamblado del contexto bajo versiones explícitas de políticas.
El artículo sitúa este patrón frente a trabajos previos sobre ingeniería de contexto, memoria de agentes, estado en grafos, registro de eventos como fuente de estado, memoria consciente de la procedencia, fallos por memorias desactualizadas, inyección de prompts y trazas de auditoría de agentes. Después usa NanthAI:Edge como un ejemplo de implementación del patrón.
El artículo sostiene que la contribución más sólida es el contrato integrado del entorno de ejecución: artefactos persistentes de herramientas, memorias compactas de herramientas, ensamblados del contexto como entidades propias, decisiones de políticas, titularidad del estado de ejecución delimitada por participante, selección del grafo consciente de las ramas, políticas de vigencia y sustitución, rehidratación de artefactos en bruto y una separación deliberada entre la cognición del entorno de ejecución y el historial visible para el usuario.
La contribución consiste en un marco conceptual para separar el historial del contexto en agentes que usan herramientas, un análisis orientado a la implementación de la arquitectura de artefactos persistentes y ensamblado del contexto de NanthAI:Edge, una comparación con trabajos previos de ingeniería de contexto y entornos de ejecución basados en grafos, un catálogo de riesgos de la capa de políticas y mediciones de implementación obtenidas de escenarios comparativos internos.
1. Introducción
En el anterior artículo de NanthAI escribí sobre el uso de skills como puertas de acceso a las herramientas. El problema era la sobrecarga de capacidades. A medida que un agente incorpora más flujos de trabajo, integraciones e instrucciones de dominio, el enfoque ingenuo consiste en seguir añadiendo texto al prompt y esquemas de herramientas a cada solicitud. NanthAI:Edge lo evita exponiendo primero un catálogo compacto de skills y cargando después las instrucciones completas y ampliando el registro de herramientas ejecutables solo cuando una tarea lo justifica. Eso resuelve una mitad del problema del contexto. La otra mitad aparece después de ejecutar las herramientas.
Las llamadas a herramientas producen resultados de búsqueda, archivos, citas, datos de API, datos derivados de OAuth, errores, salidas parciales, estado de reintentos, artefactos generados, estado de trabajo provisional privado, observaciones externas desactualizadas, estado de subagentes y puntos de control de continuación. Si el entorno de ejecución sigue reproduciendo todo eso a través del historial visible del chat, el contexto del modelo se vuelve costoso, ruidoso y, a veces, incorrecto.
Esto crea dos problemas relacionados.
- La sobrecarga del historial ocurre cuando se acumulan en el historial de la conversación antiguas llamadas a herramientas, sus resultados, artefactos generados, resúmenes, reintentos y estado operativo, y se vuelven a pasar al modelo repetidamente.
- La ambigüedad del estado de ejecución ocurre cuando se pide al historial que actúe simultáneamente como historial del usuario, memoria del modelo, traza de auditoría, estado de reintentos, frontera de privacidad y almacén de evidencias de herramientas.
Ambos son costosos. Consumen tokens de entrada, aumentan la latencia y el coste, complican el enrutamiento a proveedores y dificultan saber qué conocía realmente el modelo cuando generó una respuesta.
Más importante aún, pueden perjudicar la exactitud. Un modelo puede tomar como verdad actual una salida de herramienta desactualizada. Un resumen puede eliminar un error crucial para reintentar. Una rama puede heredar el archivo generado de otra rama hermana. El espacio de trabajo provisional privado de un participante puede filtrarse al contexto de otro modelo. Un resumen compacto puede perder el valor exacto que después se necesita para una auditoría o rehidratación.
Este artículo examina una alternativa estructurada: el ensamblado del contexto regido por políticas sobre un grafo de ejecución.
El patrón es sencillo: tratar el historial como la historia dirigida a las personas, almacenar los artefactos en bruto de herramientas por separado de los mensajes, derivar memorias compactas de esos artefactos, conservar la procedencia desde la memoria hasta las evidencias en bruto, ensamblar cada solicitud al modelo a partir del estado del grafo bajo una política explícita y registrar suficiente información de la decisión de ensamblado para explicar qué vio el modelo y por qué.
En NanthAI:Edge no fue necesario cambiar la interfaz pública del chat para que la arquitectura funcionara. Los usuarios siguen viendo mensajes, tarjetas de herramientas, archivos generados, citas, ramas, reintentos, continuaciones y respuestas de modelos. Por detrás, el entorno de ejecución separa el historial, los artefactos, las memorias, las decisiones de políticas y los ensamblados del contexto.
La misma separación se aplica a los distintos modos de ejecución. Un turno normal de chat, una comparación multimodelo, una discusión autónoma, una ejecución de un subagente hijo, una reanudación del agente padre tras los subagentes, una tarea programada y un envío en una rama no tienen todos el mismo contrato de contexto. Una discusión autónoma de tipo debate debe conservar las etiquetas de los interlocutores y las directrices del moderador. Un subagente hijo no debe filtrar por defecto a su padre el estado en bruto del espacio de trabajo. Una reanudación del padre debe respetar su punto de control determinista en lugar de consultar a ciegas el historial. El ensamblado del contexto debe tener en cuenta el modo de ejecución.
El artículo aporta un vocabulario para separar historial, contexto, artefacto, memoria y política; una arquitectura concreta de artefactos persistentes de herramientas y memorias compactas de herramientas; un análisis del estado de ejecución delimitado por participante en flujos multimodelo y de subagentes; una comparación con trabajos previos; y una interpretación de las mediciones de implementación y sus límites.
TRANSCRIPT PROJECTION (User-Facing UI)
Ordered messages · Tool cards (truncated) · Generated files · Citations · Branches · Model responses
One projection of the same runtime graph
RUNTIME GRAPH (Durable State)
- MESSAGE (User/Assistant): User prompts; Assistant prose; Tool call / result messages (truncated for UI); Visible transcript
- MODEL RUN (Generation Attempt): Provider; Model & parameters; Participant; Message / Job ownership; Runtime mode
- TOOL CALL (Requested): Tool name; Arguments; Call ID; Status (requested / pending / failed); Model run linkage
- TOOL ARTIFACT (Raw Execution): Full arguments; Raw result or error; Status, timing; Tool version; Privacy classification; Storage handles; Hashes / byte size
- TOOL MEMORY (Compact, Model-Facing): Summary / structured data; Source artifact ID(s); Confidence + source; Freshness & stale-after; Provenance locators; Contradictions / supersession; Revalidation tools
- CONTEXT ASSEMBLY (Policy-Governed): Policy version; Assembler version; Selected memories; Rehydrated artifacts; Legacy vs assembled tokens; Omission summaries; Timing & telemetry
- MODEL REQUEST (Provider Prompt): System / instructions; Selected messages; Selected memories; Rehydrated raw (if any); Skill state; Recovery state; Provider + settings
KEY RELATIONSHIPS
Primary execution flow →
Artifacts produced by calls
Memories derived from artifacts
Policy selection & assembly
UI projection (readable view)
WHAT HAPPENS WHERE
ToolCall → ToolArtifact: Execute the tool and capture raw evidence.
ToolArtifact → ToolMemory: Extract, summarize, classify, link provenance.
ToolMemory → ContextAssembly: Policy decides what to include.
ContextAssembly → Model Request: Serialize the selected context.
Transcript Projection: Human-readable view, not the source of truth.
POLICY CONSIDERS
Ownership (participant / model run / branch)
Visibility (private / branch / conversation / audit)
Privacy & provider-routing constraints
Freshness, staleness, revalidation needs
Promotion, contradiction, supersession
Recovery state & retry protection
Context budget & raw rehydration bounds
Retention, deletion, and safety rules
OUTCOME
The model sees a deliberate, policy-governed context assembled from durable runtime state — not a blind replay of the transcript.
Smaller context. Better signal. Preserved evidence. Clear auditability.
Core Principle: Transcript is a projection for humans. Artifacts are raw truth. Memories provide compact, accountable context. Assembly is a policy decision.
2. Antecedentes: ingeniería de contexto, memoria y estado de herramientas
2.1 Ingeniería de contexto
La ingeniería de contexto es la práctica de decidir qué información entra en el contexto del modelo. Es más amplia que la redacción de prompts. Incluye instrucciones del sistema, historial de conversación, evidencias recuperadas, salidas de herramientas, memoria, políticas, estado de tareas y formato.
Las guías modernas de ingeniería de contexto respaldan la idea de que el contexto del modelo debe ensamblarse explícitamente en lugar de tratarse como un historial en bruto. Anthropic describe la ingeniería de contexto como el trabajo de gestionar la información que se suministra a los agentes. Haystack y Atlan también describen el contexto como zonas estructuradas: instrucciones, historial, recuperación, salidas de herramientas y memoria.
Esta distinción importa porque las distintas clases de contexto tienen distintas duraciones y propiedades de confianza. Un mensaje del usuario, un identificador de archivo generado, un conjunto de datos de OAuth, un resultado de búsqueda desactualizado, un error de herramienta que permite reintento y una cita de documento no deben recortarse, resumirse, conservarse ni exponerse bajo la misma regla.
El historial resulta especialmente engañoso porque parece completo. Contiene evidencias cronológicas de que algo ocurrió. No contiene necesariamente lo que ocurrió en bruto, la política que lo permitió, la rama a la que pertenecía, el participante que lo vio ni la razón por la que los turnos posteriores deberían seguir confiando en ello. Para un producto de chat sencillo, la cronología puede ser una aproximación suficiente al contexto. Para los agentes que usan herramientas, la cronología es solo un eje.
Por eso la arquitectura trata el contexto como una proyección ensamblada. Esa proyección puede incluir turnos recientes de conversación, memorias de herramientas seleccionadas, estado de herramientas sin resolver, estado de skills cargadas, restricciones de proveedor y privacidad, y artefactos en bruto seleccionados. También puede omitir registros desactualizados, privados, sustituidos, no admisibles en la rama, que excedan el presupuesto o que no sean seguros para el proveedor seleccionado. La inclusión es una decisión, no un accidente de la antigüedad de los mensajes.
2.2 Memoria de agentes
La investigación sobre memoria de agentes suele distinguir memoria de trabajo, episódica, semántica, procedimental y a largo plazo. Marcos como LangGraph distinguen memoria a corto y largo plazo. Las revisiones sobre memoria de agentes LLM destacan que el campo sigue fragmentado: no existe un esquema consolidado entre marcos para representar la memoria, su procedencia, vigencia, contradicciones o conservación.
Esa fragmentación importa. «Memoria» se usa a menudo como un término amplio para cosas muy distintas: preferencias del usuario, datos extraídos de conversaciones anteriores, resúmenes de diálogos antiguos, observaciones de herramientas, referencias a archivos generados, documentos recuperados, planes de tareas, trazas de ejecución y referencias de procedencia.
La arquitectura separa la memoria del usuario de la memoria de herramientas. La memoria del usuario se ocupa de la personalización. La memoria de herramientas se ocupa de las evidencias de ejecución derivadas de los artefactos de herramientas.
Esa separación es más que una clasificación del producto. Evita que una observación de ejecución se convierta en un dato persistente del usuario solo porque apareció en un chat. Si una herramienta lee un hilo de Slack, eso puede crear una memoria acotada útil sobre el estado del hilo. No debería convertirse en una preferencia permanente del usuario. Si una herramienta de generación de documentos crea un archivo, la referencia al archivo puede ser estado operativo persistente. No es el mismo tipo de memoria que «el usuario prefiere respuestas concisas».
Por tanto, la memoria de herramientas necesita campos que la memoria habitual de personalización a menudo no requiere: identificadores de artefactos, nombres de herramientas de origen, clase de privacidad, clase de vigencia, localizadores de procedencia, fuente de confianza, intentos de reparación, enlaces de contradicción, enlaces de sustitución y política de promoción. En esta arquitectura, la memoria no es «lo que el modelo quizá quiera recordar». Es una representación compacta de evidencias, regida por políticas, de la que el entorno de ejecución puede dar cuenta.
2.3 Trazas de herramientas como estado
Los agentes que usan herramientas crean estado cada vez que se llama a una herramienta. Los argumentos de la llamada, el resultado, el error, los tiempos, el proveedor, el entorno de ejecución, el estado de skills activas y el contexto de titularidad pueden ser importantes más adelante.
Esto se reconoce cada vez más en la industria y la investigación. Databricks trata las trayectorias de llamadas a herramientas y sus resultados de ejecución como estado del agente. LangGraph persiste el estado del grafo y los puntos de control. MCP hace explícitas las herramientas y las fuentes de contexto y permite registrarlas de forma estructurada. Los trabajos de registro de eventos como fuente de estado sostienen que los agentes autónomos necesitan registros a los que solo se añada contenido y que permitan reconstrucción y auditoría.
La deducción clave es que los resultados de las herramientas no deben vivir solo como mensajes del historial. Los mensajes son útiles para mostrarlos. Son una capa de almacenamiento débil para las evidencias en bruto.
Un mensaje del historial suele estar optimizado para la lectura humana y la compatibilidad de los clientes. Puede truncarse, ocultar datos, resumirse, reordenarse para su presentación o desaparecer por compactación. Eso es exactamente lo que necesita la interfaz de un producto. No es lo que necesita un sistema de recuperación cuando el usuario dice después «usa el CSV exacto de antes» o cuando una auditoría pregunta por qué se citó un identificador de archivo concreto.
La arquitectura captura el artefacto antes de esa transformación orientada a mostrarlo. El mensaje puede seguir mostrando una tarjeta de herramienta limpia o un resultado compacto. El almacén de artefactos conserva los argumentos en bruto, el resultado o error en bruto, los hashes, los recuentos de bytes, las referencias de almacenamiento, el titular del estado de ejecución, la clasificación de privacidad y los metadatos de versión de herramientas necesarios para recuperar y auditar.
2.4 Memoria desactualizada y contradicción
La memoria persistente introduce un modo de fallo: el agente puede seguir basándose en información que ha quedado desactualizada, contradicha o sustituida. Evaluaciones como STALE y estudios como LOCCO ilustran que la memoria a largo plazo no es fiable de forma automática. Recordar más puede empeorar el sistema si los datos antiguos se tratan como verdad actual.
Esto respalda una política explícita de vigencia y sustitución. Un resumen de hilo de Slack, una instantánea de CRM, un resultado de disponibilidad del calendario, una referencia a un archivo generado y una versión inmutable de un documento no deben envejecer del mismo modo.
El problema de la memoria desactualizada no es solo que los datos antiguos dejen de ser ciertos. Es que el modelo suele recibirlos sin una marca visible de caducidad. Un resultado de disponibilidad del calendario de hace seis semanas y un identificador inmutable de versión de documento pueden aparecer ambos como «contexto anterior» si el entorno solo reproduce mensajes. La arquitectura hace explícita esa diferencia mediante clases de vigencia y metadatos de caducidad.
La contradicción es el modo de fallo relacionado. Dos memorias pueden derivarse de artefactos reales y aun así entrar en conflicto porque proceden de distintas versiones de documentos, ramas, proveedores o métodos de extracción. El sistema no debe fusionar esos registros en un único resumen donde gana la última escritura salvo que una política tenga suficiente información de procedencia y confianza para justificar esa resolución.
2.5 Procedencia y auditoría
La memoria consciente de la procedencia es un tema emergente. MemORAI vincula memorias de grafo con turnos de origen. Portable Agent Memory propone objetos de memoria con procedencia verificada. ARGUS usa grafos de influencia y procedencia para razonar sobre llamadas inseguras a herramientas. La literatura sobre trazas de auditoría y registro de eventos como fuente de estado también defiende que los sistemas de IA necesitan historiales reconstruibles de eventos de datos, modelos, herramientas y decisiones.
Para un entorno de ejecución de agentes, la pregunta importante de auditoría es:
¿Por qué dijo esto el modelo?
La respuesta no puede venir solo del historial. Requiere saber qué contexto se ensambló, qué memorias se incluyeron, qué artefactos en bruto se rehidrataron, qué políticas omitieron datos y a qué participante o rama pertenecía el estado. Hay una segunda pregunta de auditoría igual de importante:
¿Por qué no vio el modelo algo?
Aquí es donde el ensamblado regido por políticas difiere del registro habitual. Un incidente en producción puede no deberse a un resultado incorrecto de una herramienta. Puede deberse a que se excluyó un resultado útil por estar desactualizado, exceder el presupuesto, no ser admisible en la rama, ser privado de otro participante, estar clasificado como datos derivados de Google o tener bloqueada la rehidratación en bruto. La arquitectura registra resúmenes compactos de omisiones para que la depuración pueda preguntar por la ausencia, no solo por la presencia.
3. Ensamblado del contexto regido por políticas
El ensamblado del contexto regido por políticas trata el contexto del modelo como una proyección sobre el estado de ejecución. El historial no se descarta. Sigue siendo la historia dirigida a las personas. Pero ya no se le pide que asuma todas las responsabilidades del entorno de ejecución.
El entorno distingue mensajes del historial, ejecuciones de modelos, llamadas a herramientas, artefactos en bruto de herramientas, memorias compactas de herramientas, estado de skills cargadas, puntos de control de continuación, linaje de ramas, titularidad de participantes, decisiones de políticas y registros de ensamblado del contexto. Un ensamblador puede elegir entonces qué ve el modelo según la tarea actual, la rama, el participante, el proveedor, la política de privacidad, la política de vigencia y el estado de recuperación.
Este patrón separa cuatro superficies que a menudo se confunden. El historial es para el usuario: legible, estable y adecuado para el producto. El almacén de artefactos es para el entorno de ejecución y la capa de auditoría: evidencias en bruto, capacidad de recuperación y política de conservación. La memoria de herramientas es para el contexto del modelo: compacta, vinculada a la procedencia y consciente de la vigencia. El ensamblado del contexto es para la solicitud al modelo en sí: la selección regida por políticas para una generación.
La relación más importante es:
la ejecución de herramientas crea primero artefactos; la memoria es una decisión de política que se aplica sobre ellos.
Este es el núcleo conceptual de la arquitectura. La segunda relación es:
el ensamblado del contexto es una consulta a un grafo restringida por políticas, no una transformación del historial.
El ensamblador parte de los límites de la generación activa: el chat actual, el mensaje de usuario de origen, el linaje de ramas, el participante, el tipo de entorno de ejecución, el estado de continuación, el proveedor seleccionado, las skills cargadas y la disponibilidad de herramientas. Después selecciona los registros admisibles del grafo y decide cómo debe aparecer cada uno. Un mensaje reciente puede permanecer como contexto de conversación. Una observación de herramienta puede entrar como memoria compacta. Un registro desactualizado puede aparecer solo como una marca de desactualización y una indicación de revalidación. Un artefacto en bruto puede rehidratarse cuando se requieren evidencias exactas. Una llamada a herramienta sin resolver puede protegerse como estado de recuperación. Un registro privado, desactualizado, sustituido, no admisible en la rama o restringido por el proveedor puede omitirse, registrando el motivo de la omisión sin exponer el contenido.
Este diseño no requiere que cada operación de recuperación consulte una base de datos de grafos. El grafo es el modelo del entorno de ejecución: conversaciones, ramas, participantes, ejecuciones de modelos, llamadas a herramientas, artefactos, memorias, puntos de control, ensamblados y decisiones de políticas enlazados. La búsqueda vectorial, las consultas indexadas a tablas, las lecturas de almacenamiento y el recorrido de grafos pueden ser técnicas de implementación dentro de ese modelo.
Un modelo mental útil es:
Historial visible para el usuario = una proyección legible de nodos Message seleccionados
Contexto dirigido al modelo = una proyección seleccionada por políticas sobre Message + ToolMemory + ToolArtifact + SkillState + ContinuationCheckpoint + PolicyDecision + linaje de Branch
La diferencia no es académica. Un historial responde a «¿Qué parecieron decir el usuario y el asistente?». Un grafo de ejecución responde a las preguntas que el historial no puede responder: qué ejecución del modelo produjo la respuesta, qué herramientas solicitó, qué artefactos produjeron esas herramientas, qué memorias se derivaron de esos artefactos, a qué rama y participante pertenecía el estado, qué política permitió u omitió cada registro y qué memorias anteriores estaban desactualizadas, contradichas o sustituidas.
Esas preguntas son las que hacen valioso el enfoque del grafo. Convierte la selección de contexto en una consulta sobre relaciones tipadas en lugar de una estrategia de truncamiento de una lista de mensajes.
En la práctica, el enfoque del grafo tiene tres funciones. Conserva las evidencias manteniendo los artefactos en bruto de herramientas fuera del historial, sujetos a la política de conservación y privacidad. Crea un contexto compacto y utilizable convirtiendo el contenido útil de los artefactos en memorias de herramientas para las llamadas habituales al modelo. Y explica la selección registrando por qué el modelo vio una proyección del grafo en lugar de otra.
El grafo no tiene por qué ser visible para los usuarios. El usuario ve la conversación. El entorno de ejecución usa el grafo para decidir qué debe conocer la siguiente llamada al modelo.
TRADITIONAL TRANSCRIPT REPLAY
- Message
- Message
- Message
- Message
- LARGE PROMPT
Replays old tool calls and results
Includes stale, private, and noisy data
Loses important structure and provenance
Wasteful, expensive, error-prone
POLICY-GOVERNED ASSEMBLY
- RAW ARTIFACTS
- COMPACT MEMORIES
- SELECTED CONTEXT
- MODEL REQUEST
Keeps raw evidence out of the prompt
Includes only relevant, current, and allowed data
Preserves provenance and recovery state
Smaller, faster, safer, and more reliable
4. Patrón de implementación
Esta sección describe la forma concreta del patrón tal como se implementa en NanthAI:Edge. Los detalles son útiles porque muestran qué debe existir cuando el historial deja de ser la fuente de verdad del contexto del modelo.
4.1 Modelo del grafo de ejecución
El grafo de ejecución empieza haciendo explícitas las entidades importantes. Conversation es el contenedor del chat que pertenece al usuario. Branch es una ruta ordenada por ese grafo de conversación que hereda el historial compartido anterior. Participant es la configuración del modelo o perfil Persona activa para una ejecución. Message es el nodo del historial visible para el usuario. ModelRun es un intento de generación dirigido a un proveedor para un participante, mensaje o tarea.
El trabajo de las herramientas recibe su propio vocabulario. ToolCall es la llamada a función solicitada por el modelo, con argumentos e identificador de llamada. ToolArtifact es el registro persistente en bruto de ejecución para esa llamada o resultado. ToolMemory es la memoria compacta dirigida al modelo y derivada de uno o más artefactos. SkillState recoge las skills cargadas, los perfiles activos, las herramientas directas y el estado de integraciones visible para una ejecución. ContinuationCheckpoint almacena el estado de ejecución reanudable entre los límites de las acciones.
La capa de ensamblado también es explícita. ContextAssembly es el registro versionado de la decisión de ensamblado de un prompt dirigido al modelo. PolicyDecision registra decisiones de privacidad, vigencia, recorte, rehidratación, enrutamiento a proveedores o recuperación.
Las relaciones canónicas son directas.
- El contenido del asistente en el historial lo genera un ModelRun concreto.
- Un ModelRun solicita uno o más registros ToolCall.
- Cada ToolCall ejecutado, fallido, pendiente o diferido produce un ToolArtifact persistente.
- De ese artefacto se deriva una ToolMemory, conservando la procedencia hasta las evidencias en bruto.
- Las ramas heredan de ramas anteriores sin copiar todo el estado.
- Un ContextAssembly registra qué memorias se incluyeron y qué artefactos en bruto se rehidrataron.
- Un ContinuationCheckpoint restaura estado de ejecución, no solo mensajes del historial.
- Una PolicyDecision restringe el ensamblado para hacer explícitas las decisiones de privacidad, proveedor, vigencia, recorte y recuperación.
Runtime graph
- Conversation
- Branch
- Participant
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- Participant
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- Participant
- Branch
Tool memories across the active lineage → ContextAssembly → PolicyDecision → Checkpoint
Relationships
Conversation contains / has Branches; Branches inherit from the conversation.
Branches contain Participants; Participants contain Messages; Messages generate ModelRuns.
ModelRun requests ToolCall; ToolCall produces ToolArtifact; ToolMemory is derived from ToolArtifact.
ToolMemory is assembled into ContextAssembly. ContextAssembly is constrained by PolicyDecision. Checkpoint restores state.
Legend: contains / has; inherits from; generates; requests; derived from; assembled into; constrained by; restores.
4.2 Artefactos persistentes de herramientas
Un ToolArtifact es el registro persistente en bruto de la ejecución de una herramienta.
Captura el identificador de llamada a herramienta, el nombre de la herramienta, los argumentos, el resultado o error en bruto, el estado, la titularidad del mensaje y la tarea, la titularidad del participante y la ejecución del modelo, el ámbito de rama, la clasificación de privacidad, las skills y perfiles de herramientas activos, los metadatos del proveedor y del entorno de ejecución, y las referencias de almacenamiento de argumentos o resultados demasiado grandes.
Los resultados de herramientas a nivel de mensaje pueden seguir existiendo para la compatibilidad con los clientes y su presentación. Pueden truncarse, resumirse o adaptarse a la interfaz. Eso está bien para mostrarlos. No basta para flujos prolongados, auditoría, reintentos o rehidratación exacta.
El paso importante es capturar los artefactos completos antes del truncamiento a nivel de mensaje. La interfaz puede seguir siendo compacta mientras el backend conserva evidencias recuperables.
Esto importa cuando un turno posterior necesita el CSV exacto de una llamada anterior, hay que reintentar una llamada fallida, debe continuar un selector diferido, hay que explicar un documento citado, debe conservarse un identificador de archivo generado, hay que auditar la salida de un subagente o unos datos privados de herramienta deben quedar fuera de los contextos de modelos hermanos.
4.3 Memorias de herramientas
Una ToolMemory es un registro compacto dirigido al modelo y derivado de uno o más artefactos.
Las memorias de herramientas son independientes de las memorias del usuario. Las memorias del usuario representan personalización y datos persistentes del usuario. Las memorias de herramientas representan evidencias de ejecución y estado derivado de herramientas.
Las memorias de herramientas incluyen identificadores de artefactos de origen, nombres de herramientas de origen, texto de resumen, datos estructurados, confianza, fuente de confianza, justificación de confianza, notas de ambigüedad y limitaciones, clasificación de privacidad, clase de vigencia, marca temporal de caducidad, herramientas de revalidación, localizadores de procedencia, estado de la última resolución, intentos de reparación, enlaces de contradicción, enlaces de sustitución y política de promoción.
El objetivo no es que el modelo lo recuerde todo. Es que la memoria pueda justificarse. Una memoria compacta debe conservar suficiente procedencia para que el sistema pueda responder más tarde de dónde vino, si sigue siendo válida y si se pueden o deben rehidratar las evidencias exactas en bruto.
- 1. USER REQUEST: User asks a question or gives a task
- 2. MODEL RUN: Model decides to call one or more tools
- 3. TOOL CALL(S): Tool(s) executed with arguments from the model
- 4. TOOL ARTIFACT: Raw result or error captured as durable evidence (artifact)
- 5. TOOL MEMORY: Compact memory derived from artifact(s) with provenance
- 6. CONTEXT ASSEMBLY: Policy selects what to include, what to rehydrate, what to omit, and why
- 7. MODEL REQUEST: Assembled context sent to the model for the next generation
FEEDBACK LOOPS (as needed)
Revalidation · Retries · Continuations · Checkpoints · Branches · Subagent Promotion
Feedback returns to the relevant execution and context stages.
4.4 ContextAssembly
ContextAssembly es el registro como entidad propia de lo que entró en una solicitud concreta al modelo.
Almacena el número de mensajes del enfoque anterior, el número de mensajes ensamblados, la diferencia estimada de tokens, el número de artefactos en bruto, el número de memorias seleccionadas, el número de artefactos rehidratados, la versión de la política, la versión del ensamblador, las referencias seleccionadas del grafo, los resúmenes de omisiones, las decisiones de seguridad y privacidad, el tiempo de consulta al grafo, el tiempo de evaluación de políticas y el tiempo de serialización.
La pregunta de auditoría es:
¿Por qué vio el modelo este contexto?
La respuesta no debería ser «porque estaba en los últimos N mensajes». Debería acercarse más a:
Esta respuesta incluyó ToolMemory_123, derivada de ToolArtifact_88, heredada de la rama activa, visible para este participante y ensamblada bajo la versión 4 de la política, sin rehidratar el artefacto en bruto porque la memoria compacta era suficiente.
O bien:
Esta respuesta omitió unos datos en bruto derivados de Google porque la política de enrutamiento a proveedores y privacidad los clasificó como restringidos, pero incluyó un resumen seguro y una indicación de herramienta de revalidación.
4.5 PolicyDecision
Ensamblar el contexto es evaluar políticas, no solo recortar.
- La política de titularidad pregunta a qué participante o ejecución de modelo pertenece un registro.
- La política de visibilidad decide si es privado del participante, visible en la rama, visible en la conversación o solo para auditoría.
- La política de privacidad determina si los datos pueden enviarse al modelo o proveedor seleccionado.
- La política de vigencia decide si un registro está actualizado, desactualizado, es duradero o necesita revalidación.
- La política de promoción decide si un artefacto debe convertirse en memoria dirigida al modelo.
- La política de rehidratación decide si basta con la memoria compacta o se requieren las evidencias exactas en bruto.
- Las políticas de contradicción y sustitución resuelven conflictos y reemplazos.
- La política de recuperación protege el estado sin resolver, fallido, diferido o crucial para reintentar.
- La política de conservación decide si el registro debe conservarse, recortarse, archivarse o eliminarse.
La implementación registra resúmenes compactos de políticas y recuentos de omisiones, en lugar de trazas detalladas por registro para cada ensamblado en producción. Las trazas detalladas siguen disponibles en pruebas y auditorías específicas.
| Scenario | Policy Decision | Action | In Context? | Why |
|---|---|---|---|---|
| Google Gmail body (ZDR provider) | Privacy / Provider Restriction | Omit raw body, include safe summary + revalidation tool | Partial | Provider cannot receive Google content |
| Slack thread summary (2 weeks old) | Freshness (Bounded) | Include as stale marker + revalidation tool | Stale | May be outdated, needs recheck |
| Generated CSV file handle | Durability (Session) | Include compact memory (file ID, schema) | Yes | Still valid in session, low risk |
| Sibling branch analysis result | Branch Visibility (Branch-Private) | Omit from active branch context | No | Different branch, not relevant |
| Failed tool call (retry needed) | Recovery (Protected) | Include error + retry state | Yes | Required for recovery |
Every inclusion or omission is logged with policy version, reason, and scope.
4.6 Clases de contexto
El contexto se clasifica según cómo deba recortarse, conservarse, resumirse, rehidratarse y exponerse.
- El contexto de conversación incluye el texto del usuario y del asistente o la discusión local de una rama, y admite ventanas y resúmenes.
- El contexto operativo incluye argumentos y resultados de herramientas, rutas del espacio de trabajo e identificadores de archivos generados; debe conservarse como artefactos antes de resumirse.
- El contexto epistémico incluye afirmaciones, conclusiones y datos extraídos, y corresponde a la memoria de herramientas con metadatos de confianza y vigencia.
- El contexto de procedencia incluye identificadores de artefactos, identificadores de documentos y citas, y debe conservarse para auditoría o rehidratarse cuando las afirmaciones dependan de él.
- El contexto de políticas incluye restricciones del proveedor, el alcance de OAuth y los derechos de acceso, y debe aplicarse antes del ensamblado.
- El contexto de recuperación incluye errores, estado diferido y contratos de reintento, y no debe recortarse mientras siga sin resolverse.
- El contexto de planificación incluye las skills cargadas, los perfiles activos y la descomposición de tareas para la ejecución o continuación actual.
Esto evita que la antigüedad del mensaje se convierta en la única regla de recorte.
4.7 Vigencia y desactualización
Las memorias de herramientas no deben convertirse silenciosamente en verdades eternas. Cada memoria de herramienta recibe una clase de vigencia:
- Las memorias volátiles cubren cosas como recuentos de elementos sin leer, disponibilidad y clasificación de resultados de búsqueda.
- Las memorias de sesión cubren archivos temporales de ejecución, directorios de trabajo y estado provisional.
- Las memorias acotadas cubren instantáneas como registros de CRM, resúmenes de hilos de Slack o el estado de páginas de Notion.
- Las memorias duraderas cubren metadatos de archivos generados, citas de documentos e identificadores explícitos de entidades del proveedor.
- Las memorias permanentes cubren identificadores inmutables de versiones de documentos o identidades de artefactos de almacenamiento generados.
El ensamblador no introduce por defecto memorias volátiles o acotadas desactualizadas como datos actuales. Puede incluirlas como contexto desactualizado, ofrecer una vía de revalidación, omitirlas o seleccionar la rehidratación en bruto cuando se requieren y se permiten evidencias exactas.
4.8 Contradicción y sustitución
Este enfoque evita, cuando es posible, una memoria en la que gana la última escritura.
Las memorias de herramientas pueden entrar en conflicto. Una rama puede analizar el borrador de un documento y producir una conclusión. Otra puede analizar una versión posterior. Una consulta a un proveedor puede indicar una plantilla de una empresa que otra consulta posterior contradice. Un modelo puede resumir mal una fuente mientras otro extrae el valor exacto del archivo en bruto.
El entorno de ejecución registra enlaces de conflicto, enlaces de sustitución, confianza, fuente de confianza, artefactos de origen, limitaciones y notas de ambigüedad. Los campos importantes tienen dirección: conflictsWith marca un desacuerdo, supersedes significa que la memoria actual sustituye a memorias anteriores y supersededBy apunta desde una memoria obsoleta hacia su sustituta.
La política es conservadora. Las memorias en conflicto siguen siendo registros separados. Las memorias sustituidas se omiten normalmente del contexto actual del modelo, mientras que su sustituta actual sigue pudiendo seleccionarse. Pueden incluirse ambos lados de una contradicción cuando importa la incertidumbre. La resolución requiere procedencia y confianza, no solo que algo sea más reciente.
Un detalle práctico importa: supersedes debe significar «esta memoria actual sustituye a memorias anteriores». La dirección opuesta debe usar un campo separado como supersededBy.
Parece un detalle menor, pero la ambigüedad aquí puede provocar errores reales. Un ensamblador que descarte la memoria sustituta en lugar de la obsoleta puede hacer que el modelo razone a partir de un estado desactualizado creyendo que está siendo cuidadoso.
4.9 Titularidad de participantes y del estado de ejecución
NanthAI:Edge admite ejecuciones multimodelo, discusiones autónomas, subagentes, ramas, tareas programadas y continuaciones con muchas herramientas. Eso hace importante la titularidad.
Un mensaje visible del asistente puede convertirse en contexto compartido de la conversación.
Pero el estado de ejecución en bruto no debe compartirse automáticamente solo porque se produjo durante el mismo chat.
En esta arquitectura, los artefactos de herramientas, sus memorias, los ensamblados del contexto y los puntos de control de continuación llevan metadatos de titularidad como visibilityScope, ownerParticipantId, ownerModelRunId, sharedWithParticipants, runtimeIsolationPolicy y runtimeKind.
La política predeterminada establece que el estado de una ejecución del modelo está delimitado por participante y aislado. La salida del asistente visible para el usuario puede convertirse en contexto de rama o conversación después de finalizarse. El estado provisional privado no se filtra a los participantes hermanos. Las llamadas a herramientas sin resolver siguen siendo visibles para el participante titular y las continuaciones necesarias. Los artefactos de subagentes hijos permanecen privados o solo para auditoría hasta que se promueven explícitamente.
Esta es una de las partes menos documentadas de la arquitectura de agentes.
Muchos ejemplos de sistemas multiagente hablan de colaboración. Menos definen la frontera entre lo que un modelo dijo de forma visible, lo que vio en privado, lo que devolvieron sus herramientas, lo que descubrió un subagente hijo, lo que puede usar el padre más adelante y lo que queda solo para auditoría.
Esta arquitectura hace explícita esa frontera.
4.10 Ensamblado del grafo consciente de las ramas
Las conversaciones de NanthAI pueden ramificarse. Eso significa que el ensamblado del contexto no puede limitarse a «obtener memorias recientes por identificador de chat». Si dos ramas producen distintos identificadores de documentos, archivos generados o resultados de análisis, la rama activa no debe contaminarse con artefactos más recientes de ramas hermanas.
La solución es hacer que el ensamblado tenga en cuenta las ramas. Los candidatos se seleccionan primero del linaje de la rama activa. Los registros compartidos explícitamente o con alcance de conversación pueden seguir ocupando los huecos restantes, pero el estado privado de ramas hermanas no desplaza al contexto de la rama activa.
Los registros de ensamblado recogen las exclusiones por rama por separado de las omisiones normales por presupuesto de contexto. Esto importa porque los errores de ramas son sutiles. El modelo puede responder con seguridad con un archivo, una cita o un identificador de documento que pertenece a otra rama. La interfaz parecerá correcta. El historial parecerá plausible. Pero el entorno de ejecución habrá mezclado dos rutas incompatibles.
El ensamblado consciente de las ramas trata la conversación como un grafo, no como una lista plana de mensajes.
BROKEN: TRANSCRIPT REPLAY (BRANCH POLLUTION)
- Root conversation → Branch Point (User question)
- Branch A (Active) → Generates File_A.csv
- Branch B (Sibling) → Generates File_B.csv
- Active Branch A – Next Call Context: Root conversation; Branch A messages; File_A.csv (correct); Branch B messages (leaked); File_B.csv (incorrectly included)
Linear transcripts can leak sibling branch artifacts into the active branch.
POLLUTION EXAMPLE: When Branch A asks a follow-up, transcript replay includes everything in the history — including artifacts from Branch B.
Result: Sibling branch contamination, higher token cost, and incorrect or confusing model context.
CORRECT: BRANCH-AWARE ASSEMBLY
- Root conversation → Branch Point (User question)
- Branch A (Active) → File_A.csv
- Branch B (Sibling) → File_B.csv (Private to B); Explicit Share (Optional) → Branch A
- Active Branch A – Next Call Context: Root conversation; Branch A messages; File_A.csv (correct); Shared from B (if any); Branch B private items (excluded)
Assembler selects only active lineage and explicitly shared records.
ASSEMBLY RULES (Examples): Include active lineage only; Include explicitly shared records; Respect branch-private boundaries; Apply policy and freshness rules; Avoid sibling branch leakage.
Result: Clean, relevant context. Lower token cost. No branch leakage. Policy-governed and auditable.
Legend: Active Branch; Sibling Branch; Branch Point; Message; Artifact / Generated File; Explicitly Shared; Branch-Private (Not Visible); Active Lineage; Sibling Lineage; Explicit Share; Leak / Pollution (Bad).
4.11 Rehidratación en bruto
La memoria compacta suele bastar. A veces no. Si el usuario pide «usa el CSV exacto de antes», un resumen no es suficiente. El entorno de ejecución necesita recuperar el artefacto en bruto.
La arquitectura admite una rehidratación en bruto acotada. La palabra importante es acotada. Los artefactos en bruto respaldados por almacenamiento solo se rehidratan después de la selección por políticas, no por adelantado.
El ensamblador comprueba si se necesita el detalle exacto, si el artefacto fue seleccionado, si la clasificación de privacidad está permitida, si el presupuesto de bytes es aceptable, si la ruta al proveedor está permitida y si el registro está sin resolver o es crucial para la recuperación.
- Si es así, puede incluirse el artefacto en bruto.
- Si no, el ensamblador puede incluir una memoria compacta, una referencia, una marca de desactualización, una indicación de revalidación o nada.
Esto evita dos extremos negativos: reproducir eternamente los datos en bruto de las herramientas y resumir hasta perder evidencias que los turnos posteriores necesitan de forma exacta.
POLICY-GOVERNED ASSEMBLY
- RAW ARTIFACTS
- COMPACT MEMORIES
- SELECTED CONTEXT
- MODEL REQUEST
Keeps raw evidence out of the prompt
Includes only relevant, current, and allowed data
Preserves provenance and recovery state
Smaller, faster, safer, and more reliable
4.12 La cognición del entorno de ejecución no es la experiencia de usuario
Esta arquitectura añade mucho estado interno de ejecución. Ese estado no pertenece automáticamente a la interfaz del chat. Las memorias de herramientas, los ensamblados del contexto, las decisiones de políticas, los registros de reparación de procedencia, los recuentos de omisiones y las trazas de consultas al grafo son cognición del entorno de ejecución.
No deben convertirse en texto de la conversación salvo que el usuario pida una explicación de auditoría o depuración, o abra un inspector destinado a ello.
Esta separación es importante. Muchos productos de IA la difuminan. El asistente empieza a narrar en la conversación su memoria, sus políticas, su estado interno y la gestión de sus herramientas.
Eso hace que el historial tenga más ruido y, a menudo, sea menos fiable. En NanthAI:Edge, el historial dirigido al usuario sigue siendo la superficie del producto. El grafo de ejecución sigue siendo la superficie de ejecución.
La procedencia puede aparecer mediante citas, tarjetas de archivos generados, vistas de depuración o un futuro inspector de «¿por qué dijo esto el modelo?».
Pero el entorno de ejecución no debe reescribir el historial de conversación para explicarse a sí mismo.
4.13 Límites entre modos de ejecución
Los distintos modos de ejecución necesitan reglas de ensamblado distintas. El chat normal y el multimodelo usan un contexto ensamblado consciente de las ramas para el participante activo. La discusión autónoma conserva la forma del prompt de debate, las directrices del moderador, las etiquetas de los interlocutores y el contenido no textual compatible, y añade contexto ensamblado visible para el participante. Una ejecución de subagente hijo captura artefactos y memorias de herramientas locales del hijo, con titularidad del hijo, privados o solo para auditoría por defecto. Una reanudación del padre tras los subagentes mantiene su punto de control determinista, adjunta las referencias de ensamblado seleccionadas y registra la decisión de restauración en lugar de consultar a ciegas el historial. Las tareas programadas usan la ruta normal de generación del backend, donde la tarea crea turnos de chat y los dirige a generación. Los envíos en ramas de Ideascape usan la misma ruta de generación consciente de las ramas después de que el cliente envíe identificadores explícitos de los padres.
Este fue un paso de cierre importante porque los errores de contexto más difíciles suelen estar en los límites de la orquestación. Un turno normal de chat puede usar directamente la rama y el participante activos. Una reanudación del padre después de los subagentes es distinta: el padre debe recibir resúmenes de hijos promovidos, referencias a archivos generados, estados de hijos fallidos y estado pertinente para reintentar, pero no los datos en bruto del espacio de trabajo de los hijos salvo que se hayan promovido explícitamente.
Esto requiere metadatos como el tipo de entorno de ejecución, los identificadores de lote y ejecución de subagentes, los identificadores de mensaje y tarea del padre, los identificadores de llamadas a herramientas del padre y las decisiones de promoción cuando sean necesarias. La finalidad no es crear más esquemas porque sí. Es poder representar las decisiones de titularidad y promoción antes de que el ensamblador serialice nada en una solicitud al proveedor.
4.14 Límites de promoción de subagentes
Los subagentes hacen concreta la separación entre historial y contexto.
Un subagente hijo puede llamar a herramientas, leer documentos, generar archivos intermedios, encontrar errores y mantener un estado provisional privado. Puede que el padre solo necesite el informe final del hijo, una referencia a un archivo generado, un resumen compacto de errores o el estado de un lote. Si el entorno de ejecución almacena el estado del hijo solo como mensajes con forma de historial, resulta tentador reproducir demasiado en el padre. Si descarta ese estado después de resumirlo, la auditoría y la recuperación se resienten.
El entorno de ejecución usa una semántica de promoción. Los argumentos y resultados en bruto de herramientas del hijo son privados del hijo o solo para auditoría por defecto. Las referencias a archivos generados se hacen visibles para el padre después de la promoción del hijo al alcanzar un estado terminal. El informe final del hijo es visible en la reanudación del padre. El estado de un hijo fallido o que agotó el tiempo puede promoverse como contexto compacto de recuperación. Los detalles provisionales o del espacio de trabajo del hijo no son visibles para el padre salvo promoción explícita.
Esto da al padre suficiente contexto para continuar sin convertir cada ejecución de un hijo en una carga de historial en bruto.
Parent Agent (Orchestrator) — Before Subagent Call
- User request: “Research ACME Corp and prepare a report.”
- Subagent Call: Task scope, inputs, and constraints
Parent State (continues): Conversation history; Long-term memories; Policy & preferences; Runtime checkpoints
Child Subagent (Isolated Runtime) — Owns private runtime state and working context
Does Private Work: Tool Calls — Executes tools and external API calls; Raw Tool Payloads — Full results, responses, files, logs (verbose); Scratch / Intermediate State — Notes, reasoning, partial results, drafts, retries; Temporary Artifacts — Working files, temp exports, debug data.
Private to Subagent: Not visible to parent.
Produces Outputs: Final Report / Answer — Curated, high-quality result for the parent; Generated File Handle — Compact reference (file ID, schema, hash, storage pointer); Compact Memories — Summaries with provenance, TTL, and freshness; Audit Trail (Optional) — Tool call list, key decisions, policy summary (not raw data).
Isolation Boundary: Subagent state is not accessible to the parent at any time.
Promotion Gate
Policy-driven promotion of explicit outputs only. Everything else stays private.
Parent Resumes (after subagent completion)
- Receives Promoted Outputs Only: Final Report / Answer; Generated File Handle; Compact Memories; Audit Trail (if provided)
- Parent State (updated): Adds promoted memories; Stores file handle reference; Records audit summary; Continues conversation
- Next Steps: Parent decides what to do next (e.g., follow-up questions, new tasks, branch, or additional subagents).
What gets promoted?
Final Report / Answer: Curated output intended for the parent.
Generated File Handle: Stable reference to large or expensive artifacts.
Compact Memories: Bounded, policy-checked context for future turns.
Audit Trail (Optional): High-level trace for accountability (no raw data unless allowed).
What stays private?
Raw tool payloads
Scratch / intermediate state
Temporary artifacts
All internal tool activity
Only promoted outputs cross the boundary.
Isolation Guarantees
No raw data leakage: Parent never sees raw tool payloads or scratch state.
Least-privilege promotion: Only explicit, policy-approved outputs are shared.
Bounded lifetime: Subagent state is discarded after completion.
Clean parent context: Parent resumes with only promoted, relevant context.
Auditability preserved: Policy decisions and summaries are recorded for traceability.
4.15 Conservación y recolección de basura
Los artefactos persistentes crean una responsabilidad de almacenamiento. La arquitectura no implica «guardarlo todo para siempre». Implica que la conservación se hace explícita.
El modelo de conservación debe equilibrar la capacidad de auditoría y la privacidad. Los artefactos en bruto pueden conservarse, archivarse, censurarse, reducirse a hashes, almacenarse aparte o eliminarse según las políticas. Los contextAssemblyLogs muestreados deben recortarse de forma agresiva. El borrado de cuenta debe limpiar artefactos, memorias y registros de ensamblado. Los artefactos solo para auditoría deben permanecer fuera del contexto normal del modelo. Los datos respaldados por almacenamiento solo deben rehidratarse tras comprobar la privacidad y el presupuesto de bytes. Las referencias a archivos generados y documentos necesitan una limpieza que preserve las referencias para que no se rompan las citas activas ni las referencias a archivos.
Esta es una de las razones por las que la arquitectura está más justificada para el trabajo exigente con herramientas.
Conservar evidencias en bruto mejora la recuperación y la auditoría, pero también aumenta las obligaciones de clasificación, cifrado, control de acceso, eliminación y rigor en el enrutamiento a proveedores.
5. Análisis de la arquitectura
5.1 Modelo de coste en tokens
Al reproducir el historial, el coste expuesto al modelo de una conversación con muchas herramientas se aproxima a:
conversation_window + historical_tool_calls + historical_tool_results + summaries + retry_state
Con el ensamblado del contexto basado en grafos, el coste se aproxima a:
conversation_window + selected_tool_memories + protected_recovery_state + selected_skill_state + optional_raw_rehydration
La distinción crucial es qué crece con el volumen histórico de herramientas. Al reproducir el historial, los datos antiguos de herramientas pueden seguir en la ruta de reproducción hasta que se recortan o resumen. En esta arquitectura, los artefactos en bruto se conservan por separado y solo entran en el contexto del modelo las memorias compactas, el estado sin resolver protegido o las evidencias rehidratadas explícitamente.
Ese es el núcleo económico de la arquitectura.
5.2 Artefactos en bruto frente a memorias compactas
La separación entre artefactos en bruto y memorias crea dos capas. La capa de evidencias contiene argumentos completos, salidas en bruto, errores, hashes, referencias de almacenamiento, procedencia y metadatos de ejecución. La capa de contexto contiene resúmenes compactos, datos estructurados, referencias a archivos generados, marcas de desactualización, metadatos de confianza e indicaciones de revalidación.
Esto permite reducir el tamaño del contexto sin perder capacidad de auditoría. Un resumen puede ser económico y útil, pero no debe ser el único registro que sobreviva.
5.3 ContextAssembly como frontera de caché y auditoría
El ensamblado del contexto crea una frontera estable entre el estado almacenado y la serialización de las solicitudes al proveedor. El entorno puede cambiar cómo serializa los mensajes, pero el registro de ensamblado sigue recogiendo qué referencias del grafo se seleccionaron y qué versión de política las seleccionó.
La arquitectura busca reproducibilidad con versiones de políticas, no una reproducción eternamente idéntica byte a byte. Esto significa que la misma versión de política sobre la misma instantánea del grafo debe seleccionar el mismo conjunto de artefactos, memorias, estado en bruto protegido y decisiones de políticas. No garantiza una tokenización idéntica ni una salida idéntica del modelo en vivo con proveedores no deterministas.
5.4 Contexto delimitado por participante
En el chat multimodelo, compartir el historial y compartir el estado de ejecución son cosas distintas.
Si dos modelos responden al mismo prompt del usuario, este puede ver ambos resultados finales juntos. Eso no significa que el espacio de trabajo provisional privado del modelo A, sus errores de herramientas o sus datos en bruto derivados de OAuth deban ser visibles para el modelo B.
La arquitectura hace explícita esta distinción mediante el ámbito de visibilidad y la política de aislamiento del estado de ejecución.
Esto supone una ventaja considerable para la evaluación. Los fallos pueden descomponerse por capas: si el registro era visible en la rama, privado del participante, solo para auditoría, promovido, desactualizado, omitido por la política de proveedor y privacidad, o rehidratado porque se requerían evidencias exactas.
5.5 El ensamblado del contexto como consulta al grafo
La arquitectura plantea el ensamblado del contexto como una consulta al grafo sobre entidades de ejecución, restringida por el linaje de la rama activa, la visibilidad del participante, el aislamiento de ejecución, la clasificación de privacidad, la política de promoción, la política de vigencia, la procedencia de la confianza, la contradicción y sustitución, el estado de continuación, la protección de reintentos y recuperación, el presupuesto de contexto y los límites de rehidratación en bruto.
Por eso «GraphRAG» no es el marco principal adecuado. GraphRAG suele ser recuperación sobre conocimiento de dominio o relaciones entre documentos. El grafo del entorno de ejecución incluye estado de ejecución, políticas, participantes, ramas, artefactos, memorias y ensamblados del contexto.
El grafo de ejecución es más amplio que un grafo de conocimiento.
5.6 Determinismo y reproducibilidad
La arquitectura busca reproducibilidad con versiones de políticas, no una reproducción de prompts eternamente idéntica byte a byte.
Esa distinción es importante. El SDK de un proveedor puede cambiar la serialización. El enrutamiento de OpenRouter puede cambiar el modelo que hay detrás de una ruta automática. La tokenización puede variar entre proveedores. Una llamada a un modelo en vivo puede ser no determinista aunque la entrada sea idéntica.
El objetivo de reproducibilidad es más acotado y útil. La misma versión de política sobre la misma instantánea del grafo debe seleccionar el mismo conjunto de artefactos, memorias, estado en bruto protegido y decisiones de políticas. Las decisiones de privacidad, enrutamiento a proveedores, ámbito de rama, reintento y continuación deben poder explicarse a partir del estado almacenado. Un ensamblado anterior debe poder reconstruirse en lo sustancial para flujos de auditoría y depuración. Los cambios inocuos de formato no deben destruir la capacidad de auditoría semántica.
Por eso importan policyVersion, assemblerVersion, las referencias seleccionadas, los resúmenes de omisiones y los campos de tiempos. Definen la frontera entre el estado de ejecución y la serialización de mensajes para el proveedor.
5.7 Por qué no se trata solo de un contexto mayor
Las ventanas de contexto grandes ayudan, pero no resuelven el problema de arquitectura.
Una ventana mayor puede contener más evidencias desactualizadas, más estado provisional privado, más ruido de ramas hermanas, más errores antiguos de herramientas y más datos en bruto derivados de OAuth. Puede retrasar el momento en que el recorte se hace visible, pero no decide qué merece incluirse.
La arquitectura no es un argumento contra los modelos de contexto grande. Defiende que las ventanas de contexto deben llenarse de forma deliberada. El ensamblador puede seguir usando una ventana grande cuando la tarea lo necesita. La diferencia es que los artefactos en bruto, las memorias compactas, el estado de recuperación y las restricciones de políticas compiten mediante reglas explícitas en lugar de sobrevivir por cronología.
6. Comparación con trabajos previos
La arquitectura se sitúa en una sólida tradición de trabajos sobre ingeniería de contexto, entornos de ejecución basados en grafos, memoria, procedencia y auditoría.
- La ingeniería de contexto es ya un concepto habitual en el diseño de agentes. Anthropic, Haystack, Atlan y otros han defendido que el contexto del modelo debe ensamblarse explícitamente a partir de instrucciones, historial, datos recuperados, herramientas, memoria y estado de tareas, en lugar de tratarse como una cadena de texto de prompt.
- LangGraph ofrece precedentes sólidos de estado en grafos, hilos, puntos de control, instantáneas, reproducción y patrones de ejecución duradera.
- Los sistemas de memoria de agentes distinguen memoria a corto plazo, a largo plazo, episódica, semántica, procedimental y de trabajo.
- MCP y los marcos de uso de herramientas hacen explícitas las herramientas y permiten registrarlas.
- La literatura sobre registro de eventos como fuente de estado y trazas de auditoría respalda los registros de ejecución a los que solo se añade contenido y los historiales reconstruibles.
- La investigación sobre memoria consciente de la procedencia, incluidos sistemas como MemORAI y Portable Agent Memory, apunta a memorias vinculadas a sus fuentes.
- Los trabajos de seguridad sobre inyección de prompts, envenenamiento de memoria, filtraciones entre sesiones y seguridad de herramientas consciente de la procedencia respaldan límites de políticas más estrictos.
La contribución de NanthAI es integrar estos patrones convergentes en un contrato único del entorno de ejecución: artefactos persistentes de herramientas, memorias compactas de herramientas, procedencia, titularidad de participantes, ensamblado del grafo consciente de las ramas, decisiones de políticas y separación entre historial y contexto.
La integración es la clave. Convierte un conjunto de técnicas útiles en un modelo riguroso de ejecución para agentes que usan muchas herramientas.
6.1 Qué parece ya habitual
Varias ideas ya son habituales o casi: memoria a corto y largo plazo, compactar contexto antiguo, usar salidas de herramientas en turnos posteriores, guardar puntos de control del estado del agente, tratar como potencialmente no fiable el contenido recuperado, el de herramientas y el de usuarios, gestionar explícitamente el contexto del modelo en lugar de limitarse a escribir prompts y almacenar registros para depuración y observabilidad.
6.2 Qué parece emergente
Otras ideas son visibles en la literatura y en marcos sólidos, pero no están consolidadas: memoria de agentes consciente de la procedencia, detección de memorias desactualizadas, manejo de contradicciones y sustituciones, objetos de memoria portables, rehidratación de artefactos en bruto a partir de memorias compactas, almacenes de estado propios para restricciones de retención cero del proveedor, ensamblado del contexto regido por políticas y memoria como superficie de ataque.
La arquitectura está alineada con esta dirección, pero da a estas ideas un contrato concreto dentro del entorno de ejecución del producto.
6.3 Qué parece poco documentado
Las ideas más interesantes son más concretas: ContextAssembly como registro persistente con entidad propia, PolicyDecision vinculado a cada generación, ToolArtifact persistente en bruto separado de ToolMemory compacta, estado de ejecución privado por participante en el chat multimodelo, artefactos de subagentes hijos que permanecen privados hasta su promoción, ensamblado del contexto consciente de las ramas sobre el linaje de conversación, semántica de promoción entre observación y memoria, y cognición del entorno de ejecución separada del historial del usuario.
Aquí es donde creo que la arquitectura resulta más útil. No porque cada campo sea sorprendente por separado. Porque la combinación da al entorno de ejecución un vocabulario para decisiones que, de otro modo, quedan implícitas.
6.4 Precedentes más cercanos
El precedente más cercano entre los marcos es LangGraph: el estado en grafos, los hilos, los puntos de control, la reproducción, el viaje en el tiempo y los patrones de ejecución duradera están muy alineados con la dirección del entorno de ejecución. La diferencia es el alcance. La arquitectura no consiste solo en ejecución en grafos. Convierte los artefactos de herramientas, las memorias compactas, la visibilidad de participantes, el linaje de ramas, los ensamblados del contexto y las decisiones de políticas en registros con entidad propia.
Portable Agent Memory y MemORAI son cercanos en la procedencia de la memoria. Respaldan la idea de que las memorias deben llevar enlaces a sus fuentes y metadatos de integridad. La arquitectura aplica esa lógica a los artefactos de herramientas y al contexto de generación, no solo a objetos de memoria portables.
Los trabajos de registro de eventos como fuente de estado son cercanos en auditoría y reproducción. Respaldan los historiales de eventos a los que solo se añade contenido y la ejecución reconstruible. La arquitectura necesita ese historial temporal, pero también relaciones de grafo entre ramas, participantes, artefactos, memorias y políticas.
ARGUS y los trabajos relacionados de seguridad consciente de la procedencia son cercanos en el aspecto de seguridad. Tratan las decisiones de herramientas como influidas por el contexto previo y usan la procedencia para razonar sobre acciones inseguras. La arquitectura generaliza esa intuición: la procedencia debe influir no solo en las comprobaciones de seguridad, sino también en la inclusión habitual de contexto, la rehidratación, el manejo de contradicciones y la auditoría.
MCP es pertinente porque hace explícitas las llamadas a herramientas y las fuentes de contexto. Pero MCP es un protocolo de integración, no una política de conservación, procedencia, ramas, participantes o ensamblado del contexto.
6.5 ZDR y estado propio
La retención cero de datos y las restricciones de no retención del proveedor hacen más importante la separación entre historial y contexto.
Si la persistencia del lado del proveedor no está disponible o no es deseable, el responsable de la aplicación sigue necesitando registros internos de auditoría, estado de recuperación, referencias a archivos generados, procedencia de llamadas a herramientas, decisiones de visibilidad de participantes, políticas de eliminación y conservación, y una forma de reconstruir lo que vio el modelo.
Eso devuelve la responsabilidad del estado al entorno de ejecución del producto. El proveedor se convierte en un punto de ejecución. La aplicación asume la responsabilidad de decidir qué conservar, qué datos ocultar, qué omitir y qué enviar en cada solicitud.
La arquitectura encaja con ese modelo. No depende de los hilos gestionados por el proveedor como fuente persistente de verdad. El backend mantiene su propio estado del grafo y ensambla las solicitudes al proveedor a partir de ese estado.
7. Complejidad de las políticas y cómo gestionarla
El principal reto de ingeniería es que el ensamblado regido por políticas introduce una capa de decisiones que debe diseñarse, probarse y observarse.
La reproducción del historial es fácil de entender. Si el mensaje está en la ventana, el modelo lo ve. Si se ha recortado, no lo ve.
El ensamblado del contexto regido por políticas es más potente y esa potencia necesita controles. La capa de políticas debe evitar la omisión de evidencias útiles, la inclusión de memorias desactualizadas, las filtraciones de estado privado, la ocultación de errores cruciales para reintentar, la rehidratación excesiva en bruto, la recuperación insuficiente de evidencias exactas, los errores de linaje de ramas, la confianza excesiva en resúmenes derivados del modelo, la latencia excesiva de consultas al grafo y una capacidad de auditoría superficial.
Esta es la disyuntiva central. La arquitectura intercambia la herencia accidental del historial por políticas explícitas. Eso solo es mejor si las políticas son comprobables, observables y acotadas.
La arquitectura es más sólida cuando los flujos de herramientas son prolongados o tienen muchos artefactos, importan las evidencias en bruto de herramientas, importan las restricciones de privacidad o proveedor, son habituales las ramas, los subagentes o las ejecuciones multimodelo, los datos desactualizados pueden causar errores reales, la capacidad de auditoría es valiosa y el coste del contexto importa.
Es menos relevante cuando los chats son cortos, las herramientas son poco frecuentes, las salidas no necesitan auditoría, todo el estado se puede compartir de forma segura, nunca se requieren más tarde evidencias exactas o los recursos de ingeniería no permiten mantener pruebas de políticas y telemetría.
Para un chatbot sencillo, reproducir el historial puede bastar. Para un espacio de trabajo con agentes que usan muchas herramientas, la complejidad ya existe. La arquitectura la hace explícita y comprobable.
8. Riesgos y modos de fallo
R1: Errores en las políticas
El ensamblador puede omitir evidencias necesarias o incluir contexto prohibido.
Mitigaciones: pruebas deterministas de escenarios, resúmenes de omisiones, control de versiones de políticas, valoración del antes y el después, y registros de ensamblado muestreados.
R2: Crecimiento del almacenamiento
Los artefactos en bruto pueden crecer rápidamente, especialmente con archivos, datos de API, stdout/stderr y salidas generadas.
Mitigaciones: clases de conservación, elegibilidad para la recolección de basura, limpieza al borrar cuentas, referencias de almacenamiento, hashes y políticas de conservación solo para auditoría.
R3: Filtraciones de privacidad y hacia proveedores
Los artefactos almacenados pueden contener datos derivados de OAuth, datos de Google, datos de documentos, archivos de ejecución o datos cercanos a secretos.
Mitigaciones: clasificación de privacidad, política de enrutamiento a proveedores, controles de rehidratación en bruto, resúmenes solo de metadatos y omisión con cierre seguro ante fallos (fail-closed).
R4: Falsa confianza en memorias compactas
Los resúmenes pueden ser incorrectos, estar desactualizados o incompletos.
Mitigaciones: fuente de confianza, localizadores de procedencia, clase de vigencia, enlaces de contradicción, limitaciones y vías de rehidratación en bruto.
R5: Memoria desactualizada
El modelo puede basarse en observaciones externas antiguas como si fueran verdad actual.
Mitigaciones: observedAt, staleAfter, clase de vigencia, herramientas de revalidación, marcas de desactualización y política de omisión.
R6: Contaminación entre ramas
Los artefactos de ramas hermanas pueden desplazar el estado de la rama activa.
Mitigaciones: consulta al linaje de la rama activa, visibilidad explícita de conversación o compartida, y telemetría de exclusiones por rama.
R7: Filtraciones entre participantes
Un participante modelo puede ver el estado privado de herramientas de otro participante.
Mitigaciones: identificadores del participante titular, identificadores de la ejecución del modelo titular, ámbito de visibilidad, política de aislamiento de ejecución, listas de destinatarios con los que se comparte y decisiones de promoción.
R8: Aumento progresivo de la latencia
Las consultas al grafo, la reparación de procedencia y la rehidratación desde almacenamiento pueden resultar costosas.
Mitigaciones: conjuntos de candidatos acotados, rehidratación en dos fases tras la selección por políticas, telemetría de tiempos, límites de intentos de reparación y controles de latencia.
R9: Afirmaciones exageradas sobre la durabilidad
Los artefactos y los puntos de control ayudan a recuperar y auditar, pero no equivalen a una ejecución duradera distribuida completa.
Mitigaciones: lenguaje preciso, idempotencia donde haga falta, puntos de control de continuación, contratos de reintento y orquestación externa para garantías más fuertes del flujo de trabajo.
R10: Capacidad de depurar las omisiones
El modelo puede fallar porque se omitió un estado pertinente, no porque se incluyera un estado incorrecto.
Mitigaciones: recuentos de motivos de exclusión, trazas detalladas deterministas, telemetría de exclusiones por rama, registros de ensamblado muestreados y consultas de auditoría y depuración que puedan inspeccionar tanto candidatos como registros seleccionados.
R11: Desajuste de la promoción
La lógica de extracción puede promover demasiado contenido a memoria persistente o demasiado poco a memoria visible para el modelo.
Mitigaciones: promotionPolicy explícita, pruebas del extractor, procedencia de la confianza, reglas de reducción de la clasificación de privacidad y recuperación de artefactos en bruto cuando no se promovió una memoria.
R12: Abuso de la rehidratación
La rehidratación en bruto puede convertirse en una vía oculta por la que datos grandes o sensibles entren en el contexto del proveedor.
Mitigaciones: selección en dos fases, comprobaciones de privacidad antes de leer el almacenamiento, presupuestos de bytes, controles de enrutamiento a proveedores y omisión con cierre seguro ante fallos (fail-closed) para datos de OAuth, Google o cercanos a secretos.
9. Mediciones de implementación
Aunque la validación completa del comportamiento requiere evaluaciones más amplias, algunas afirmaciones se pueden evaluar directamente a partir de la implementación actual de NanthAI:Edge. En concreto, el código permite comparar el contexto del enfoque anterior de reproducción del historial con un contexto ensamblado del grafo para escenarios fijos con muchas herramientas.
Estas mediciones cuantifican la vertiente de economía del contexto del argumento: cuánto contenido de prompt expuesto al modelo se evita cuando los datos antiguos de herramientas se sustituyen por memorias compactas, contexto seleccionado del grafo, filtrado de privacidad y titularidad, y estado en bruto sin resolver protegido.
La comparación fue sencilla. La pasada del enfoque anterior usó la reproducción del historial y de los mensajes de herramientas con el ruido de los datos en bruto de herramientas. La pasada ensamblada usó memoria compacta de herramientas, contexto seleccionado del grafo, filtrado de privacidad y titularidad, y estado en bruto sin resolver de herramientas protegido.
Son mediciones de implementación, no una evaluación pública ni una afirmación de mejora universal del éxito en las tareas.
9.1 Reducción del contexto del prompt
Las diferencias de tokens del prompt fueron claramente negativas en los escenarios comparativos en vivo probados.
- El contexto del selector de documentos diferido bajó de 1020 a 142 tokens, una reducción del 86,1 %.
- La generación de archivos con varias herramientas bajó de 1905 a 221 tokens, una reducción del 88,4 %.
- La memoria desactualizada de aplicaciones conectadas bajó de 1051 a 145 tokens, una reducción del 86,2 %.
- El estado de ejecución con varias skills bajó de 1008 a 179 tokens, una reducción del 82,2 %.
- La visibilidad de participantes bajó de 961 a 161 tokens, una reducción del 83,2 %.
- La contradicción y sustitución bajó de 1986 a 197 tokens, una reducción del 90,1 %.
Esto respalda la primera afirmación de economía del contexto de la arquitectura: las rondas antiguas de herramientas completadas con éxito no necesitan permanecer en la ruta de reproducción como carga de historial en bruto. Pueden convertirse en memorias compactas vinculadas a su procedencia mientras las evidencias en bruto siguen siendo recuperables fuera del prompt.
9.2 Conservación de la recuperación y la procedencia
Reducir tokens solo es útil si no se pierde estado importante. Por eso los escenarios probados incluyeron casos de recuperación, procedencia, privacidad, ramas y límites entre participantes: estado de selector de documentos diferido, archivos generados, memoria desactualizada de aplicaciones conectadas, estado de ejecución con varias skills, visibilidad de participantes, contradicción y sustitución, reparación de procedencia rota, rehidratación exacta de CSV en bruto, aislamiento de ramas, errores cruciales para reintentar, omisión de datos de Google por privacidad, estado de continuación de subagentes, atribución en discusiones autónomas, captura de artefactos de subagentes hijos, metadatos de reanudación del padre, compatibilidad con tareas programadas y compatibilidad con envíos en ramas.
La ruta ensamblada mejoró el comportamiento en puntos donde la reproducción del historial era estructuralmente débil. Excluyó el estado provisional privado de participantes, reparó la procedencia en lugar de inventar identificadores sustitutos, seleccionó el estado de la rama activa, conservó errores cruciales para reintentar, omitió cuerpos en bruto de Google cuando la política lo requería y recuperó artefactos exactos en bruto cuando la política lo permitía.
9.3 Cobertura de modos de ejecución
La misma arquitectura debe funcionar en los distintos modos de generación, no solo en el bucle sencillo de chat. Un turno normal de chat, un turno multimodelo, una discusión autónoma, una ejecución de subagente hijo, una reanudación del padre, una tarea programada y un envío en una rama tienen límites de contexto distintos.
La lección importante de la implementación es que el ensamblado del grafo debe probarse en esos límites. El estado del subagente hijo debe permanecer privado hasta su promoción. La reanudación del padre debe usar un punto de control determinista. La discusión autónoma debe conservar las etiquetas de interlocutores y las instrucciones del moderador. Los envíos en ramas deben heredar el linaje activo sin incorporar artefactos de ramas hermanas.
Aquí es donde más importa el modelo de grafo. El grafo no solo reduce tokens; da al entorno de ejecución un vocabulario para decidir qué estado corresponde a cada modo de generación.
9.4 Qué mostró la validación interna
La validación interna tuvo dos capas.
- La capa determinista comprobó que la política de ensamblado conservaba el estado de ejecución imprescindible. Los artefactos en bruto de herramientas se persistían antes del truncamiento a nivel de mensaje. El estado de herramientas sin resolver, diferido, fallido y crucial para reintentar seguía visible para el modelo. El estado privado de un participante se excluía de los participantes hermanos. Las memorias desactualizadas se marcaban u omitían en lugar de tratarse silenciosamente como verdad actual. Las memorias sustituidas se omitían y sus sustitutas actuales seguían pudiendo seleccionarse. La procedencia rota se reparaba o se marcaba como desactualizada sin inventar identificadores sustitutos. Los artefactos y memorias locales de rama se seleccionaban del linaje activo en lugar de ramas hermanas recientes. Los datos en bruto restringidos por privacidad se omitían y los resúmenes seguros y las indicaciones de revalidación seguían disponibles.
- La capa de comparación en vivo representó después los mismos escenarios de dos formas: reproducción del historial del enfoque anterior y contexto ensamblado del grafo. La ruta ensamblada conservó los datos de recuperación y procedencia necesarios y redujo drásticamente la exposición del prompt.
En los escenarios en vivo medidos anteriormente, las reducciones oscilaron entre el 82,2 % y el 90,1 %.
9.5 Interpretación
Estas mediciones validan la premisa de reducción de contexto en los escenarios de implementación probados. Muestran que la ruta ensamblada de NanthAI:Edge puede reducir considerablemente la reproducción predeterminada de datos históricos de herramientas, la exposición de estado provisional privado de participantes, el tratamiento de estado desactualizado de aplicaciones conectadas como verdad actual, la contaminación entre ramas hermanas, la pérdida de estado de herramientas crucial para reintentar y la invención de procedencia cuando se rompen los localizadores.
Las mediciones responden a una pregunta:
¿Reduce el ensamblado del contexto regido por políticas la exposición de contexto al modelo y conserva al mismo tiempo el estado importante de recuperación y procedencia en los escenarios probados?
La respuesta es sí.
10. Discusión
El patrón que extraería de la arquitectura es este: mantener el historial como la historia dirigida a las personas, almacenar artefactos en bruto de herramientas antes de truncarlos, derivar memorias compactas de los artefactos en lugar de resúmenes sueltos, conservar la procedencia hasta las evidencias en bruto, registrar la vigencia y la sustitución, delimitar el estado de ejecución por participante y rama, ensamblar el contexto del modelo mediante políticas y no por antigüedad de los mensajes, registrar suficiente información de la decisión de ensamblado para explicar qué ocurrió, rehidratar artefactos en bruto solo cuando se necesiten y se permitan evidencias exactas, y mantener la cognición del entorno de ejecución fuera de la experiencia de usuario salvo que este pida una vista de auditoría.
Esa es la arquitectura real.
Para los equipos de implementación, las reglas prácticas son igual de directas. Resolver una política de ensamblado inmutable antes de seleccionar candidatos del grafo. Obtener el linaje de la rama activa antes de completar con candidatos compartidos o con alcance de conversación. Rehidratar datos en bruto respaldados por almacenamiento solo después de que los seleccione la política de privacidad y presupuesto. Tratar el estado de subagentes hijos como privado o solo para auditoría hasta su promoción explícita. Registrar por qué se omitieron registros, no solo qué se incluyó.
No «memoria a largo plazo». No «GraphRAG». No «ventanas de contexto más grandes».
Un entorno de ejecución regido por políticas que decide qué merece entrar en la siguiente llamada al modelo.
Esto tiene varias implicaciones:
- El ensamblado del contexto se convierte en un elemento básico del entorno de ejecución. Debe probarse y versionarse como cualquier otro contrato crítico del backend.
- La memoria pasa a poder justificarse. Una memoria sin metadatos de procedencia, vigencia y confianza no basta para flujos exigentes con herramientas.
- Las salidas de herramientas dejan de ser una carga del historial. Los artefactos en bruto pueden conservarse para recuperación y auditoría sin reproducirse eternamente.
- Los límites entre participantes se hacen explícitos. Los sistemas multimodelo y de subagentes necesitan distinguir las salidas visibles del estado privado de ejecución.
- La ramificación se vuelve estructural. Una rama no es solo navegación de interfaz; restringe qué artefactos y memorias deben influir en la siguiente llamada al modelo.
- La auditoría pasa de registros a explicaciones. El objetivo no es solo almacenar eventos, sino reconstruir por qué un modelo vio un contexto concreto.
Esta es la dirección que estamos tomando en NanthAI:Edge: el historial del agente debe ser persistente sin reproducirse a ciegas, y el contexto del modelo debe ensamblarse a partir de un estado de grafo regido por políticas en lugar de heredarse del orden de los mensajes.
11. Conclusión
La industria está pasando de los chatbots a los agentes que usan herramientas. Eso cambia el problema del estado. Un chatbot a menudo puede funcionar reproduciendo el historial.
Un agente que escribe archivos, lee documentos, llama a API, busca en la web, crea subagentes, ejecuta tareas programadas, ramifica conversaciones y compara modelos no puede tratar el historial como todo el entorno de ejecución.
El historial es una proyección. Es necesario, pero incompleto. El modelo necesita contexto. El usuario necesita un registro de lo ocurrido.
El sistema necesita evidencias. El auditor necesita procedencia. El bucle de reintentos necesita estado de recuperación. La capa de privacidad necesita políticas.
El producto necesita que todo eso coexista sin convertir cada solicitud al modelo en un vertedero de datos antiguos de herramientas.
Eso es lo que hace la arquitectura:da al historial del agente una forma persistente en el entorno de ejecución sin convertir cada solicitud futura al modelo en una reproducción de datos antiguos de herramientas.
La capacidad del agente no debe crecer linealmente con el tamaño del prompt.
El historial del agente no debe crecer linealmente con la reproducción del historial.
La siguiente capa es el ensamblado del contexto regido por políticas.
Referencias
- Anthropic. Effective context engineering for AI agents. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Haystack. Context engineering. https://haystack.deepset.ai/blog/context-engineering
- Atlan. How to structure context for LLM applications. https://atlan.com/know/how-to-structure-context-for-llm-applications/
- LangGraph. Persistence. https://docs.langchain.com/oss/python/langgraph/persistence
- LangGraph. Durable execution. https://docs.langchain.com/oss/python/langgraph/durable-execution
- LangGraph. Add memory. https://docs.langchain.com/oss/python/langgraph/add-memory
- Databricks. Memory scaling for AI agents. https://www.databricks.com/blog/memory-scaling-ai-agents
- Google Cloud. What is Model Context Protocol? https://cloud.google.com/discover/what-is-model-context-protocol
- Portable Agent Memory. https://arxiv.org/html/2605.11032v1
- MemORAI. https://arxiv.org/html/2605.01386v1
- ESAA: Event Sourcing for Autonomous Agents in LLM-Based Systems. https://arxiv.org/abs/2602.23193
- Audit Trails for Accountability in Large Language Models. https://arxiv.org/html/2601.20727v1
- STALE. https://arxiv.org/html/2605.06527v1
- Evaluating the Long-Term Memory of Large Language Models. https://aclanthology.org/2025.findings-acl.1014/
- OWASP Agent Memory Guard. https://owasp.org/www-project-agent-memory-guard/
- OWASP. LLM Prompt Injection Prevention Cheat Sheet. https://cheatsheetseries.owasp.org/cheatsheets/LLM_Prompt_Injection_Prevention_Cheat_Sheet.html
- ARGUS. https://arxiv.org/html/2605.11053v1
- Beyond RAG for Agent Memory. https://arxiv.org/html/2602.02007v2
- LongMemEval-V2. https://arxiv.org/html/2605.12493v1
- Agentic Memory. https://arxiv.org/html/2601.01885v2
- Governing Evolving Memory in LLM Agents. https://arxiv.org/html/2603.11768v1
- Giskard. Cross-session leak: when your AI assistant becomes a data breach. https://www.giskard.ai/knowledge/cross-session-leak-when-your-ai-assistant-becomes-a-data-breach
- Unit42. Indirect prompt injection poisons AI long-term memory. https://unit42.paloaltonetworks.com/indirect-prompt-injection-poisons-ai-longterm-memory/
- Diagrid. Checkpoints are not durable execution. https://www.diagrid.io/blog/checkpoints-are-not-durable-execution-why-langgraph-crewai-google-adk-and-others-fall-short-for-production-agent-workflows
- Zero Data Retention in LLM-based Enterprise AI Assistants. https://arxiv.org/abs/2510.11558
También publicado en LinkedIn.