NanthAI:Edge 技术案例研究。
大多数使用工具的 AI 智能体处理历史的方式都有问题:每次工具调用、工具结果、生成文件、重试、摘要、错误和续接,都会再次通过可见对话记录传入,直到被裁剪、压缩或丢失。
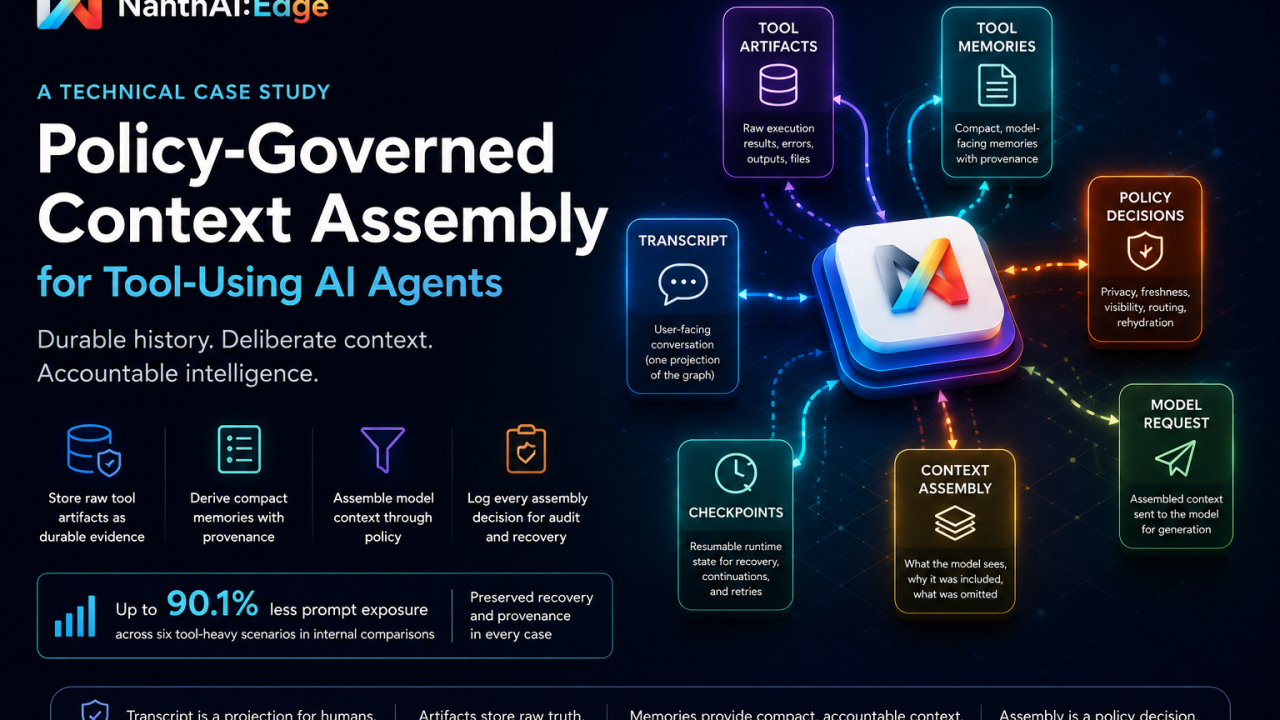
在 NanthAI:Edge 中,这不只是理论。内部对比测试中,组装后的图上下文在多工具文件生成工作流中,提示词呈现量从 1905 降至 221 个 token;在矛盾/替代工作流中,从 1986 降至 197 个 token;在延后处理的文档选择器工作流中,从 1020 降至 142 个 token。这不能证明任务成功率更高,但确实证明,在保留恢复和溯源状态的同时,能显著缩小呈现给模型的上下文范围。
构建 AI 智能体最简单的方式,仍然是不断往对话中追加内容。
用户提问,模型调用工具,工具返回结果,结果放进对话。模型再调用工具,又追加一个结果。智能体写文件、遇到错误、重试、总结、创建分支、稍后恢复,可能还创建子智能体,而对话记录持续增长。
起初,这感觉很自然。对话记录就在眼前,有顺序,可阅读,看起来像记忆。但对使用工具的智能体而言,对话记录是个陷阱。
对话记录是用户应该能阅读的内容,并不等同于模型接下来应该看到的内容。一旦智能体运行工具、处理文件、调用 API、跨分支工作、比较模型,或携带私有运行时状态,可见聊天记录就不适合作为事实依据。它把产品体验、证据、记忆、重试状态、隐私边界、过时观察和审计记录混在同一条时间流中。
更好的模式,是将对话记录视为更丰富的运行时图的一种投影。原始工具输出存为持久化产物,再从中提炼精简记忆。溯源关系将记忆关联回证据。分支、参与者、模型运行、工具调用、检查点和策略决策都是独立实体。每次模型请求从图中接收受策略约束的组装上下文,而非盲目回放旧消息。
这就是本文主张的架构:不是“更多记忆”,不是“用更大的上下文窗口就好”,也不是“一切都用 GraphRAG”。观点更具体:智能体历史应当持久保存,却不必永远回放;模型上下文应经过有意组装,而不是继承消息顺序。
摘要
使用工具的大语言模型(LLM)智能体,在对话历史、运行时状态、工具证据、记忆、隐私和上下文精简之间面临结构性矛盾。一种常见实现将可见对话记录同时作为面向用户的历史和面向模型的上下文:以往消息、工具调用、工具结果、摘要、错误和生成产物被回放到后续请求,直到被裁剪、压缩或丢失。这种方式简单,却将用户体验与运行时认知耦合,使上下文选择成为消息顺序的偶然副产品。
本文阐述受策略约束的上下文组装设计模式,将对话记录视为更丰富的运行时图的一种投影,而非模型的事实来源。运行环境将原始工具产物与精简工具记忆分开存储,保留从派生记忆回溯到证据的溯源关系,跟踪参与者和分支归属,并按明确的策略版本记录上下文组装决策。
本文结合上下文工程、智能体记忆、图状态、事件溯源、具备溯源能力的记忆、记忆过时故障、提示词注入和智能体审计轨迹等既有工作,讨论这一模式,并以 NanthAI:Edge 作为实现示例。
本文认为,最有力的贡献在于整合后的运行时约定:持久化工具产物、精简工具记忆、作为独立实体的上下文组装、策略决策、限定参与者范围的运行时归属、感知分支的图选择、时效与替代策略、原始产物还原,以及运行时认知与用户可见对话记录之间的明确边界。
本文的贡献包括:一个用于在使用工具的智能体中分离对话记录与上下文的概念框架;一份面向实现的 NanthAI:Edge 持久化产物与上下文组装架构分析;一项涵盖上下文工程和图运行环境的既有技术比较;一份策略层风险清单;以及来自内部对比场景的实现测量。
1. 引言
在上一篇 NanthAI 文章中,我讨论了以技能作为工具访问入口。当时的问题是能力膨胀。随着智能体获得更多工作流、集成和领域指令,朴素方法会不断向每次请求添加更多提示词和工具模式定义。NanthAI:Edge 通过先呈现精简技能目录,再仅在任务确有需要时加载完整指令并扩展可执行工具注册表,避免这一点。这解决了上下文问题的一半,另一半出现在工具运行之后。
工具调用会产生搜索结果、文件、引用、API 载荷、通过 OAuth 获取的数据、错误、部分输出、重试状态、生成产物、私有临时状态、过时的外部观察、子智能体状态和续接检查点。如果运行环境不断通过可见对话记录回放这一切,模型上下文就会变得昂贵、嘈杂,有时还会出错。
这带来两个相关问题。
- 对话记录膨胀:旧工具调用、工具结果、生成产物、摘要、重试和操作状态不断在对话历史中累积,并被反复传回模型。
- 运行时状态含混:对话记录被要求同时充当用户历史、模型记忆、审计轨迹、重试状态、隐私边界和工具证据存储。
两者代价都很高。它们消耗输入 token,提高延迟和费用,使提供商路由复杂化,也让人更难确定模型生成回答时究竟知道什么。
更重要的是,它们会损害正确性。模型可能将过时工具输出视为当前事实。重试所必需的错误可能被摘要抹去。某分支可能继承同级分支生成的文件。参与者的私有工作笔记可能泄露到另一个模型的上下文。精简摘要可能丢失后续审计或还原所需的精确值。
本文探讨一种结构化替代方案:在运行时图上进行受策略约束的上下文组装。
模式很简单:将对话记录作为面向人的历史,将原始工具产物与消息分开存储,从产物提炼精简工具记忆,保留从记忆回溯到原始证据的溯源关系,依据明确策略从图状态组装每次模型请求,并记录足够的组装决策,以解释模型看到了什么以及原因。
在 NanthAI:Edge 中,这种架构无需改变公开聊天界面即可运作。用户仍会看到消息、工具卡片、生成文件、引用、分支、重试、续接和模型回复。后台运行环境则将对话记录、产物、记忆、策略决策和上下文组装分开。
同一边界也适用于不同运行模式。普通对话轮次、多模型比较、自主讨论、子智能体运行、子智能体结束后父智能体的恢复、定时任务和分支发送,并不具有完全相同的上下文约定。辩论式自主讨论应保留发言者标签和主持人指令。子智能体默认不应向父智能体泄露原始工作区状态。父智能体恢复时,应遵循其确定性检查点,而非盲目查询对话记录。上下文组装必须感知运行模式。
本文提供了区分对话记录、上下文、产物、记忆和策略的术语;持久化工具产物与精简工具记忆的具体架构;对多模型和子智能体工作流中参与者范围运行时状态的分析;与既有技术的比较;以及实现测量及其局限的解读。
TRANSCRIPT PROJECTION (User-Facing UI)
Ordered messages · Tool cards (truncated) · Generated files · Citations · Branches · Model responses
One projection of the same runtime graph
RUNTIME GRAPH (Durable State)
- MESSAGE (User/Assistant): User prompts; Assistant prose; Tool call / result messages (truncated for UI); Visible transcript
- MODEL RUN (Generation Attempt): Provider; Model & parameters; Participant; Message / Job ownership; Runtime mode
- TOOL CALL (Requested): Tool name; Arguments; Call ID; Status (requested / pending / failed); Model run linkage
- TOOL ARTIFACT (Raw Execution): Full arguments; Raw result or error; Status, timing; Tool version; Privacy classification; Storage handles; Hashes / byte size
- TOOL MEMORY (Compact, Model-Facing): Summary / structured data; Source artifact ID(s); Confidence + source; Freshness & stale-after; Provenance locators; Contradictions / supersession; Revalidation tools
- CONTEXT ASSEMBLY (Policy-Governed): Policy version; Assembler version; Selected memories; Rehydrated artifacts; Legacy vs assembled tokens; Omission summaries; Timing & telemetry
- MODEL REQUEST (Provider Prompt): System / instructions; Selected messages; Selected memories; Rehydrated raw (if any); Skill state; Recovery state; Provider + settings
KEY RELATIONSHIPS
Primary execution flow →
Artifacts produced by calls
Memories derived from artifacts
Policy selection & assembly
UI projection (readable view)
WHAT HAPPENS WHERE
ToolCall → ToolArtifact: Execute the tool and capture raw evidence.
ToolArtifact → ToolMemory: Extract, summarize, classify, link provenance.
ToolMemory → ContextAssembly: Policy decides what to include.
ContextAssembly → Model Request: Serialize the selected context.
Transcript Projection: Human-readable view, not the source of truth.
POLICY CONSIDERS
Ownership (participant / model run / branch)
Visibility (private / branch / conversation / audit)
Privacy & provider-routing constraints
Freshness, staleness, revalidation needs
Promotion, contradiction, supersession
Recovery state & retry protection
Context budget & raw rehydration bounds
Retention, deletion, and safety rules
OUTCOME
The model sees a deliberate, policy-governed context assembled from durable runtime state — not a blind replay of the transcript.
Smaller context. Better signal. Preserved evidence. Clear auditability.
Core Principle: Transcript is a projection for humans. Artifacts are raw truth. Memories provide compact, accountable context. Assembly is a policy decision.
2. 背景:上下文工程、记忆与工具状态
2.1 上下文工程
上下文工程是决定哪些信息进入模型上下文的实践,比编写提示词更广。它包括系统指令、对话历史、检索证据、工具输出、记忆、策略、任务状态和格式。
现代上下文工程指导支持这样一种观点:模型上下文应被显式组装,而非当作原始对话记录。Anthropic 将上下文工程描述为管理提供给智能体的信息。Haystack 和 Atlan 也将上下文描述为指令、历史、检索、工具输出和记忆等结构化区域。
这种区别很重要,因为不同上下文类别有不同的生命周期和可信属性。用户消息、生成文件 ID、OAuth 载荷、过时搜索结果、可重试工具错误和文档引用,不应按同一规则裁剪、摘要、保留或呈现。
对话记录尤其容易误导,因为它看起来完整。它按时间顺序证明某事发生过,却不一定包含实际发生的原始内容、允许它的策略、拥有它的分支、看过它的参与者,或后续轮次仍应信任它的原因。对简单聊天产品,时间顺序可能足以近似上下文;对使用工具的智能体,时间顺序只是一个维度。
因此,该架构将上下文视为组装后的投影。投影可以包括近期对话轮次、选定工具记忆、未解决工具状态、已加载技能状态、提供商/隐私约束和选定原始产物,也可以省略过时、私有、已被替代、不符合分支条件、超出预算,或不适合发送给所选提供商的记录。是否纳入是决策,而非消息年龄的偶然结果。
2.2 智能体记忆
智能体记忆研究通常区分工作记忆、情景记忆、语义记忆、程序性记忆和长期记忆。LangGraph 等框架区分短期和长期记忆。LLM 智能体记忆综述强调,这一领域仍然分散:在记忆表示、溯源、时效、矛盾或保留方面,尚无公认的跨框架模式。
这种分散很重要。“记忆”常被用作涵盖多种事物的宽泛术语:用户偏好、从以往对话提取的事实、旧对话摘要、工具观察、生成文件句柄、检索文档、任务计划、执行轨迹和溯源引用。
该架构将用户记忆与工具记忆分开。用户记忆负责个性化,工具记忆负责从工具产物派生的运行时证据。
这种区分不只是产品分类。它能防止运行时观察仅因出现在对话里,就变成持久的用户事实。如果工具读取 Slack 讨论串,可以生成关于讨论串状态的有界记忆,却不应成为永久用户偏好。如果文档生成工具创建文件,其句柄可以是持久操作状态,但与“用户喜欢简短回答”不是同类记忆。
因此,工具记忆需要普通个性化记忆通常不需要的字段:产物 ID、来源工具名、隐私类别、时效类别、溯源定位信息、置信度来源、修复尝试、矛盾链接、替代链接和提升策略。在此架构中,记忆不是“模型可能想记住的东西”,而是运行环境能够交代来源、受策略约束的精简证据表示。
2.3 作为状态的工具轨迹
使用工具的智能体每次调用工具都会创建状态。调用参数、结果、错误、时间信息、提供商、运行环境、当前技能状态和归属上下文,都可能在之后有用。
业界和研究领域越来越认识到这一点。Databricks 将工具调用轨迹和执行结果作为智能体状态讨论。LangGraph 持久化图状态和检查点。MCP 让工具与上下文来源明确,并能结构化记录。事件溯源研究认为,自主智能体需要支持重建和审计的仅追加记录。
关键推论是,工具结果不应仅作为对话消息存在。消息适合显示,却不适合作为原始证据的存储层。
对话消息通常针对人类可读性和客户端兼容性优化。它可能被截断、脱敏、摘要、为呈现而重排,或被压缩掉。这正是产品界面需要的,却不是恢复系统所需的:用户以后可能说“使用之前那份确切的 CSV”,审计也可能追问为何引用某个文件 ID。
该架构在这种面向显示的转换之前捕获产物。消息仍可显示清晰的工具卡片或精简结果。产物存储则保留恢复和审计所需的原始参数、原始结果或错误、哈希值、字节数、存储句柄、运行时归属、隐私分类和工具版本元数据。
2.4 记忆过时与矛盾
持久记忆引入一种失败模式:智能体可能继续依赖已过时、被反驳或被替代的信息。STALE 等基准测试和 LOCCO 等研究表明,长期记忆并非天然可靠。如果旧事实被当作当前真相,记得更多反而可能让系统更差。
这支持明确的时效和替代策略。Slack 讨论串摘要、CRM 快照、日历空闲查询结果、生成文件句柄和不可变文档版本,不应按同样方式随时间失效。
记忆过时的问题,不只是旧事实变得不真实,而是模型接收它们时往往看不到失效标记。如果运行环境只回放消息,六周前的日历空闲结果和不可变文档版本 ID,都可能表现为“先前上下文”。该架构通过时效类别和过时截止元数据明确区分它们。
矛盾是相关的失败模式。两条记忆都可能源自真实产物,却仍然冲突,因为它们来自不同文档版本、分支、提供商或提取方法。除非策略有足够的溯源和置信度信息支持解决冲突,否则系统不应将它们合并为一条“最后写入者胜出”的摘要。
2.5 溯源与审计
具备溯源能力的记忆是一个新兴主题。MemORAI 将图记忆链接到来源轮次;Portable Agent Memory 提出经溯源验证的记忆对象;ARGUS 使用影响溯源图来分析不安全工具调用。审计轨迹和事件溯源文献同样主张,AI 系统需要可重建的数据、模型、工具和决策事件历史。
对智能体运行环境,重要的审计问题是:
模型为什么这样说?
答案不能只来自对话记录,还需要知道组装了什么上下文、纳入了哪些记忆、还原了哪些原始产物、哪些策略省略了数据,以及状态归哪个参与者或分支所有。另一个审计问题同样重要:
模型为什么没看到某些内容?
这正是受策略约束的组装与普通日志的区别。生产事故可能并非坏工具结果引起,而是有用结果因过时、超出预算、不符合分支条件、属于另一参与者私有、被归类为 Google 派生数据,或禁止原始还原而被排除。该架构记录精简的省略摘要,让调试不仅能追问“有什么”,也能追问“缺了什么”。
3. 受策略约束的上下文组装
受策略约束的上下文组装,将模型上下文视为运行时状态上的投影。对话记录并未被丢弃,它仍是面向人的历史,只是不再承担所有运行时职责。
运行环境区分对话消息、模型运行、工具调用、原始工具产物、精简工具记忆、已加载技能状态、续接检查点、分支谱系、参与者归属、策略决策和上下文组装日志。上下文组装器便能根据当前任务、分支、参与者、提供商、隐私策略、时效策略和恢复状态,选择模型看到的内容。
这一模式分开了常被混为一谈的四个层面。对话记录面向用户:可读、稳定、适合产品。产物存储面向运行环境和审计层:原始证据、可恢复性和保留策略。工具记忆面向模型上下文:精简、关联溯源、感知时效。上下文组装面向模型请求本身:为一次生成作出受策略约束的选择。
最重要的关系是:
工具执行先产生原始产物;记忆是在此基础上的策略决策。
这是架构的概念核心。第二个关系是:
上下文组装是受策略约束的图查询,而非对话记录转换。
组装器从当前生成边界开始:当前对话、来源用户消息、分支谱系、参与者、运行时类型、续接状态、所选提供商、已加载技能和工具可用性。随后选择符合条件的图记录,并决定各自如何呈现。近期消息可以保留为对话上下文;工具观察可以作为精简记忆进入;过时记录可以仅显示为过时标记和重新验证提示;需要精确证据时可以还原原始产物;未解决工具调用可作为恢复状态受到保护。私有、过时、已被替代、不符合分支条件或受提供商限制的记录可被省略,并在不暴露内容的情况下记录原因。
这种设计不要求所有检索都使用图数据库。图是运行时模型:相互关联的对话、分支、参与者、模型运行、工具调用、产物、记忆、检查点、组装和策略决策。向量搜索、索引表查询、存储读取和图遍历,都可作为该模型内部的实现技术。
一个有用的理解方式是:
用户可见的对话记录 = 选定 Message 节点的可读投影
面向模型的上下文 = Message + ToolMemory + ToolArtifact + SkillState + ContinuationCheckpoint + PolicyDecision + 分支谱系之上,由策略选择的投影
区别并非纯理论。对话记录回答“用户和助手看起来说了什么?”运行时图则回答记录无法回答的问题:哪个模型运行产生了答案,请求了哪些工具,工具产生哪些产物,从产物派生哪些记忆,状态归哪个分支和参与者所有,哪项策略允许或省略每条记录,以及哪些旧记忆已过时、被反驳或被替代。
正是这些问题让图方法有价值。它将上下文选择变为对有类型关系的查询,而不是对消息列表的截断策略。
实际中,图方法承担三项职责:其一,保留证据,即把原始工具产物保存在对话记录之外,并遵循保留和隐私策略;其二,生成精简可用的上下文,即把有用的产物内容转成工具记忆,供普通模型调用使用;其三,解释选择,即记录模型为何看到图的这一投影而不是另一投影。
图不需要对用户可见。用户看到对话,运行环境使用图来决定下一次模型调用应知道什么。
TRADITIONAL TRANSCRIPT REPLAY
- Message
- Message
- Message
- Message
- LARGE PROMPT
Replays old tool calls and results
Includes stale, private, and noisy data
Loses important structure and provenance
Wasteful, expensive, error-prone
POLICY-GOVERNED ASSEMBLY
- RAW ARTIFACTS
- COMPACT MEMORIES
- SELECTED CONTEXT
- MODEL REQUEST
Keeps raw evidence out of the prompt
Includes only relevant, current, and allowed data
Preserves provenance and recovery state
Smaller, faster, safer, and more reliable
4. 实现模式
本节描述 NanthAI:Edge 中实现的具体模式。这些细节有用,因为它们说明:当对话记录不再是模型上下文的事实来源时,系统必须具备什么。
4.1 运行时图模型
运行时图首先明确关键实体。Conversation 是用户拥有的对话容器。Branch 是对话图中有序的路径,继承先前共享历史。Participant 是运行中启用的模型或 Persona 配置。Message 是用户可见的对话记录节点。ModelRun 是针对某个参与者、消息或任务,面向提供商的一次生成尝试。
工具工作有自己的术语。ToolCall 是模型请求的函数调用,带有参数和调用 ID。ToolArtifact 是该调用或结果的持久化原始执行记录。ToolMemory 是从一个或多个产物派生、面向模型的精简记忆。SkillState 记录某次运行可见的已加载技能、已启用配置组、直接工具和集成状态。ContinuationCheckpoint 保存跨操作边界可恢复的运行时状态。
组装层也被明确建模。ContextAssembly 是一次面向模型的提示词组装的版本化决策记录。PolicyDecision 记录隐私、时效、裁剪、还原、提供商路由或恢复决策。
规范关系很直接。
- 助手对话内容由特定 ModelRun 生成。
- ModelRun 请求一条或多条 ToolCall 记录。
- 每个已执行、失败、等待中或延后处理的 ToolCall,都产生持久化 ToolArtifact。
- ToolMemory 从该产物派生,保留回溯原始证据的溯源关系。
- 分支从先前分支继承,无需复制全部状态。
- ContextAssembly 记录纳入了哪些记忆、还原了哪些原始产物。
- ContinuationCheckpoint 恢复运行时状态,而不只是对话消息。
- PolicyDecision 约束组装,使隐私、提供商、时效、裁剪和恢复选择明确可见。
Runtime graph
- Conversation
- Branch
- Participant
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- Participant
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- Participant
- Branch
Tool memories across the active lineage → ContextAssembly → PolicyDecision → Checkpoint
Relationships
Conversation contains / has Branches; Branches inherit from the conversation.
Branches contain Participants; Participants contain Messages; Messages generate ModelRuns.
ModelRun requests ToolCall; ToolCall produces ToolArtifact; ToolMemory is derived from ToolArtifact.
ToolMemory is assembled into ContextAssembly. ContextAssembly is constrained by PolicyDecision. Checkpoint restores state.
Legend: contains / has; inherits from; generates; requests; derived from; assembled into; constrained by; restores.
4.2 持久化工具产物
ToolArtifact 是工具执行的持久化原始记录。
它记录工具调用 ID、工具名、参数、原始结果或错误、状态、消息和任务归属、参与者和模型运行归属、分支范围、隐私分类、当前技能与工具配置组、提供商和运行时元数据,以及过大参数或结果的存储句柄。
为兼容客户端和渲染,消息级工具结果仍可存在。它们可以被截断、摘要或调整以适合界面。用于显示没有问题,却不足以支撑长期工作流、审计、重试或精确还原。
关键是在消息级截断之前捕获完整产物。这样界面可以保持简洁,后台仍保留可恢复的证据。
当后续轮次需要早先调用的确切 CSV、失败调用需要重试、延后处理的选择器必须继续、引用文档需要解释、生成文件 ID 必须保留、子智能体输出需要审计,或私有工具载荷必须避开同级模型上下文时,这一点就很重要。
4.3 工具记忆
ToolMemory 是从一个或多个产物派生、面向模型的精简记录。
工具记忆与用户记忆分开。用户记忆代表个性化和持久用户事实;工具记忆代表运行时证据和工具派生状态。
工具记忆携带来源产物 ID、来源工具名、摘要文本、结构化载荷、置信度、置信度来源与理由、歧义和局限说明、隐私分类、时效类别、过时截止时间戳、重新验证工具、溯源定位信息、最近解决状态、修复尝试、矛盾链接、替代链接和提升策略。
目标不是让模型记住一切,而是让记忆有据可查。精简记忆应保留足够的溯源信息,让系统日后能回答:记忆从哪里来,是否仍有效,以及能否或是否应还原精确的原始证据。
- 1. USER REQUEST: User asks a question or gives a task
- 2. MODEL RUN: Model decides to call one or more tools
- 3. TOOL CALL(S): Tool(s) executed with arguments from the model
- 4. TOOL ARTIFACT: Raw result or error captured as durable evidence (artifact)
- 5. TOOL MEMORY: Compact memory derived from artifact(s) with provenance
- 6. CONTEXT ASSEMBLY: Policy selects what to include, what to rehydrate, what to omit, and why
- 7. MODEL REQUEST: Assembled context sent to the model for the next generation
FEEDBACK LOOPS (as needed)
Revalidation · Retries · Continuations · Checkpoints · Branches · Subagent Promotion
Feedback returns to the relevant execution and context stages.
4.4 ContextAssembly
ContextAssembly 是记录哪些内容进入特定模型请求的独立实体。
它存储传统方式下的消息数、组装后消息数、估算 token 差值、原始产物数、所选记忆数、还原产物数、策略版本、组装器版本、所选图引用、省略摘要、安全与隐私决策、图查询耗时、策略评估耗时和序列化耗时。
审计目标是:
模型为什么看到这些上下文?
答案不应是“因为它在最近 N 条消息里”,而应更接近:
这条回复纳入了从 ToolArtifact_88 派生的 ToolMemory_123;它从当前分支继承,对该参与者可见,按策略版本 4 组装;因为精简记忆已足够,所以跳过了原始产物还原。
或:
这条回复省略了一份 Google 派生原始载荷,因为提供商路由/隐私策略将其归为受限内容,但纳入了安全摘要和重新验证工具提示。
4.5 PolicyDecision
上下文组装是策略评估,不只是裁剪。
- 归属策略:判断记录归哪个参与者或模型运行所有。
- 可见性策略:决定记录是参与者私有、分支可见、对话可见,还是仅供审计。
- 隐私策略:判断数据能否发送给所选模型或提供商。
- 时效策略:决定记录是当前有效、过时、持久,还是需要重新验证。
- 提升策略:决定产物是否应转为面向模型的记忆。
- 还原策略:决定精简记忆是否足够,还是需要精确原始证据。
- 矛盾与替代策略:解决冲突和替换关系。
- 恢复策略:保护未解决、失败、延后处理或重试所必需的状态。
- 保留策略:决定记录应保留、裁剪、归档还是删除。
实现中,每次生产组装记录的是精简策略摘要和省略数量,而非冗长的逐条轨迹。详细轨迹仍可用于测试和定向审计。
| Scenario | Policy Decision | Action | In Context? | Why |
|---|---|---|---|---|
| Google Gmail body (ZDR provider) | Privacy / Provider Restriction | Omit raw body, include safe summary + revalidation tool | Partial | Provider cannot receive Google content |
| Slack thread summary (2 weeks old) | Freshness (Bounded) | Include as stale marker + revalidation tool | Stale | May be outdated, needs recheck |
| Generated CSV file handle | Durability (Session) | Include compact memory (file ID, schema) | Yes | Still valid in session, low risk |
| Sibling branch analysis result | Branch Visibility (Branch-Private) | Omit from active branch context | No | Different branch, not relevant |
| Failed tool call (retry needed) | Recovery (Protected) | Include error + retry state | Yes | Required for recovery |
Every inclusion or omission is logged with policy version, reason, and scope.
4.6 上下文类别
上下文按应如何裁剪、保留、摘要、还原和呈现进行分类。
- 对话上下文:包括用户和助手正文或分支内讨论,可采用窗口截取和摘要。
- 操作上下文:包括工具参数、工具结果、工作区路径和生成文件 ID;摘要前应先保存为产物。
- 认知上下文:包括主张、发现和提取的事实,应作为工具记忆保存,并带有置信度和时效元数据。
- 溯源上下文:包括产物 ID、文档 ID 和引用,应保留以供审计,或在主张依赖它们时还原。
- 策略上下文:包括提供商约束、OAuth 范围和使用权限,必须在组装前执行。
- 恢复上下文:包括错误、延后状态和重试约定,未解决前不应裁剪。
- 规划上下文:包括当前运行或续接的已加载技能、已启用配置组和任务分解。
这可以避免消息年龄成为唯一的裁剪规则。
4.7 时效与过时
工具记忆不能悄然变成永恒真理。每条工具记忆都有时效类别:
- 易变记忆:涵盖未读数量、可用情况和搜索排名等。
- 会话记忆:涵盖临时运行文件、工作目录和临时状态。
- 有界记忆:涵盖 CRM 记录、Slack 讨论串摘要或 Notion 页面状态等快照。
- 持久记忆:涵盖生成文件元数据、文档引用和明确的提供商实体 ID。
- 永久记忆:涵盖不可变文档版本 ID 或已生成存储产物的标识。
组装器默认不会将过时的易变记忆或有界记忆作为当前事实注入。它可以将其作为过时上下文纳入、提供重新验证路径、将其省略,或在需要且允许精确证据时选择原始还原。
4.8 矛盾与替代
这种方法尽可能避免“最后写入者胜出”的记忆。
工具记忆可能冲突。一个分支分析文档草稿并得出结论,另一个分支可能分析后续版本。某次提供商查询报告的公司员工数,可能被之后另一次查询反驳。一个模型可能错误总结来源,另一个则从原文件提取精确值。
运行环境跟踪冲突链接、替代链接、置信度、置信度来源、来源产物、局限和歧义说明。重要字段具有方向性:conflictsWith 标记分歧,supersedes 表示当前记忆替代旧记忆,supersededBy 则从过时记忆指向替代它的新记忆。
策略是保守的。冲突记忆保留为独立记录。已被替代的记忆通常从当前模型上下文中省略,而当前替代记录仍可被选择。不确定性重要时,可以同时纳入矛盾双方。解决冲突需要溯源和置信度,而不只是看谁更新。
一个实际细节很重要:supersedes 应表示“当前这条记忆替代旧记忆”。相反方向应使用 supersededBy 等独立字段。
这听起来很小,但含混会导致真实缺陷。如果上下文组装器丢弃新替代记忆而非过时记忆,就会让模型在自认为谨慎的同时,依据过时状态推理。
4.9 参与者与运行时归属
NanthAI:Edge 支持多模型运行、自主讨论、子智能体、分支、定时任务和大量使用工具的续接。因此归属很重要。
可见的助手消息可以成为共享对话上下文。
但原始运行时状态不应仅因发生在同一段对话中,就自动变为共享。
在此架构中,工具产物、工具记忆、上下文组装和续接检查点,携带 visibilityScope、ownerParticipantId、ownerModelRunId、sharedWithParticipants、runtimeIsolationPolicy 和 runtimeKind 等归属元数据。
默认策略是:模型运行状态限定在参与者范围内,并相互隔离。用户可见助手输出在最终完成后,可成为分支或对话上下文。私有临时状态不会泄露给同级参与者。未解决工具调用仍对所属参与者和必要续接可见。子智能体产物在显式提升之前,保持私有或仅供审计。
这是智能体架构中较少被充分记录的部分之一。
许多多智能体示例讨论协作,但较少定义这些内容之间的边界:某模型公开说了什么、私下看到了什么、其工具返回了什么、子智能体发现了什么、父智能体之后能用什么,以及哪些内容仅供审计。
该架构明确了这条边界。
4.10 感知分支的图组装
NanthAI 对话可以分支,因此上下文组装不能只是“按对话 ID 获取近期记忆”。如果两个分支产生不同文档 ID、生成文件或分析结果,当前分支不应被同级分支较新的产物污染。
解决办法是让组装感知分支。首先从当前分支谱系中选择候选项。显式共享或对话范围的记录仍可填补剩余位置,但同级分支的私有状态不能挤占当前分支上下文。
上下文组装日志将分支排除与普通上下文预算省略分开记录。这很重要,因为分支错误很隐蔽。模型可能自信地使用属于另一个分支的文件、引用或文档 ID 作答。界面看起来正常,对话记录看起来合理,但运行环境已混合了两条不兼容的路径。
感知分支的组装将对话视为图,而非平铺消息列表。
BROKEN: TRANSCRIPT REPLAY (BRANCH POLLUTION)
- Root conversation → Branch Point (User question)
- Branch A (Active) → Generates File_A.csv
- Branch B (Sibling) → Generates File_B.csv
- Active Branch A – Next Call Context: Root conversation; Branch A messages; File_A.csv (correct); Branch B messages (leaked); File_B.csv (incorrectly included)
Linear transcripts can leak sibling branch artifacts into the active branch.
POLLUTION EXAMPLE: When Branch A asks a follow-up, transcript replay includes everything in the history — including artifacts from Branch B.
Result: Sibling branch contamination, higher token cost, and incorrect or confusing model context.
CORRECT: BRANCH-AWARE ASSEMBLY
- Root conversation → Branch Point (User question)
- Branch A (Active) → File_A.csv
- Branch B (Sibling) → File_B.csv (Private to B); Explicit Share (Optional) → Branch A
- Active Branch A – Next Call Context: Root conversation; Branch A messages; File_A.csv (correct); Shared from B (if any); Branch B private items (excluded)
Assembler selects only active lineage and explicitly shared records.
ASSEMBLY RULES (Examples): Include active lineage only; Include explicitly shared records; Respect branch-private boundaries; Apply policy and freshness rules; Avoid sibling branch leakage.
Result: Clean, relevant context. Lower token cost. No branch leakage. Policy-governed and auditable.
Legend: Active Branch; Sibling Branch; Branch Point; Message; Artifact / Generated File; Explicitly Shared; Branch-Private (Not Visible); Active Lineage; Sibling Lineage; Explicit Share; Leak / Pollution (Bad).
4.11 原始还原
精简记忆通常足够,但有时不够。如果用户要求“使用之前那份确切的 CSV”,摘要就不够,运行环境需要恢复原始产物。
该架构支持有边界的原始还原,关键在于“有边界”。存储中的原始产物仅在经过策略选择后才会还原,不会预先全部加载。
组装器检查是否需要精确细节、是否选中了该产物、隐私分类是否允许、字节预算是否可接受、提供商路径是否允许,以及记录是否尚未解决或对恢复至关重要。
- 如果是,可纳入原始产物。
- 如果否,组装器可纳入精简记忆、引用、过时标记、重新验证提示,或不纳入任何内容。
这避免了两个不良极端:永远回放原始工具载荷,或通过摘要抹去后续轮次需要的精确证据。
POLICY-GOVERNED ASSEMBLY
- RAW ARTIFACTS
- COMPACT MEMORIES
- SELECTED CONTEXT
- MODEL REQUEST
Keeps raw evidence out of the prompt
Includes only relevant, current, and allowed data
Preserves provenance and recovery state
Smaller, faster, safer, and more reliable
4.12 运行时认知不等于用户体验
该架构增加了大量内部运行时状态,但这些状态不应自动进入聊天界面。工具记忆、上下文组装、策略决策、溯源修复记录、省略数量和图查询轨迹,都属于运行时认知。
除非用户请求审计/调试解释,或主动打开检查器,否则它们不应变成对话正文。
这条边界很重要。许多 AI 产品模糊了它:助手开始把自己的记忆、策略、内部状态和工具记账又叙述回对话中。
这让对话记录更嘈杂,往往也更不可信。在 NanthAI:Edge 中,面向用户的对话记录仍是产品界面,运行时图则保留为执行层面。
溯源可通过引用、生成文件卡片、调试视图,或未来的“模型为什么这样说?”检查器呈现。
但运行环境不应为了自我解释而重写对话历史。
4.13 运行模式边界
不同运行模式需要不同组装规则。普通聊天和多模型聊天,使用针对当前参与者、感知分支的组装上下文。自主讨论在增加参与者可见组装上下文时,保留辩论提示词形式、主持人指令、发言者标签和受支持的非文本内容。子智能体运行捕获自身工具产物和记忆,归子智能体所有,默认私有或仅供审计。父智能体恢复时保留其确定性检查点,附上选定组装引用,并记录恢复决策,而非盲目查询对话记录。定时任务在创建对话轮次并进入生成流程时,使用正常后台生成路径。Ideascape 分支发送在客户端发送明确父节点 ID 后,也使用同一套感知分支的生成路径。
这是重要的收尾步骤,因为最难处理的上下文错误往往位于编排边界。普通聊天轮次可以直接使用当前分支和参与者,但子智能体结束后的父智能体恢复不同:父智能体应收到已提升的子智能体摘要、生成文件句柄、失败状态和重试相关状态,却不应收到原始子工作区载荷,除非这些载荷已被显式提升。
这需要运行时类型、子智能体批次/运行 ID、父消息/任务 ID、父工具调用 ID,以及必要的提升决策等元数据。目的不是为了模式而增加模式,而是在组装器将任何内容序列化进提供商请求之前,让归属和提升决策能够被表达。
4.14 子智能体提升边界
子智能体让对话记录与上下文的分离变得具体。
子智能体可能调用工具、读取文档、生成中间文件、遇到错误并维护私有临时状态。父智能体可能只需最终子报告、生成文件句柄、精简错误摘要或批次状态。如果运行环境只以对话消息形式存储子状态,就容易向父智能体回放过多内容。如果摘要后丢弃子状态,审计和恢复又会受损。
运行环境使用提升语义。原始子工具参数和结果默认是子智能体私有或仅供审计。子智能体终止后的提升会使生成文件句柄对父智能体可见。最终子报告对父智能体恢复可见。失败或超时的子状态可以作为精简恢复上下文提升。子智能体临时状态或工作区细节,除非显式提升,否则不对父智能体可见。
这样父智能体有足够上下文继续,又不会让每次子运行都变成原始对话记录负担。
Parent Agent (Orchestrator) — Before Subagent Call
- User request: “Research ACME Corp and prepare a report.”
- Subagent Call: Task scope, inputs, and constraints
Parent State (continues): Conversation history; Long-term memories; Policy & preferences; Runtime checkpoints
Child Subagent (Isolated Runtime) — Owns private runtime state and working context
Does Private Work: Tool Calls — Executes tools and external API calls; Raw Tool Payloads — Full results, responses, files, logs (verbose); Scratch / Intermediate State — Notes, reasoning, partial results, drafts, retries; Temporary Artifacts — Working files, temp exports, debug data.
Private to Subagent: Not visible to parent.
Produces Outputs: Final Report / Answer — Curated, high-quality result for the parent; Generated File Handle — Compact reference (file ID, schema, hash, storage pointer); Compact Memories — Summaries with provenance, TTL, and freshness; Audit Trail (Optional) — Tool call list, key decisions, policy summary (not raw data).
Isolation Boundary: Subagent state is not accessible to the parent at any time.
Promotion Gate
Policy-driven promotion of explicit outputs only. Everything else stays private.
Parent Resumes (after subagent completion)
- Receives Promoted Outputs Only: Final Report / Answer; Generated File Handle; Compact Memories; Audit Trail (if provided)
- Parent State (updated): Adds promoted memories; Stores file handle reference; Records audit summary; Continues conversation
- Next Steps: Parent decides what to do next (e.g., follow-up questions, new tasks, branch, or additional subagents).
What gets promoted?
Final Report / Answer: Curated output intended for the parent.
Generated File Handle: Stable reference to large or expensive artifacts.
Compact Memories: Bounded, policy-checked context for future turns.
Audit Trail (Optional): High-level trace for accountability (no raw data unless allowed).
What stays private?
Raw tool payloads
Scratch / intermediate state
Temporary artifacts
All internal tool activity
Only promoted outputs cross the boundary.
Isolation Guarantees
No raw data leakage: Parent never sees raw tool payloads or scratch state.
Least-privilege promotion: Only explicit, policy-approved outputs are shared.
Bounded lifetime: Subagent state is discarded after completion.
Clean parent context: Parent resumes with only promoted, relevant context.
Auditability preserved: Policy decisions and summaries are recorded for traceability.
4.15 保留与垃圾回收
持久化产物带来存储责任。该架构并非意味着“永久存储一切”,而是让保留规则明确化。
保留模型必须平衡可审计性和隐私。原始产物可按策略保留、归档、脱敏、哈希、存储到独立位置或删除。采样的 contextAssemblyLogs 应积极裁剪。账户删除必须清理产物、记忆和组装日志。仅供审计的产物应留在普通模型上下文之外。存储载荷只有通过隐私和字节预算检查后才能还原。生成文件和文档引用需要在清理时保全引用关系,避免有效引用和文件句柄失效。
这也是该架构最适用于严肃工具工作的原因之一。
保留原始证据能改善恢复和审计,但也增加了分类、加密、访问控制、删除和提供商路由管理的负担。
5. 架构分析
5.1 Token 成本模型
采用对话记录回放时,大量使用工具的对话,其面向模型的成本近似为:
conversation_window + historical_tool_calls + historical_tool_results + summaries + retry_state
采用基于图的上下文组装时,成本近似为:
conversation_window + selected_tool_memories + protected_recovery_state + selected_skill_state + optional_raw_rehydration
关键区别在于,哪些内容随历史工具量增长。对话记录回放中,旧工具载荷可能一直留在回放路径,直到被裁剪或摘要。在此架构中,原始产物单独保留,只有精简记忆、受保护的未解决状态,或显式还原的证据进入模型上下文。
这就是该架构在成本方面的核心。
5.2 原始产物与精简记忆
原始产物与记忆的分离形成两层。证据层包含完整参数、原始输出、错误、哈希值、存储句柄、溯源和运行时元数据。上下文层包含精简摘要、结构化事实、生成文件句柄、过时标记、置信度元数据和重新验证提示。
这使系统能够在不丢失可审计性的情况下缩小上下文。摘要可以便宜且有用,但不应是唯一留存记录。
5.3 作为缓存与审计边界的 ContextAssembly
上下文组装在存储状态和提供商请求序列化之间建立稳定边界。运行环境可以改变消息序列化方式,但组装记录仍捕获选中了哪些图引用,以及由哪个策略版本选择。
架构的目标是按策略版本实现可复现,而非永久逐字节相同地回放。这意味着,同一策略版本作用于同一图快照,应选择相同的产物集、记忆集、受保护原始状态和策略决策。它不保证相同的分词,也不保证非确定性提供商产生相同的实时模型输出。
5.4 参与者范围的上下文
在多模型聊天中,共享对话记录与共享运行时状态是两回事。
如果两个模型回答同一用户提示词,用户可能并排看到两者最终输出。这不代表模型 A 的私有工作笔记、工具错误或通过 OAuth 获取的原始载荷,应对模型 B 可见。
该架构通过可见范围和运行时隔离策略明确这种区别。
这在评估上具有明显优势。可以按层分解失败:记录是否分支可见、参与者私有、仅供审计、已提升、已过时、被提供商/隐私策略省略,或因需要精确证据而还原。
5.5 作为图查询的上下文组装
该架构将上下文组装定义为运行时实体上的图查询,受当前分支谱系、参与者可见性、运行时隔离、隐私分类、提升策略、时效策略、置信度溯源、矛盾与替代、续接状态、重试/恢复保护、上下文预算和原始还原边界约束。
因此,“GraphRAG”不是合适的主要表述。GraphRAG 通常检索领域知识或文档关系,而运行时图还包括执行状态、策略、参与者、分支、产物、记忆和上下文组装。
运行时图比知识图谱更广。
5.6 确定性与可复现性
架构的目标是按策略版本实现可复现,而非永久逐字节相同地回放提示词。
这种区别很重要。提供商 SDK 可能改变序列化,OpenRouter 路由可能改变自动路由背后的模型,各提供商分词可能不同,即使输入完全相同,实时模型调用也可能不确定。
可复现目标更窄,也更有用。同一策略版本作用于同一图快照,应选择相同的产物集、记忆集、受保护原始状态和策略决策。隐私、提供商路由、分支范围、重试和续接决策,应能从存储状态解释。先前的上下文组装,应能为审计/调试流程实质性重建。无害的格式变化不应破坏语义上的可审计性。
因此,policyVersion、assemblerVersion、所选引用、省略摘要和耗时字段都很重要。它们定义了运行时状态与提供商消息序列化之间的边界。
5.7 为何这不只是更大的上下文
大上下文窗口有帮助,但解决不了架构问题。
更大的窗口可以容纳更多过时证据、私有临时状态、同级分支噪声、旧工具错误和通过 OAuth 获取的原始载荷。它能推迟裁剪变得明显的时间,却不会决定哪些内容值得纳入。
该架构并非反对大上下文模型,而是主张有意填充上下文窗口。任务需要时,组装器仍可使用大窗口。区别在于,原始产物、精简记忆、恢复状态和策略约束,通过明确规则竞争位置,而非靠时间顺序留存。
6. 既有技术比较
该架构承接了上下文工程、图运行环境、记忆、溯源和审计方面的重要工作。
- 上下文工程已成为主流智能体设计概念。Anthropic、Haystack、Atlan 等都主张,应从指令、历史、检索数据、工具、记忆和任务状态显式组装模型上下文,而非将其视为一条提示词字符串。
- LangGraph 在图状态、线程、检查点、快照、回放和持久执行模式上,有很强的先例。
- 智能体记忆系统区分短期、长期、情景、语义、程序性和工作记忆。
- MCP 与工具使用框架,让工具明确可见且可记录。
- 事件溯源和审计轨迹文献,支持仅追加执行记录和可重建历史。
- MemORAI 和 Portable Agent Memory 等具备溯源能力的记忆研究,指向与来源关联的记忆。
- 提示词注入、记忆投毒、跨会话泄露和具备溯源能力的工具安全研究,支持更严格的策略边界。
NanthAI 的贡献,是将这些逐渐汇合的模式整合为一套运行时约定:持久化工具产物、精简工具记忆、溯源、参与者归属、感知分支的图组装、策略决策,以及对话记录与上下文的分离。
整合就是重点。它将一组有用技术转化为适合大量使用工具的智能体的严谨运行时模型。
6.1 哪些看起来已经标准化
几项思想已经或接近成为标准:短期和长期记忆,压缩旧上下文,在后续轮次使用工具输出,为智能体状态建立检查点,将检索/工具/用户内容视为可能不可信,显式管理模型上下文而非仅编写提示词,以及为调试和可观测性存储日志。
6.2 哪些看起来正在形成
另一些思想已见于文献和严肃框架,但尚未定型:具备溯源能力的智能体记忆、过时记忆检测、矛盾与替代处理、可移植记忆对象、从精简记忆还原原始产物、针对提供商零保留约束的第一方状态存储、受策略约束的上下文组装,以及作为攻击面的记忆。
该架构与这一方向一致,同时赋予这些思想一套具体的产品运行时约定。
6.3 哪些看起来缺乏充分记录
更有意思的思想范围更窄:将 ContextAssembly 作为独立持久化记录,将 PolicyDecision 关联到每次生成,将持久化原始 ToolArtifact 与精简 ToolMemory 分开,多模型聊天中的参与者私有运行时状态,在提升前保持私有的子智能体产物,沿对话谱系感知分支的上下文组装,观察与记忆之间的提升语义,以及运行时认知与用户对话记录的分离。
我认为这是该架构最有用的地方,不是因为每个字段单独看都出人意料,而是它们的组合为运行环境提供了一套术语,让原本隐含的决策得以表达。
6.4 最接近的先例
最接近的框架先例是 LangGraph:图状态、线程、检查点、回放、时间旅行和持久执行模式,都与该运行环境的方向高度一致。区别在范围。该架构不只有图执行,还将工具产物、精简记忆、参与者可见性、分支谱系、上下文组装和策略决策作为独立记录。
Portable Agent Memory 和 MemORAI 在记忆溯源方面很接近。它们支持记忆应携带来源链接和完整性元数据的观点。该架构将这一逻辑应用于工具产物和生成上下文,而不只是可移植记忆对象。
事件溯源工作在审计和回放方面接近,支持仅追加事件历史和可重建执行。该架构需要这种时间历史,也需要分支、参与者、产物、记忆和策略之间的图关系。
ARGUS 及相关的溯源感知安全工作,在安全方面接近。它们认为工具决策受先前上下文影响,并利用溯源分析不安全操作。该架构推广了这一思路:溯源不仅应影响安全检查,也应影响普通上下文纳入、还原、矛盾处理和审计。
MCP 与此相关,因为它让工具调用和上下文来源明确。但 MCP 是集成协议,不是保留、溯源、分支、参与者或上下文组装策略。
6.5 ZDR 与第一方状态
零数据保留和提供商侧不保留约束,让对话记录与上下文的分离更重要。
如果提供商侧持久化不可用,或不希望使用,应用所有者仍需内部审计记录、恢复状态、生成文件引用、工具调用溯源、参与者可见性决策、删除和保留策略,以及重建模型所见内容的方法。
这将状态所有权推回产品运行环境。提供商成为执行端点,应用负责决定每次请求中保留什么、脱敏什么、省略什么、发送什么。
该架构符合这种模型。它不依赖提供商管理的线程作为持久事实来源。后台保留自己的图状态,并据此组装提供商请求。
7. 策略复杂性及其管理
主要工程挑战在于,受策略约束的组装引入了一个必须设计、测试和观察的决策层。
对话记录回放很容易理解。消息在窗口里,模型就能看到;被裁剪了,模型就看不到。
受策略约束的上下文组装更强大,而这种能力需要防护。策略层必须防止有用证据被省略、过时记忆被纳入、私有状态泄露、重试必需错误被隐藏、原始还原过多、精确证据恢复不足、分支谱系出错、过度信任模型派生摘要、图查询延迟过高,以及审计能力流于表面。
这是核心取舍。架构用明确策略替代偶然的对话记录继承。只有当策略可测试、可观察且有边界时,这样做才更好。
当工具工作流长期运行或产物密集,原始工具证据重要,隐私或提供商约束重要,分支、子智能体或多模型运行常见,过时事实可能造成真实错误,可审计性有价值,且上下文成本重要时,该架构最有用。
当对话很短、工具很少、输出无需审计、所有状态都可安全共享、后续从不需要精确证据,或工程资源无法支持策略测试和遥测时,其相关性较低。
对简单聊天机器人,对话记录回放可能足够。对大量使用工具的智能体工作空间,复杂性本就存在,这种架构让它变得明确且可测试。
8. 风险与失败模式
R1:策略缺陷
组装器可能省略必要证据,或纳入禁止的上下文。
缓解措施:确定性场景测试、省略摘要、策略版本管理、前后对比评判,以及采样组装日志。
R2:存储增长
原始产物可能快速增长,尤其涉及文件、API 载荷、stdout/stderr 和生成输出时。
缓解措施:保留类别、垃圾回收资格、账户删除清理、存储句柄、哈希,以及仅供审计的保留策略。
R3:隐私与提供商泄露
已存储产物可能包含通过 OAuth 获取的数据、Google 数据、文档数据、运行文件,或涉及密钥等敏感信息的载荷。
缓解措施:隐私分类、提供商路由策略、原始还原检查、仅含元数据的摘要,以及检查无法通过时默认省略。
R4:精简记忆带来的错误信心
摘要可能错误、过时或不完整。
缓解措施:置信度来源、溯源定位信息、时效类别、矛盾链接、局限说明,以及原始还原路径。
R5:记忆过时
模型可能把旧外部观察当作当前事实。
缓解措施:observedAt、staleAfter、时效类别、重新验证工具、过时标记和省略策略。
R6:分支污染
同级分支产物可能挤占当前分支状态。
缓解措施:当前分支谱系查询、明确的对话/共享可见性,以及分支排除遥测。
R7:参与者间泄露
一个模型参与者可能看到另一个参与者的私有工具状态。
缓解措施:所属参与者 ID、所属模型运行 ID、可见范围、运行时隔离策略、共享对象列表和提升决策。
R8:延迟偏移
图查询、溯源修复和存储还原可能变得昂贵。
缓解措施:有界候选池、策略选择后的两遍还原、耗时遥测、修复尝试次数限制和延迟检查。
R9:夸大持久性
产物和检查点有助于恢复和审计,但不等同于完整的分布式持久执行。
缓解措施:准确措辞、必要时保证幂等、续接检查点、重试约定,以及通过外部编排提供更强的工作流保证。
R10:省略问题的可调试性
模型失败可能源于相关状态被省略,而非错误状态被纳入。
缓解措施:排除原因计数、确定性详细轨迹、分支排除遥测、采样组装日志,以及同时检查候选记录和所选记录的审计/调试查询。
R11:提升偏移
提取器逻辑可能将过多内容提升为持久记忆,或将过少内容提升为模型可见记忆。
缓解措施:明确的 promotionPolicy、提取器测试、置信度溯源、隐私降级规则,以及记忆未被提升时的原始产物恢复。
R12:还原滥用
原始还原可能成为大型或敏感载荷进入提供商上下文的隐蔽路径。
缓解措施:两遍选择、存储读取前的隐私检查、字节预算、提供商路由检查,以及对 OAuth/Google/涉及密钥等敏感信息的数据,在检查无法通过时默认省略。
9. 实现测量
完整行为验证需要更广泛的基准测试,但有些主张可以直接从当前 NanthAI:Edge 实现中评估。具体来说,代码库允许针对工具调用密集的固定场景,比较旧式对话记录回放上下文与组装后的图上下文。
这些测量量化了论证中节省上下文的一面:用精简记忆、选定图上下文、隐私/归属筛选和受保护的未解决原始状态,替代旧工具载荷时,可以减少多少面向模型的提示词材料。
比较方式很简单。旧方式使用带原始工具载荷噪声的对话记录和工具消息回放。组装方式使用精简工具记忆、选定图上下文、隐私与归属筛选,以及受保护的未解决原始工具状态。
这些是实现测量,不是公开基准测试,也不声称普遍提高任务成功率。
9.1 提示词上下文缩减
在测试的实时对比场景中,提示词 token 数差值均显著为负。
- 延后处理的文档选择器上下文从 1020 降至 142 个 token,减少 86.1%。
- 多工具文件生成从 1905 降至 221 个 token,减少 88.4%。
- 过时的已连接应用记忆从 1051 降至 145 个 token,减少 86.2%。
- 多技能运行时状态从 1008 降至 179 个 token,减少 82.2%。
- 参与者可见性从 961 降至 161 个 token,减少 83.2%。
- 矛盾与替代从 1986 降至 197 个 token,减少 90.1%。
这支持架构关于节省上下文的第一项主张:已成功完成的旧工具轮次,不必作为原始对话记录负担留在回放路径。它们可以变成关联溯源的精简记忆,同时让原始证据在提示词之外保持可恢复。
9.2 恢复与溯源的保全
只有重要状态未丢失时,减少 token 才有价值。因此,测试场景包括恢复、溯源、隐私、分支和参与者边界情况:延后文档选择器状态、生成文件、过时的已连接应用记忆、多技能运行时状态、参与者可见性、矛盾与替代、损坏溯源修复、精确原始 CSV 还原、分支隔离、重试必需错误、Google 数据隐私省略、子智能体续接状态、自主讨论归因、子智能体产物捕获、父智能体恢复元数据、定时任务兼容性和分支发送兼容性。
组装路径在对话记录回放存在结构性弱点的地方改善了行为。它阻止参与者私有工作笔记状态外泄,修复溯源而非虚构替代 ID,选择当前分支状态,保留重试必需错误,按策略要求省略 Google 原始正文,并在策略允许时恢复精确原始产物。
9.3 运行模式覆盖
同一架构必须跨生成模式运作,而不只适用于简单聊天循环。普通聊天轮次、多模型轮次、自主讨论、子智能体运行、父智能体恢复、定时任务和分支发送,都有不同上下文边界。
实现带来的重要经验是,图组装必须在这些边界接受测试。子智能体状态在提升前应保持私有,父智能体恢复应使用确定性检查点,自主讨论应保留发言者标签和主持人指令,分支发送应继承当前谱系,同时不引入同级分支产物。
这正是图模型最重要的地方。图不只减少 token,还为运行环境提供术语,用于决定哪些状态属于哪种生成模式。
9.4 内部验证显示了什么
内部验证分两层。
- 确定性层检查组装策略是否保留不可缺少的运行时状态。原始工具产物在消息级截断前持久化。未解决、延后处理、失败和重试必需的工具状态保持对模型可见。参与者私有状态不向同级参与者提供。过时记忆被标记或省略,而非悄然视为当前事实。已被替代记忆被省略,当前替代记忆仍可选择。损坏溯源被修复或标为过时,不虚构替代 ID。分支内产物和记忆从当前谱系中选择,而非从近期同级分支选择。受隐私限制的原始载荷被省略,安全摘要和重新验证提示仍可用。
- 实时对比层随后用两种形式表示同一场景:旧式对话记录回放和组装后的图上下文。组装路径在显著减少提示词呈现量的同时,保留了所需恢复/溯源事实。
在上述测量的实时场景中,缩减幅度为 82.2% 至 90.1%。
9.5 解读
这些测量验证了所测实现场景中的上下文缩减前提。它们表明,NanthAI:Edge 的组装路径可以显著减少历史工具载荷的默认回放、私有参与者临时状态的暴露、将过时已连接应用状态当作当前事实、同级路径造成的分支污染、重试必需工具状态的丢失,以及定位信息损坏时虚构溯源等问题。
测量回答了一个问题:
在所测场景中,受策略约束的上下文组装,能否在保留重要恢复和溯源状态的同时,减少面向模型的上下文呈现量?
答案是能。
10. 讨论
我从该架构提炼的模式是:将对话记录保留为面向人的历史,在截断前存储原始工具产物,从产物而非松散摘要派生精简记忆,保留回溯原始证据的溯源关系,跟踪时效和替代,按参与者和分支划分运行时状态,通过策略而非消息年龄组装模型上下文,记录足够的组装决策以解释发生了什么,仅在需要且允许精确证据时还原原始产物,并将运行时认知留在用户体验之外,除非用户请求审计视图。
这才是真正的架构。
对实现团队,实践规则同样直接。选择图候选项之前,先确定一套不可变组装策略。先获取当前分支谱系,再用共享或对话范围候选项填充。存储中的原始载荷只有被隐私和预算策略选中后才还原。子智能体状态在显式提升前,视为私有或仅供审计。不仅记录纳入了什么,也记录为何省略。
不是“长期记忆”,不是“GraphRAG”,也不是“更大的上下文窗口”。
而是一个受策略约束的运行环境,决定什么值得进入下一次模型调用。
这带来几项影响:
- 上下文组装成为运行时基本能力。 应像其他关键后台约定一样接受测试和版本管理。
- 记忆变得有据可查。 缺乏溯源、时效和置信度元数据的记忆,不足以支撑严肃工具工作流。
- 工具输出不再是对话记录负担。 原始产物可为恢复和审计保留,无需永久回放。
- 参与者边界变得明确。 多模型和子智能体系统需要区分可见输出与私有运行时状态。
- 分支成为结构的一部分。 分支不只是界面导航,它约束哪些产物和记忆应影响下一次模型调用。
- 审计从日志转向解释。 目标不只是存储事件,还要重建模型为何看到特定上下文。
这正是我们在 NanthAI:Edge 中推进的方向:智能体历史应持久保存,而非盲目回放;模型上下文应从受策略约束的图状态组装,而非继承消息顺序。
11. 结论
行业正在从聊天机器人走向使用工具的智能体,这改变了状态问题。聊天机器人往往可以只靠对话记录回放运作。
一个会写文件、读文档、调用 API、搜索网页、创建子智能体、运行定时任务、分支对话并比较模型的智能体,不能将对话记录视为整个运行环境。
对话记录是一种投影,必要却不完整。模型需要上下文,用户需要历史。
系统需要证据,审计者需要溯源,重试循环需要恢复状态,隐私层需要策略。
产品需要让这些内容共存,同时避免每次模型请求都变成旧工具载荷的堆放场。
这正是该架构所做的:赋予智能体历史一种持久的运行时形态,同时避免未来的每次模型请求都回放旧工具载荷。
智能体能力不应与提示词大小线性增长。
智能体历史不应与对话记录回放量线性增长。
下一层是受策略约束的上下文组装。
参考文献
- Anthropic. Effective context engineering for AI agents. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Haystack. Context engineering. https://haystack.deepset.ai/blog/context-engineering
- Atlan. How to structure context for LLM applications. https://atlan.com/know/how-to-structure-context-for-llm-applications/
- LangGraph. Persistence. https://docs.langchain.com/oss/python/langgraph/persistence
- LangGraph. Durable execution. https://docs.langchain.com/oss/python/langgraph/durable-execution
- LangGraph. Add memory. https://docs.langchain.com/oss/python/langgraph/add-memory
- Databricks. Memory scaling for AI agents. https://www.databricks.com/blog/memory-scaling-ai-agents
- Google Cloud. What is Model Context Protocol? https://cloud.google.com/discover/what-is-model-context-protocol
- Portable Agent Memory. https://arxiv.org/html/2605.11032v1
- MemORAI. https://arxiv.org/html/2605.01386v1
- ESAA: Event Sourcing for Autonomous Agents in LLM-Based Systems. https://arxiv.org/abs/2602.23193
- Audit Trails for Accountability in Large Language Models. https://arxiv.org/html/2601.20727v1
- STALE. https://arxiv.org/html/2605.06527v1
- Evaluating the Long-Term Memory of Large Language Models. https://aclanthology.org/2025.findings-acl.1014/
- OWASP Agent Memory Guard. https://owasp.org/www-project-agent-memory-guard/
- OWASP. LLM Prompt Injection Prevention Cheat Sheet. https://cheatsheetseries.owasp.org/cheatsheets/LLM_Prompt_Injection_Prevention_Cheat_Sheet.html
- ARGUS. https://arxiv.org/html/2605.11053v1
- Beyond RAG for Agent Memory. https://arxiv.org/html/2602.02007v2
- LongMemEval-V2. https://arxiv.org/html/2605.12493v1
- Agentic Memory. https://arxiv.org/html/2601.01885v2
- Governing Evolving Memory in LLM Agents. https://arxiv.org/html/2603.11768v1
- Giskard. Cross-session leak: when your AI assistant becomes a data breach. https://www.giskard.ai/knowledge/cross-session-leak-when-your-ai-assistant-becomes-a-data-breach
- Unit42. Indirect prompt injection poisons AI long-term memory. https://unit42.paloaltonetworks.com/indirect-prompt-injection-poisons-ai-longterm-memory/
- Diagrid. Checkpoints are not durable execution. https://www.diagrid.io/blog/checkpoints-are-not-durable-execution-why-langgraph-crewai-google-adk-and-others-fall-short-for-production-agent-workflows
- Zero Data Retention in LLM-based Enterprise AI Assistants. https://arxiv.org/abs/2510.11558
亦发表于 LinkedIn.