NanthAI:Edgeの技術事例研究です。
ツールを使うAIエージェントの多くは、履歴の増やし方を誤っています。すべてのツール呼び出し、ツール結果、生成ファイル、再試行、要約、エラー、継続処理を、切り詰められ、圧縮され、あるいは失われるまで、表示用のチャットログを通じて繰り返し送り返します。
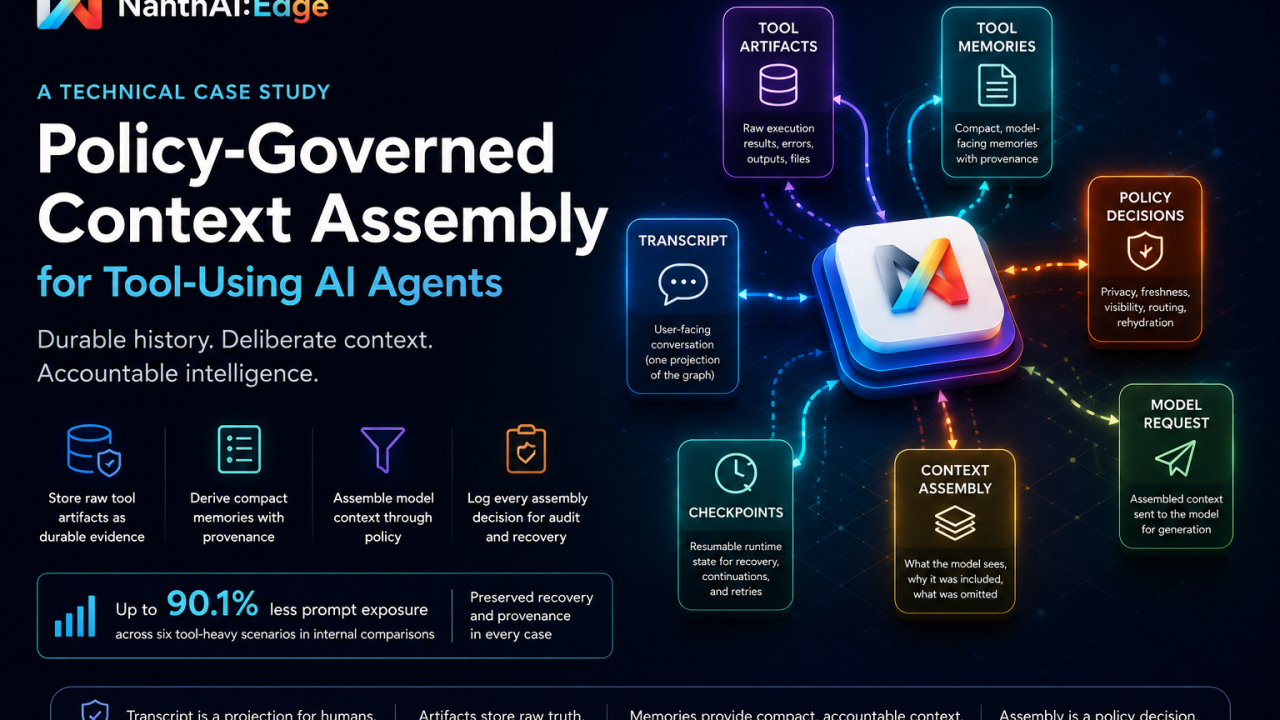
NanthAI:Edgeでは、これは単なる理論ではありません。内部の比較テストで、組み立てたグラフコンテキストは、複数ツールによるファイル生成のワークフローで、プロンプトに提示する量を1905トークンから221トークンに削減し、矛盾と置換のワークフローでは1986トークンから197トークンに、保留された文書選択のワークフローでは1020トークンから142トークンに削減しました。タスクの成功率向上を証明するものではありませんが、復旧と来歴の状態を保持しながら、モデルに提示するコンテキストの範囲を実質的に小さくできることは証明しています。
AIエージェントを構築する最も簡単な方法は、今も、チャットに追記し続けることです。
ユーザーが質問し、モデルがツールを呼び、ツールが結果を返し、それが会話に入ります。モデルが別のツールを呼び、また結果が追記されます。エージェントはファイルを書き、エラーに遭遇し、再試行し、要約し、分岐し、後から再開し、ときにはサブエージェントを生成します。そして会話ログは増え続けます。
最初は自然に感じられます。会話ログは目の前にあり、順序があり、読めます。記憶のように見えます。しかし、ツールを使うエージェントにとって、会話ログは罠です。
会話ログは、ユーザーが読めるべきものです。次にモデルが見るべきものと同じではありません。エージェントがツールを動かし、ファイルを扱い、APIを呼び、複数のブランチで作業し、モデルを比較し、非公開のランタイム状態を持つようになると、表示用のチャットログは信頼できる基準として不適切になります。製品のUX、根拠、メモリ、再試行の状態、プライバシーの境界、古い観測、監査記録が、1つの時系列の流れに混在するからです。
よりよいパターンは、会話ログを、より豊かなランタイムグラフの1つの投影として扱うことです。ツールの生の出力は、永続的なアーティファクトとして保存します。そこからコンパクトなメモリを導出します。来歴によってメモリを根拠に結び付けます。ブランチ、参加者、モデル実行、ツール呼び出し、チェックポイント、ポリシー判断は、それぞれ独立したエンティティです。各モデルリクエストは、過去のチャットメッセージの無条件な再送ではなく、グラフからポリシーに基づいて組み立てたコンテキストを受け取ります。
本記事が提唱するのは、このアーキテクチャです。「メモリを増やす」「コンテキストウィンドウを大きくするだけ」「何にでもGraphRAGを使う」という話ではありません。主張は、より具体的です。エージェントの履歴は、永久に再送せずとも永続化されるべきであり、モデルのコンテキストは、メッセージの順番から引き継ぐのではなく、意図的に組み立てるべきです。
要旨
ツールを使う大規模言語モデル(LLM)エージェントには、会話履歴、ランタイムの状態、ツールの根拠、メモリ、プライバシー、コンテキストの効率の間に構造的な緊張関係があります。一般的な実装では、表示用の会話ログを、ユーザー向けの履歴とモデル向けのコンテキストの両方として扱います。過去のメッセージ、ツール呼び出し、ツール結果、要約、エラー、生成アーティファクトが、切り詰められ、圧縮され、あるいは失われるまで後のリクエストに再送されます。単純な方法ですが、ユーザー体験とランタイムの認知処理を結び付け、コンテキストの選択をメッセージ順序の偶然の副産物にしてしまいます。
本記事では、ポリシーに基づくコンテキストの組み立てという設計パターンを展開します。会話ログをモデルの正規の情報源ではなく、より豊かなランタイムグラフの1つの投影として扱います。ランタイムは、生のツールアーティファクトをコンパクトなツールメモリと分けて保存し、導出したメモリから元の根拠への来歴を保持し、参加者とブランチの所有関係を追跡し、コンテキストを組み立てた判断を明示的なポリシーバージョンの下で記録します。
本記事は、コンテキストエンジニアリング、エージェントメモリ、グラフの状態、イベントソーシング、来歴を考慮したメモリ、古いメモリによる失敗、プロンプトインジェクション、エージェントの監査証跡に関する先行研究と対比して、このパターンを位置付けます。そのうえで、実装例の1つとしてNanthAI:Edgeを取り上げます。
本記事は、最も重要な貢献は、統合されたランタイムの契約にあると主張します。永続的なツールアーティファクト、コンパクトなツールメモリ、独立した主要要素としてのコンテキスト組み立て、ポリシー判断、参加者単位のランタイム所有関係、ブランチを考慮したグラフの選択、鮮度と置換のポリシー、生のアーティファクトの復元、ランタイムの認知処理とユーザーに見える会話ログとの意図的な境界です。
貢献は、ツールを使うエージェントで会話ログとコンテキストを分離する概念的な枠組み、NanthAI:Edgeの永続的なアーティファクトとコンテキスト組み立ての実装に即した分析、コンテキストエンジニアリングとグラフランタイムの先行技術との比較、ポリシー層のリスク一覧、内部の比較シナリオによる実装の測定です。
1. はじめに
前回のNanthAIの記事では、ツールアクセスへのゲートとしてスキルを使う方法を書きました。問題は、機能の肥大化でした。エージェントにワークフロー、連携、専門分野の指示が加わるにつれ、素朴な方法では、毎回のリクエストにプロンプトの文章とツールのスキーマを足し続けます。NanthAI:Edgeは、まずコンパクトなスキルカタログを提示し、タスク上の理由があるときにだけ指示全文を読み込み、実行可能なツールレジストリを拡張することで、これを避けます。これはコンテキストの問題の半分を解決します。もう半分は、ツールの実行後に現れます。
ツール呼び出しは、検索結果、ファイル、引用、APIペイロード、OAuth由来のデータ、エラー、部分的な出力、再試行の状態、生成アーティファクト、非公開の作業状態、古い外部観測、サブエージェントの状態、継続のチェックポイントを生みます。ランタイムがそれらを表示用のチャットログを通じて再送し続けると、モデルのコンテキストは高くつき、雑多になり、ときには誤ったものになります。
ここには、関連する2つの問題があります。
- 会話ログの肥大化は、過去のツール呼び出し、ツール結果、生成アーティファクト、要約、再試行、運用状態が会話履歴に蓄積し、繰り返しモデルに渡されるときに起きます。
- ランタイム状態の曖昧さは、会話ログに、ユーザー向けの履歴、モデルのメモリ、監査証跡、再試行の状態、プライバシーの境界、ツールの根拠の保存先という役割を同時に担わせるときに起きます。
どちらも高くつきます。入力トークンを消費し、遅延と費用を増やし、プロバイダーのルーティングを複雑にし、回答生成時にモデルが実際に何を知っていたか分かりにくくします。
さらに、正しさを損なう可能性があります。モデルが古いツール出力を現在の事実として見るかもしれません。再試行に不可欠なエラーが要約で消えるかもしれません。兄弟ブランチで生成したファイルを別のブランチが引き継ぐかもしれません。ある参加者の非公開の作業メモが、別のモデルのコンテキストに漏れるかもしれません。コンパクトな要約から、後の監査や復元に必要な正確な値が失われるかもしれません。
本記事では、構造化された代替案として、ランタイムグラフに対するポリシーに基づくコンテキストの組み立てを検討します。
パターンは単純です。会話ログを人向けの履歴として扱い、生のツールアーティファクトをメッセージと分けて保存し、アーティファクトからコンパクトなツールメモリを導出し、メモリから生の根拠への来歴を保持し、明示的なポリシーの下でグラフの状態から各モデルリクエストを組み立て、モデルが何を、なぜ見たか説明できるだけの判断を記録します。
NanthAI:Edgeでは、このアーキテクチャを動かすために、ユーザー向けのチャットUIを変える必要はありませんでした。ユーザーには引き続き、メッセージ、ツールのカード、生成ファイル、引用、ブランチ、再試行、継続処理、モデルの応答が表示されます。その裏で、ランタイムは会話ログ、アーティファクト、メモリ、ポリシー判断、コンテキストの組み立てを分離しています。
同じ境界は、ランタイムモードをまたいで適用されます。通常のチャットターン、マルチモデル比較、自律的な議論、子サブエージェントの実行、サブエージェント実行後の親の再開、スケジュールジョブ、ブランチからの送信は、すべて同じコンテキスト契約ではありません。討論形式の自律的な議論では、発言者のラベルと司会者の指示を保持する必要があります。子サブエージェントは、デフォルトで生のワークスペース状態を親に漏らしてはいけません。親の再開では、会話ログを無条件に検索せず、決定的なチェックポイントに従うべきです。コンテキストの組み立ては、ランタイムモードを考慮しなければなりません。
本記事では、会話ログ、コンテキスト、アーティファクト、メモリ、ポリシーを分ける用語体系、永続的なツールアーティファクトとコンパクトなツールメモリの具体的なアーキテクチャ、マルチモデルとサブエージェントのワークフローにおける参加者単位のランタイム状態の分析、先行技術との比較、実装の測定値と限界の解釈を示します。
TRANSCRIPT PROJECTION (User-Facing UI)
Ordered messages · Tool cards (truncated) · Generated files · Citations · Branches · Model responses
One projection of the same runtime graph
RUNTIME GRAPH (Durable State)
- MESSAGE (User/Assistant): User prompts; Assistant prose; Tool call / result messages (truncated for UI); Visible transcript
- MODEL RUN (Generation Attempt): Provider; Model & parameters; Participant; Message / Job ownership; Runtime mode
- TOOL CALL (Requested): Tool name; Arguments; Call ID; Status (requested / pending / failed); Model run linkage
- TOOL ARTIFACT (Raw Execution): Full arguments; Raw result or error; Status, timing; Tool version; Privacy classification; Storage handles; Hashes / byte size
- TOOL MEMORY (Compact, Model-Facing): Summary / structured data; Source artifact ID(s); Confidence + source; Freshness & stale-after; Provenance locators; Contradictions / supersession; Revalidation tools
- CONTEXT ASSEMBLY (Policy-Governed): Policy version; Assembler version; Selected memories; Rehydrated artifacts; Legacy vs assembled tokens; Omission summaries; Timing & telemetry
- MODEL REQUEST (Provider Prompt): System / instructions; Selected messages; Selected memories; Rehydrated raw (if any); Skill state; Recovery state; Provider + settings
KEY RELATIONSHIPS
Primary execution flow →
Artifacts produced by calls
Memories derived from artifacts
Policy selection & assembly
UI projection (readable view)
WHAT HAPPENS WHERE
ToolCall → ToolArtifact: Execute the tool and capture raw evidence.
ToolArtifact → ToolMemory: Extract, summarize, classify, link provenance.
ToolMemory → ContextAssembly: Policy decides what to include.
ContextAssembly → Model Request: Serialize the selected context.
Transcript Projection: Human-readable view, not the source of truth.
POLICY CONSIDERS
Ownership (participant / model run / branch)
Visibility (private / branch / conversation / audit)
Privacy & provider-routing constraints
Freshness, staleness, revalidation needs
Promotion, contradiction, supersession
Recovery state & retry protection
Context budget & raw rehydration bounds
Retention, deletion, and safety rules
OUTCOME
The model sees a deliberate, policy-governed context assembled from durable runtime state — not a blind replay of the transcript.
Smaller context. Better signal. Preserved evidence. Clear auditability.
Core Principle: Transcript is a projection for humans. Artifacts are raw truth. Memories provide compact, accountable context. Assembly is a policy decision.
2. 背景:コンテキストエンジニアリング、メモリ、ツールの状態
2.1 コンテキストエンジニアリング
コンテキストエンジニアリングは、モデルのコンテキストに入れる情報を決める実践です。プロンプトを書くことより広い概念で、システムの指示、会話履歴、取得した根拠、ツール出力、メモリ、ポリシー、タスクの状態、形式を含みます。
現代のコンテキストエンジニアリングの指針は、モデルのコンテキストを生の会話ログとして扱わず、明示的に組み立てるべきだという考えを支持しています。Anthropicは、エージェントに与える情報を管理する作業と説明しています。HaystackやAtlanも、指示、履歴、検索、ツール出力、メモリなど、構造化された領域としてコンテキストを説明しています。
コンテキストの種類ごとに寿命と信頼上の性質が異なるため、この区別は重要です。ユーザーのメッセージ、生成ファイルのID、OAuthペイロード、古い検索結果、再試行できるツールエラー、文書の引用を、同じルールで削減、要約、保持、提示するべきではありません。
会話ログは完全に見えるため、特に誤解を招きます。何かが起きたという時系列の根拠は含みますが、実際に起きたことの生の記録、それを許可したポリシー、それを所有するブランチ、それを見た参加者、後のターンでなお信用するべき理由まで含むとは限りません。単純なチャット製品なら、時系列でコンテキストを代用できるかもしれません。ツールを使うエージェントでは、時系列は1つの軸にすぎません。
そのため、このアーキテクチャでは、コンテキストを組み立てた投影として扱います。最近の会話ターン、選んだツールメモリ、未解決のツール状態、読み込み済みスキルの状態、プロバイダー/プライバシーの制約、選んだ生のアーティファクトを含められます。古い、非公開、置換済み、ブランチの対象外、予算超過、選んだプロバイダーに渡すのが安全でない、といったレコードは省略できます。含めるかどうかは判断であり、メッセージの古さから偶然決まるものではありません。
2.2 エージェントメモリ
エージェントメモリの研究では、一般に、作業記憶、エピソード記憶、意味記憶、手続き記憶、長期記憶を区別します。LangGraphなどのフレームワークは、短期記憶と長期記憶を分けています。LLMエージェントメモリの調査研究は、この分野がまだ断片的であることを強調しています。メモリの表現、来歴、鮮度、矛盾、保持について、フレームワークを横断する確立したスキーマはありません。
この断片化は重要です。「メモリ」は、ユーザーの好み、過去の会話から抽出した事実、古い対話の要約、ツールの観測、生成ファイルのハンドル、取得した文書、タスクの計画、実行トレース、来歴への参照など、多様なものを指す広い言葉として使われがちです。
このアーキテクチャは、ユーザーメモリとツールメモリを分離します。ユーザーメモリはパーソナライズを扱い、ツールメモリはツールアーティファクトから導出したランタイムの根拠を扱います。
この分離は、製品上の分類にとどまりません。チャットに現れたというだけで、ランタイムの観測が永続的なユーザーの事実になるのを防ぎます。ツールがSlackのスレッドを読めば、そのスレッドの状態について、有用で有効期間に限りのあるメモリを作れるかもしれません。しかし、恒久的なユーザーの好みにするべきではありません。文書生成ツールがファイルを作れば、ファイルハンドルは永続的な運用状態かもしれません。「ユーザーは簡潔な回答を好む」とは異なる種類のメモリです。
そのため、ツールメモリには、通常のパーソナライズ用メモリには不要なことが多い項目が必要です。アーティファクトID、元のツール名、プライバシークラス、鮮度クラス、来歴の参照位置、信頼度の根拠、修復の試行、矛盾のリンク、置換のリンク、昇格ポリシーです。このアーキテクチャでのメモリは、「モデルが覚えておきたそうなもの」ではありません。ランタイムが説明責任を持てる根拠を、ポリシーに従ってコンパクトに表現したものです。
2.3 状態としてのツールトレース
ツールを使うエージェントは、呼び出しのたびに状態を作ります。引数、結果、エラー、時刻、プロバイダー、ランタイム、有効なスキルの状態、所有関係のコンテキストは、いずれも後で重要になる可能性があります。
これは、産業界でも研究でも認識が広がっています。Databricksは、ツール呼び出しの軌跡と実行結果をエージェントの状態として論じています。LangGraphは、グラフの状態とチェックポイントを永続化します。MCPは、ツールとコンテキストの情報源を明示的にし、構造的に記録できるようにします。イベントソーシングの研究は、自律エージェントには再構成と監査を支える追記専用の記録が必要だと主張しています。
ここから導かれる重要な考えは、ツール結果を会話ログのメッセージだけに置くべきではない、ということです。メッセージは表示には有用ですが、生の根拠を保存する層としては弱いものです。
会話ログのメッセージは、通常、人の読みやすさとクライアントとの互換性に最適化されています。切り詰め、墨消し、要約、表示上の並べ替え、圧縮による除去が行われることがあります。それこそが製品UIに必要なことです。しかし、ユーザーが後から「前の正確なCSVを使って」と言ったり、監査で特定のファイルIDを引用した理由を尋ねられたりした際に、復旧システムが必要とするものではありません。
このアーキテクチャは、その表示向けの変換前にアーティファクトを記録します。メッセージには、引き続き整ったツールカードやコンパクトな結果を表示できます。アーティファクトの保存先には、復旧と監査に必要な生の引数、結果やエラー、ハッシュ、バイト数、ストレージハンドル、ランタイムの所有者、プライバシー分類、ツールのバージョン情報を保持します。
2.4 古いメモリと矛盾
永続的なメモリは、古くなった情報、矛盾した情報、置換済みの情報に、エージェントが依存し続けるという失敗をもたらします。STALEなどのベンチマークやLOCCOなどの研究は、長期記憶が自動的に信頼できるわけではないことを示しています。古い事実を現在の真実として扱えば、記憶を増やすことでシステムが悪化する場合があります。
これは、鮮度と置換の明示的なポリシーを支持します。Slackスレッドの要約、CRMのスナップショット、カレンダーの空き時間、生成ファイルのハンドル、不変の文書バージョンは、同じように古くなるべきではありません。
古いメモリの問題は、古い事実が誤りになることだけではありません。モデルは、有効期限の分かる印なしに受け取ることが多いのです。ランタイムがメッセージを再送するだけなら、6週間前のカレンダーの空き時間も、不変の文書バージョンIDも、ともに「以前のコンテキスト」として現れます。このアーキテクチャは、鮮度クラスと古くなる時点のメタデータで、その違いを明示します。
矛盾も、関連する失敗の形です。2つのメモリがどちらも実在するアーティファクトに由来していても、文書のバージョン、ブランチ、プロバイダー、抽出方法が異なるため、衝突する場合があります。その解決を正当化する十分な来歴と信頼度の情報がポリシーにない限り、単一の後勝ちの要約にまとめるべきではありません。
2.5 来歴と監査
来歴を考慮したメモリは、新たに注目されているテーマです。MemORAIはグラフのメモリを元のターンに結び付けます。Portable Agent Memoryは、来歴を検証したメモリオブジェクトを提案しています。ARGUSは、影響と来歴のグラフを使い、安全でないツール呼び出しを分析します。監査証跡とイベントソーシングの文献も、AIシステムにはデータ、モデル、ツール、判断のイベントを再構成できる履歴が必要だと主張しています。
エージェントランタイムにとって、監査上の重要な問いは次のものです。
なぜモデルはこう言ったのですか?
会話ログだけでは答えられません。どのコンテキストを組み立て、どのメモリを含め、どの生のアーティファクトを復元し、どのポリシーでデータを省略し、どの参加者やブランチが状態を所有したかを知る必要があります。同じくらい重要な、2つ目の問いもあります。
なぜモデルは、ある情報を見なかったのですか?
ここが、ポリシーに基づく組み立てと通常のログ記録の違いです。本番の障害は、悪いツール結果が原因とは限りません。有用な結果が、古い、予算超過、ブランチの対象外、別の参加者の非公開情報、Google由来データに分類された、生の情報の復元がブロックされた、といった理由で除外されたことが原因かもしれません。このアーキテクチャは、省略のコンパクトな要約を記録し、存在する情報だけでなく、不在の情報についてもデバッグで調べられるようにします。
3. ポリシーに基づくコンテキストの組み立て
ポリシーに基づくコンテキストの組み立ては、モデルのコンテキストを、ランタイムの状態に対する投影として扱います。会話ログを捨てるのではありません。人向けの履歴として残します。ただし、ランタイムのすべての責務を背負わせるのをやめます。
ランタイムは、会話ログのメッセージ、モデル実行、ツール呼び出し、生のツールアーティファクト、コンパクトなツールメモリ、読み込み済みスキルの状態、継続のチェックポイント、ブランチの系譜、参加者の所有関係、ポリシー判断、コンテキスト組み立てのログを区別します。コンテキストの組み立てを担う機構は、現在のタスク、ブランチ、参加者、プロバイダー、プライバシーポリシー、鮮度ポリシー、復旧状態に基づき、モデルに見せるものを選べます。
このパターンは、混同されがちな4つの領域を分離します。会話ログはユーザー向けで、読みやすく、安定し、製品に適しています。アーティファクトの保存先はランタイムと監査層向けで、生の根拠、復元可能性、保持ポリシーを担います。ツールメモリはモデルのコンテキスト向けで、コンパクトで、来歴と結び付き、鮮度を考慮します。コンテキストの組み立ては、モデルリクエストそのものに向けた、1回の生成のためのポリシーに基づく選択です。
最も重要な関係は、次のものです。
ツール実行はまずアーティファクトを作り、メモリはその上に重ねるポリシー判断です。
これが、アーキテクチャの概念的な核心です。2つ目の関係は、次のものです。
コンテキストの組み立ては、ポリシーで制約したグラフクエリであり、会話ログの変換ではありません。
組み立ては、有効な生成の境界から始めます。現在のチャット、元のユーザーメッセージ、ブランチの系譜、参加者、ランタイムの種類、継続の状態、選択したプロバイダー、読み込み済みスキル、利用できるツールです。次に、対象となるグラフのレコードを選び、それぞれをどう表示するか決めます。最近のメッセージは会話コンテキストのまま残せます。ツールの観測はコンパクトなメモリとして入れられます。古いレコードは、古いという印と再検証のヒントだけを示せます。正確な根拠が必要なら、生のアーティファクトを復元できます。未解決のツール呼び出しは、復旧状態として保護できます。非公開、古い、置換済み、ブランチの対象外、プロバイダーによる制限があるレコードは、内容を開示せずに理由を記録して省略できます。
この設計は、すべての取得操作をグラフデータベースで行う必要はありません。グラフとは、結び付いた会話、ブランチ、参加者、モデル実行、ツール呼び出し、アーティファクト、メモリ、チェックポイント、組み立て、ポリシー判断からなるランタイムモデルです。ベクトル検索、インデックス付きテーブルクエリ、ストレージの読み取り、グラフ走査は、いずれもそのモデルの実装手法になり得ます。
理解に役立つ捉え方は、次のものです。
ユーザーに見える会話ログ = 選択したMessageノードの読みやすい投影
モデル向けコンテキスト = Message + ToolMemory + ToolArtifact + SkillState + ContinuationCheckpoint + PolicyDecision + ブランチの系譜に対する、ポリシーで選んだ投影
この違いは、机上の話ではありません。会話ログは、「ユーザーとアシスタントは何と言ったように見えるか」に答えます。ランタイムグラフは、ログだけでは答えられない問いに答えます。どのモデル実行が回答を生成したか、どのツールを要求したか、それらがどのアーティファクトを生成したか、どのメモリをそこから導出したか、どのブランチと参加者が状態を所有したか、どのポリシーが各レコードを許可または省略したか、どの古いメモリが古くなり、矛盾し、置き換えられたか、という問いです。
これらの問いこそが、グラフ方式の価値を生みます。コンテキストの選択を、メッセージ一覧の切り詰め戦略から、型のある関係へのクエリに変えます。
実際には、グラフ方式には3つの役割があります。保持とプライバシーのポリシーに従って生のツールアーティファクトを会話ログの外に置き、根拠を保持します。通常のモデル呼び出し用に、有用なアーティファクトの内容をツールメモリにして、コンパクトで使えるコンテキストを作ります。そして、なぜ別の投影ではなく、この投影をモデルが見たかを記録し、選択を説明します。
グラフをユーザーに見せる必要はありません。ユーザーは会話を見ます。ランタイムはグラフで、次のモデル呼び出しが知るべきことを決めます。
TRADITIONAL TRANSCRIPT REPLAY
- Message
- Message
- Message
- Message
- LARGE PROMPT
Replays old tool calls and results
Includes stale, private, and noisy data
Loses important structure and provenance
Wasteful, expensive, error-prone
POLICY-GOVERNED ASSEMBLY
- RAW ARTIFACTS
- COMPACT MEMORIES
- SELECTED CONTEXT
- MODEL REQUEST
Keeps raw evidence out of the prompt
Includes only relevant, current, and allowed data
Preserves provenance and recovery state
Smaller, faster, safer, and more reliable
4. 実装パターン
本節では、NanthAI:Edgeに実装したパターンの具体的な形を説明します。会話ログをモデルのコンテキストの正規の情報源としなくなったとき、何が必要になるかを示すため、詳細が役立ちます。
4.1 ランタイムグラフのモデル
ランタイムグラフは、重要な概念を明示することから始まります。Conversationは、ユーザーが所有するチャットの入れ物です。Branchは、過去の共有履歴を継承する、会話グラフを通る順序付きの経路です。Participantは、実行時に有効なモデルまたはペルソナの構成です。Messageは、ユーザーに見える会話ログのノードです。ModelRunは、1つの参加者、メッセージ、ジョブに対する、プロバイダー向けの1回の生成試行です。
ツールの作業にも独自の用語を設けます。ToolCallは、引数と呼び出しIDを含む、モデルが要求した関数呼び出しです。ToolArtifactは、その呼び出しや結果の永続的な生の実行記録です。ToolMemoryは、1つ以上のアーティファクトから導出した、コンパクトなモデル向けメモリです。SkillStateは、実行から見える読み込み済みスキル、有効なプロファイル、直接使えるツール、連携の状態を記録します。ContinuationCheckpointは、アクションの境界をまたいで再開できるランタイム状態を保存します。
組み立ての層も明示します。ContextAssemblyは、モデル向けプロンプトの1回の組み立てについて、バージョンを持つ判断記録です。PolicyDecisionは、プライバシー、鮮度、削減、復元、プロバイダーのルーティング、復旧の判断を記録します。
基本となる関係は単純です。
- アシスタントの会話ログの内容は、特定のModelRunが生成します。
- ModelRunは、1つ以上のToolCallレコードを要求します。
- 実行済み、失敗、待機中、保留の各ToolCallが、永続的なToolArtifactを生成します。
- ToolMemoryは、そのアーティファクトから導出され、生の根拠への来歴を保持します。
- ブランチは、すべての状態をコピーせずに、以前のブランチから継承します。
- ContextAssemblyは、含めたメモリと、復元した生のアーティファクトを記録します。
- ContinuationCheckpointは、会話ログのメッセージだけでなく、ランタイムの状態を復元します。
- PolicyDecisionは組み立てを制約し、プライバシー、プロバイダー、鮮度、削減、復旧の選択を明示します。
Runtime graph
- Conversation
- Branch
- Participant
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- Participant
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- Participant
- Branch
Tool memories across the active lineage → ContextAssembly → PolicyDecision → Checkpoint
Relationships
Conversation contains / has Branches; Branches inherit from the conversation.
Branches contain Participants; Participants contain Messages; Messages generate ModelRuns.
ModelRun requests ToolCall; ToolCall produces ToolArtifact; ToolMemory is derived from ToolArtifact.
ToolMemory is assembled into ContextAssembly. ContextAssembly is constrained by PolicyDecision. Checkpoint restores state.
Legend: contains / has; inherits from; generates; requests; derived from; assembled into; constrained by; restores.
4.2 永続的なツールアーティファクト
ToolArtifactは、ツール実行の永続的な生の記録です。
ツール呼び出しID、ツール名、引数、生の結果やエラー、状態、メッセージとジョブの所有関係、参加者とモデル実行の所有関係、ブランチの範囲、プライバシー分類、有効なスキルとツールプロファイル、プロバイダーとランタイムのメタデータ、大きすぎる引数や結果のストレージハンドルを記録します。
クライアント互換性と描画のために、メッセージ単位のツール結果を残すこともできます。切り詰め、要約、UI向けの整形が可能です。表示にはそれで構いません。長時間のワークフロー、監査、再試行、正確な復元には不十分です。
重要なのは、メッセージ単位で切り詰める前に、完全なアーティファクトを記録することです。UIをコンパクトに保ちつつ、バックエンドに再取得できる根拠を残せます。
後のターンで前のツール呼び出しの正確なCSVが必要なとき、失敗した呼び出しを再試行するとき、保留した選択画面を続けるとき、引用文書の説明が必要なとき、生成ファイルのIDを残す必要があるとき、サブエージェントの出力を監査するとき、非公開のツールペイロードを兄弟モデルのコンテキストに入れてはいけないときに、これが重要になります。
4.3 ツールメモリ
ToolMemoryは、1つ以上のアーティファクトから導出した、コンパクトなモデル向け記録です。
ツールメモリは、ユーザーメモリとは別です。ユーザーメモリは、パーソナライズと永続的なユーザーの事実を表します。ツールメモリは、ランタイムの根拠とツール由来の状態を表します。
ツールメモリには、元のアーティファクトID、元のツール名、要約文、構造化ペイロード、信頼度、信頼度の根拠と理由、曖昧さと限界の注記、プライバシー分類、鮮度クラス、古くなる時刻、再検証用ツール、来歴の参照位置、直近の解決状態、修復の試行、矛盾と置換のリンク、昇格ポリシーを持たせます。
目標は、モデルにすべてを記憶させることではありません。メモリに説明責任を持たせることです。コンパクトなメモリには、その出所、現在も有効か、正確な生の根拠を復元できるか、また復元するべきかを後からシステムが答えられるだけの来歴を残すべきです。
- 1. USER REQUEST: User asks a question or gives a task
- 2. MODEL RUN: Model decides to call one or more tools
- 3. TOOL CALL(S): Tool(s) executed with arguments from the model
- 4. TOOL ARTIFACT: Raw result or error captured as durable evidence (artifact)
- 5. TOOL MEMORY: Compact memory derived from artifact(s) with provenance
- 6. CONTEXT ASSEMBLY: Policy selects what to include, what to rehydrate, what to omit, and why
- 7. MODEL REQUEST: Assembled context sent to the model for the next generation
FEEDBACK LOOPS (as needed)
Revalidation · Retries · Continuations · Checkpoints · Branches · Subagent Promotion
Feedback returns to the relevant execution and context stages.
4.4 ContextAssembly
ContextAssemblyは、特定のモデルリクエストに何を入れたかを示す、独立した主要レコードです。
従来方式のメッセージ数、組み立て後のメッセージ数、推定トークン差分、生のアーティファクト数、選択したメモリ数、復元したアーティファクト数、ポリシーバージョン、組み立て機構のバージョン、選択したグラフ参照、省略の要約、安全性とプライバシーの判断、グラフクエリ、ポリシー評価、シリアライズの各所要時間を保存します。
監査で答えるべき問いは、次のものです。
なぜモデルは、このコンテキストを見たのですか?
答えは、「直近のN件のメッセージにあったから」であるべきではありません。次のような説明に近いものです。
この応答にはToolMemory_123を含めました。ToolArtifact_88から導出され、有効なブランチから継承され、この参加者に可視で、ポリシーバージョン4で組み立てました。コンパクトなメモリで十分なため、生のアーティファクトの復元は省略しました。
または、次のようなものです。
この応答では、プロバイダーのルーティング/プライバシーのポリシーが制限対象に分類したため、Google由来の生のペイロードを省略しました。ただし、安全な要約と再検証用ツールのヒントは含めました。
4.5 PolicyDecision
コンテキストの組み立ては、単なる切り詰めではなく、ポリシーの評価です。
- 所有ポリシーは、どの参加者やモデル実行がレコードを所有するかを確認します。
- 可視性ポリシーは、参加者の非公開、ブランチ内で可視、会話内で可視、監査専用のどれかを決めます。
- プライバシーポリシーは、選んだモデルやプロバイダーにデータを送れるかを決めます。
- 鮮度ポリシーは、レコードが最新、古い、永続的、再検証が必要のどれかを決めます。
- 昇格ポリシーは、アーティファクトをモデル向けメモリにするべきかを決めます。
- 復元ポリシーは、コンパクトなメモリで十分か、正確な生の根拠が必要かを決めます。
- 矛盾と置換のポリシーは、競合と置き換えを解決します。
- 復旧ポリシーは、未解決、失敗、保留、再試行に不可欠な状態を保護します。
- 保持ポリシーは、レコードを保持、削減、アーカイブ、削除するべきかを決めます。
本番の組み立てのたびに、レコードごとの詳細なトレースを残すのではなく、コンパクトなポリシーの要約と省略件数を記録します。詳細なトレースは、テストや対象を絞った監査で利用できます。
| Scenario | Policy Decision | Action | In Context? | Why |
|---|---|---|---|---|
| Google Gmail body (ZDR provider) | Privacy / Provider Restriction | Omit raw body, include safe summary + revalidation tool | Partial | Provider cannot receive Google content |
| Slack thread summary (2 weeks old) | Freshness (Bounded) | Include as stale marker + revalidation tool | Stale | May be outdated, needs recheck |
| Generated CSV file handle | Durability (Session) | Include compact memory (file ID, schema) | Yes | Still valid in session, low risk |
| Sibling branch analysis result | Branch Visibility (Branch-Private) | Omit from active branch context | No | Different branch, not relevant |
| Failed tool call (retry needed) | Recovery (Protected) | Include error + retry state | Yes | Required for recovery |
Every inclusion or omission is logged with policy version, reason, and scope.
4.6 コンテキストの種類
コンテキストは、どう削減、保持、要約、復元、提示するべきかによって分類します。
- 会話コンテキストは、ユーザーとアシスタントの文章やブランチ内の議論を含み、ウィンドウによる範囲制限や要約の対象にできます。
- 操作コンテキストは、ツールの引数、結果、ワークスペースのパス、生成ファイルIDを含み、要約前にアーティファクトとして保持するべきです。
- 知識コンテキストは、主張、発見、抽出した事実を含み、信頼度と鮮度のメタデータを備えたツールメモリに置くべきです。
- 来歴コンテキストは、アーティファクトID、文書ID、引用を含み、監査のために保持するか、主張の裏付けに必要なときに復元するべきです。
- ポリシーコンテキストは、プロバイダーの制約、OAuthスコープ、利用資格を含み、組み立て前に適用しなければなりません。
- 復旧コンテキストは、エラー、保留状態、再試行の契約を含み、未解決の間は削減するべきではありません。
- 計画コンテキストは、現在の実行や継続処理のための読み込み済みスキル、有効なプロファイル、タスクの分解を含みます。
これにより、メッセージの古さだけが削減ルールになるのを防ぎます。
4.7 鮮度と情報の古さ
ツールメモリを、気付かないうちに永遠の真実にしてはいけません。すべてのツールメモリに鮮度クラスを付けます。
- 変動性の高いメモリは、未読件数、空き状況、検索順位などを扱います。
- セッションのメモリは、一時的なランタイムファイル、作業ディレクトリ、作業用の状態を扱います。
- 有効期間に限りのあるメモリは、CRMレコード、Slackスレッドの要約、Notionページの状態などのスナップショットを扱います。
- 永続的なメモリは、生成ファイルのメタデータ、文書の引用、明示的なプロバイダーのエンティティIDを扱います。
- 恒久的なメモリは、不変の文書バージョンIDや、生成してストレージに保存したアーティファクトの識別情報を扱います。
組み立て機構は、古くなった変動性の高いメモリや有効期間に限りのあるメモリを、デフォルトで現在の事実として入れません。古いコンテキストとして含め、再検証の方法を提示し、省略し、あるいは正確な根拠が必要かつ許可される場合に、生の情報の復元を選べます。
4.8 矛盾と置換
この方式は、可能な限り、後勝ちのメモリを避けます。
ツールメモリ同士は衝突することがあります。あるブランチが文書の下書きを分析して結論を出し、別のブランチが後のバージョンを分析するかもしれません。あるプロバイダーへの照会で得た従業員数と、後の照会の結果が矛盾するかもしれません。あるモデルが情報源を誤って要約し、別のモデルが生のファイルから正確な値を抽出するかもしれません。
ランタイムは、競合のリンク、置換のリンク、信頼度、信頼度の根拠、元のアーティファクト、限界、曖昧さの注記を追跡します。重要なフィールドには方向があります。conflictsWithは不一致を示し、supersedesは現在のメモリが古いメモリを置き換えることを表し、supersededByは古いメモリから置換先を指します。
ポリシーは慎重です。競合するメモリは別々のレコードとして残します。置換済みのメモリは通常、現在のモデルコンテキストから省略し、現在の置換先は選択可能なままにします。不確実性が重要なら、矛盾の両側を含められます。解決に必要なのは、新しさだけでなく、来歴と信頼度です。
実用上、重要な点があります。supersedesは「この現在のメモリが古いメモリを置き換える」を意味するべきです。逆方向にはsupersededByなど別のフィールドを使うべきです。
小さなことに聞こえますが、ここが曖昧だと実際のバグにつながります。古いメモリではなく置換先を落とす組み立て機構では、慎重に処理しているつもりでも、モデルが古い状態に基づいて推論することになります。
4.9 参加者とランタイムの所有関係
NanthAI:Edgeは、マルチモデル実行、自律的な議論、サブエージェント、ブランチ、スケジュールジョブ、多くのツールを使う継続処理に対応します。そのため、所有関係が重要です。
表示されたアシスタントメッセージは、会話の共有コンテキストになり得ます。
しかし、同じチャットの中で生じたというだけで、生のランタイム状態を自動的に共有するべきではありません。
このアーキテクチャでは、ツールアーティファクト、ツールメモリ、コンテキストの組み立て、継続のチェックポイントに、visibilityScope、ownerParticipantId、ownerModelRunId、sharedWithParticipants、runtimeIsolationPolicy、runtimeKindなど、所有関係のメタデータを持たせます。
デフォルトのポリシーでは、モデル実行の状態は参加者単位に分離します。ユーザーに見えるアシスタントの出力は、確定後にブランチや会話のコンテキストになれます。非公開の作業状態は、兄弟参加者に漏れません。未解決のツール呼び出しは、所有する参加者と必要な継続処理に見える状態に保ちます。子サブエージェントのアーティファクトは、明示的に昇格するまで、非公開または監査専用です。
これは、エージェントアーキテクチャの中でも、説明が不足しがちな部分です。
多くのマルチエージェントの例は、協働について論じています。一方、あるモデルが表に出した発言、そのモデルだけが見た情報、そのツールが返した結果、子サブエージェントの発見、親が後から使えるもの、監査専用で残るものの境界を定義する例は多くありません。
このアーキテクチャは、その境界を明示します。
4.10 ブランチを考慮したグラフの組み立て
NanthAIの会話は分岐できます。そのため、コンテキストの組み立てを単なる「チャットIDで最近のメモリを取得する」にすることはできません。2つのブランチが異なる文書ID、生成ファイル、分析結果を作るなら、有効なブランチに、より新しい兄弟ブランチのアーティファクトを混入させるべきではありません。
解決策は、ブランチを考慮して組み立てることです。まず有効なブランチの系譜から候補を選びます。明示的な共有レコードや会話全体のスコープのレコードで残りの枠を埋められますが、兄弟ブランチの非公開状態が、有効なブランチのコンテキストを押し出すことはありません。
組み立てのログでは、ブランチによる除外を、通常のコンテキスト予算による省略と分けて記録します。ブランチのバグは見えにくいため、これが重要です。モデルが別のブランチに属するファイル、引用、文書IDを使い、自信を持って答えることがあります。UIは正常に見え、会話ログももっともらしく見えます。しかし、ランタイムは両立しない2つの経路を混ぜています。
ブランチを考慮した組み立ては、会話を平坦なメッセージ一覧ではなく、グラフとして扱います。
BROKEN: TRANSCRIPT REPLAY (BRANCH POLLUTION)
- Root conversation → Branch Point (User question)
- Branch A (Active) → Generates File_A.csv
- Branch B (Sibling) → Generates File_B.csv
- Active Branch A – Next Call Context: Root conversation; Branch A messages; File_A.csv (correct); Branch B messages (leaked); File_B.csv (incorrectly included)
Linear transcripts can leak sibling branch artifacts into the active branch.
POLLUTION EXAMPLE: When Branch A asks a follow-up, transcript replay includes everything in the history — including artifacts from Branch B.
Result: Sibling branch contamination, higher token cost, and incorrect or confusing model context.
CORRECT: BRANCH-AWARE ASSEMBLY
- Root conversation → Branch Point (User question)
- Branch A (Active) → File_A.csv
- Branch B (Sibling) → File_B.csv (Private to B); Explicit Share (Optional) → Branch A
- Active Branch A – Next Call Context: Root conversation; Branch A messages; File_A.csv (correct); Shared from B (if any); Branch B private items (excluded)
Assembler selects only active lineage and explicitly shared records.
ASSEMBLY RULES (Examples): Include active lineage only; Include explicitly shared records; Respect branch-private boundaries; Apply policy and freshness rules; Avoid sibling branch leakage.
Result: Clean, relevant context. Lower token cost. No branch leakage. Policy-governed and auditable.
Legend: Active Branch; Sibling Branch; Branch Point; Message; Artifact / Generated File; Explicitly Shared; Branch-Private (Not Visible); Active Lineage; Sibling Lineage; Explicit Share; Leak / Pollution (Bad).
4.11 生の情報の復元
コンパクトなメモリで十分なことが大半ですが、不十分な場合もあります。ユーザーが「前の正確なCSVを使って」と求めるなら、要約では足りません。ランタイムは生のアーティファクトを取り戻す必要があります。
このアーキテクチャは、範囲を限定した生の情報の復元に対応します。重要なのは「範囲を限定した」です。ストレージにある生のアーティファクトは、先回りしてではなく、ポリシーによる選択の後にだけ復元します。
組み立て機構は、正確な詳細が必要か、アーティファクトが選ばれたか、プライバシー分類が許可されるか、バイト予算内か、プロバイダーの経路が許可されるか、未解決または復旧に不可欠なレコードかを確認します。
- 条件を満たせば、生のアーティファクトを含められます。
- 満たさなければ、コンパクトなメモリ、参照、古いという印、再検証のヒント、または何も含めないことを選べます。
これにより、生のツールペイロードを永久に再送することと、後のターンに正確な形で必要な根拠を要約で消してしまうことの、両極端を避けます。
POLICY-GOVERNED ASSEMBLY
- RAW ARTIFACTS
- COMPACT MEMORIES
- SELECTED CONTEXT
- MODEL REQUEST
Keeps raw evidence out of the prompt
Includes only relevant, current, and allowed data
Preserves provenance and recovery state
Smaller, faster, safer, and more reliable
4.12 ランタイムの認知処理はUXとは別です
このアーキテクチャは、多くの内部ランタイム状態を追加します。その状態を、自動的にチャットUIに出すべきではありません。ツールメモリ、コンテキストの組み立て、ポリシー判断、来歴の修復記録、省略件数、グラフクエリのトレースは、ランタイムの認知処理です。
ユーザーが監査やデバッグの説明を求めたり、専用のインスペクターを開いたりしない限り、会話の文章にするべきではありません。
この境界は重要です。多くのAI製品は、ここを曖昧にします。アシスタントが、メモリ、ポリシー、内部状態、ツールの内部管理の状況を会話の中で語り始めます。
それにより会話ログが雑多になり、多くの場合、かえって信頼しにくくなります。NanthAI:Edgeでは、ユーザー向けの会話ログは製品の表の面、ランタイムグラフは実行の面として分けて保ちます。
来歴は、引用、生成ファイルのカード、デバッグ表示、将来の「なぜモデルはこう言ったのか?」を調べるインスペクターを通じて表示できます。
しかし、ランタイムが自分を説明するために、会話履歴を書き換えるべきではありません。
4.13 ランタイムモードの境界
ランタイムモードによって、組み立てのルールは異なります。通常のチャットとマルチモデルチャットは、有効な参加者に対し、ブランチを考慮して組み立てたコンテキストを使います。自律的な議論では、討論のプロンプト構造、司会者の指示、発言者のラベル、対応する非テキストの内容を保持しつつ、参加者に見える組み立て済みコンテキストを追加します。子サブエージェントの実行では、子の所有関係を持つ、子にローカルなツールアーティファクトとメモリを記録し、デフォルトでは非公開または監査専用にします。親サブエージェントの再開では、会話ログを無条件に検索せず、決定的なチェックポイントを保ち、選択した組み立ての参照を添付し、復元の判断を記録します。スケジュールジョブは、ジョブがチャットターンを作り、生成処理へ送る通常のバックエンド生成経路を使います。アイデアスケープのブランチからの送信は、クライアントが明示的な親IDを送った後に、同じブランチ対応の生成経路を使います。
最も難しいコンテキストのバグは、オーケストレーションの境界に生じることが多いため、これは仕上げの重要な工程でした。通常のチャットターンは、有効なブランチと参加者を直接使えます。サブエージェント実行後の親の再開は異なります。親が受け取るべきなのは、昇格された子の要約、生成ファイルのハンドル、子の失敗状態、再試行に関わる状態であり、明示的に昇格されていない子の生のワークスペースペイロードではありません。
必要に応じて、ランタイムの種類、サブエージェントのバッチ/実行ID、親のメッセージ/ジョブID、親のツール呼び出しID、昇格判断などのメタデータが必要です。目的は、スキーマを増やすこと自体ではありません。組み立て機構がプロバイダーリクエストへ何かをシリアライズする前に、所有関係と昇格の判断を表現できるようにすることです。
4.14 サブエージェントの昇格の境界
サブエージェントは、会話ログとコンテキストの分離を具体的に示します。
子サブエージェントは、ツールを呼び、文書を読み、中間ファイルを生成し、エラーに遭遇し、非公開の作業状態を持つことがあります。親に必要なのは、子の最終レポート、生成ファイルのハンドル、コンパクトなエラー要約、バッチの状態だけかもしれません。子の状態を会話ログの形をしたメッセージだけで保存すると、親に多くを再送しすぎたくなります。要約後に子の状態を捨てると、監査と復旧が損なわれます。
ランタイムは昇格の意味付けを使います。子の生のツール引数と結果は、デフォルトで子の非公開情報か監査専用です。生成ファイルのハンドルは、子が終端状態に達して昇格した後、親から見えるようになります。子の最終レポートは、親の再開処理に見えます。失敗やタイムアウトの状態は、コンパクトな復旧コンテキストに昇格できます。子の作業メモやワークスペースの詳細は、明示的に昇格しない限り、親からは見えません。
これにより、子の実行すべてを生の会話ログの荷物に変えることなく、親が継続に必要なコンテキストを得られます。
Parent Agent (Orchestrator) — Before Subagent Call
- User request: “Research ACME Corp and prepare a report.”
- Subagent Call: Task scope, inputs, and constraints
Parent State (continues): Conversation history; Long-term memories; Policy & preferences; Runtime checkpoints
Child Subagent (Isolated Runtime) — Owns private runtime state and working context
Does Private Work: Tool Calls — Executes tools and external API calls; Raw Tool Payloads — Full results, responses, files, logs (verbose); Scratch / Intermediate State — Notes, reasoning, partial results, drafts, retries; Temporary Artifacts — Working files, temp exports, debug data.
Private to Subagent: Not visible to parent.
Produces Outputs: Final Report / Answer — Curated, high-quality result for the parent; Generated File Handle — Compact reference (file ID, schema, hash, storage pointer); Compact Memories — Summaries with provenance, TTL, and freshness; Audit Trail (Optional) — Tool call list, key decisions, policy summary (not raw data).
Isolation Boundary: Subagent state is not accessible to the parent at any time.
Promotion Gate
Policy-driven promotion of explicit outputs only. Everything else stays private.
Parent Resumes (after subagent completion)
- Receives Promoted Outputs Only: Final Report / Answer; Generated File Handle; Compact Memories; Audit Trail (if provided)
- Parent State (updated): Adds promoted memories; Stores file handle reference; Records audit summary; Continues conversation
- Next Steps: Parent decides what to do next (e.g., follow-up questions, new tasks, branch, or additional subagents).
What gets promoted?
Final Report / Answer: Curated output intended for the parent.
Generated File Handle: Stable reference to large or expensive artifacts.
Compact Memories: Bounded, policy-checked context for future turns.
Audit Trail (Optional): High-level trace for accountability (no raw data unless allowed).
What stays private?
Raw tool payloads
Scratch / intermediate state
Temporary artifacts
All internal tool activity
Only promoted outputs cross the boundary.
Isolation Guarantees
No raw data leakage: Parent never sees raw tool payloads or scratch state.
Least-privilege promotion: Only explicit, policy-approved outputs are shared.
Bounded lifetime: Subagent state is discarded after completion.
Clean parent context: Parent resumes with only promoted, relevant context.
Auditability preserved: Policy decisions and summaries are recorded for traceability.
4.15 保持とガベージコレクション
永続的なアーティファクトには、ストレージ管理の責任が伴います。このアーキテクチャは「何でも永久保存する」という意味ではありません。保持を明示的に扱うという意味です。
保持モデルは、監査可能性とプライバシーのバランスを取る必要があります。生のアーティファクトは、ポリシーに従って保持、アーカイブ、墨消し、ハッシュ化、別領域への保存、削除ができます。サンプリングしたcontextAssemblyLogsは、積極的に削減するべきです。アカウント削除では、アーティファクト、メモリ、組み立てのログを削除しなければなりません。監査専用アーティファクトは、通常のモデルコンテキストの外に置くべきです。ストレージ上のペイロードは、プライバシーとバイト予算の確認後にだけ復元するべきです。生成ファイルと文書への参照には、有効な引用とファイルハンドルを壊さない、参照を維持した整理が必要です。
このため、このアーキテクチャの採用に最も合理性があるのは、本格的なツール作業です。
生の根拠を残すと復旧と監査は改善しますが、分類、暗号化、アクセス制御、削除、プロバイダーのルーティング管理の負担も増えます。
5. アーキテクチャの分析
5.1 トークン費用のモデル
会話ログの再送では、多くのツールを使う会話のモデル向け費用は、おおよそ次のようになります。
conversation_window + historical_tool_calls + historical_tool_results + summaries + retry_state
グラフに基づくコンテキストの組み立てでは、おおよそ次のようになります。
conversation_window + selected_tool_memories + protected_recovery_state + selected_skill_state + optional_raw_rehydration
重要な違いは、過去のツール処理量に応じて何が増えるかです。会話ログの再送では、古いツールペイロードが、切り詰めや要約まで再送経路に残る場合があります。このアーキテクチャでは、生のアーティファクトを別に保持し、コンパクトなメモリ、保護した未解決状態、明示的に復元した根拠だけをモデルのコンテキストに入れます。
これが、このアーキテクチャの経済的な核心です。
5.2 生のアーティファクトとコンパクトなメモリ
生のアーティファクトとメモリの分離により、2つの層ができます。根拠の層には、完全な引数、生の出力、エラー、ハッシュ、ストレージハンドル、来歴、ランタイムのメタデータがあります。コンテキストの層には、コンパクトな要約、構造化された事実、生成ファイルのハンドル、古いという印、信頼度のメタデータ、再検証のヒントがあります。
これにより、監査可能性を失わずにコンテキストの量を減らせます。要約は低費用で有用ですが、唯一残る記録にするべきではありません。
5.3 キャッシュと監査の境界としてのContextAssembly
コンテキストの組み立ては、保存された状態と、プロバイダーリクエストへのシリアライズの間に、安定した境界を作ります。ランタイムがメッセージのシリアライズ方法を変えても、組み立ての記録には、どのグラフ参照を、どのポリシーバージョンが選んだかが残ります。
このアーキテクチャが目指すのは、ポリシーバージョンに基づく再現性であり、永久にバイト単位で同一の再送ではありません。同じグラフのスナップショットに同じポリシーバージョンを適用すれば、同じアーティファクト集合、メモリ集合、保護された生の状態、ポリシー判断を選ぶべきだという意味です。トークン化の一致や、非決定的なプロバイダーによる実際のモデル出力の一致は保証しません。
5.4 参加者単位のコンテキスト
マルチモデルチャットでは、会話ログの共有とランタイムの共有は異なります。
2つのモデルが同じユーザープロンプトに答えれば、ユーザーは両方の最終出力を並べて見られます。しかし、モデルAの非公開の作業メモ、ツールエラー、OAuth由来の生のペイロードを、モデルBに見せてよいという意味ではありません。
このアーキテクチャは、可視性のスコープとランタイムの分離ポリシーで、その違いを明示します。
これは評価上、大きな利点です。レコードがブランチ内で可視だったか、参加者の非公開だったか、監査専用だったか、昇格済みだったか、古かったか、プロバイダー/プライバシーのポリシーで省略されたか、正確な根拠が必要なため復元されたかという層ごとに、失敗を分けて調べられます。
5.5 グラフクエリとしてのコンテキスト組み立て
このアーキテクチャは、コンテキストの組み立てを、ランタイムのエンティティに対するグラフクエリと捉えます。有効なブランチの系譜、参加者の可視性、ランタイムの分離、プライバシー分類、昇格ポリシー、鮮度ポリシー、信頼度の来歴、矛盾と置換、継続の状態、再試行/復旧の保護、コンテキスト予算、生の情報の復元範囲によって制約します。
「GraphRAG」を主要な捉え方にするのが適切でないのは、このためです。GraphRAGは通常、分野の知識や文書の関係を検索します。ランタイムのグラフには、実行状態、ポリシー、参加者、ブランチ、アーティファクト、メモリ、コンテキストの組み立てが含まれます。
ランタイムグラフは、知識グラフより広いものです。
5.6 決定性と再現性
このアーキテクチャは、ポリシーバージョンに基づく再現性を目指します。永久にバイト単位で同一のプロンプトを再送することではありません。
この区別は重要です。プロバイダーのSDKがシリアライズを変えるかもしれません。OpenRouterのルーティングで、自動経路の背後のモデルが変わるかもしれません。プロバイダーごとにトークン化が異なる場合があります。入力が同一でも、実際のモデル呼び出しは非決定的かもしれません。
再現性の目標は、もっと限定的で、役立つものです。同じグラフのスナップショットに同じポリシーバージョンを適用すれば、同じアーティファクト集合、メモリ集合、保護された生の状態、ポリシー判断を選ぶべきです。プライバシー、プロバイダーのルーティング、ブランチの範囲、再試行、継続の判断は、保存状態から説明できるべきです。過去のコンテキストの組み立ては、監査やデバッグのために実質的に再構成できるべきです。無害な書式変更で、意味上の監査可能性が損なわれるべきではありません。
policyVersion、assemblerVersion、選択した参照、省略の要約、所要時間のフィールドが重要なのはこのためです。これらが、ランタイムの状態と、プロバイダー向けメッセージのシリアライズの境界を定義します。
5.7 単に大きなコンテキストではない理由
大きなコンテキストウィンドウは役立ちますが、アーキテクチャの問題は解決しません。
大きなウィンドウには、より多くの古い根拠、非公開の作業状態、兄弟ブランチの雑音、古いツールエラー、OAuth由来の生のペイロードが入ります。切り詰めが表面化する時点を遅らせられますが、何を含める価値があるかは決めません。
このアーキテクチャは、長いコンテキストを扱うモデルへの反対論ではありません。コンテキストウィンドウを意図的に埋めるべきだという主張です。タスクに必要なら、組み立て機構は大きなウィンドウを使えます。違いは、生のアーティファクト、コンパクトなメモリ、復旧状態、ポリシーの制約が、時系列によって生き残るのではなく、明示的なルールを通じて競合することです。
6. 先行技術との比較
このアーキテクチャは、コンテキストエンジニアリング、グラフランタイム、メモリ、来歴、監査に関する、有力な取り組みの系譜に位置します。
- コンテキストエンジニアリングは、今やエージェント設計の主流の概念です。Anthropic、Haystack、Atlanなどは、モデルのコンテキストを単なるプロンプト文字列とせず、指示、履歴、取得データ、ツール、メモリ、タスクの状態から明示的に組み立てるべきだと主張しています。
- LangGraphには、グラフの状態、スレッド、チェックポイント、スナップショット、再実行、永続的な実行パターンの有力な先例があります。
- エージェントメモリのシステムは、短期、長期、エピソード、意味、手続き、作業記憶を区別しています。
- MCPとツール利用のフレームワークは、ツールを明示的にし、記録可能にします。
- イベントソーシングと監査証跡の文献は、追記専用の実行記録と再構成できる履歴を支持しています。
- MemORAIやPortable Agent Memoryなど、来歴を考慮したメモリの研究は、情報源に結び付いたメモリの方向を示しています。
- プロンプトインジェクション、メモリ汚染、セッション間の漏えい、来歴を考慮したツールの安全性に関する研究は、より厳密なポリシー境界を支持しています。
NanthAIの貢献は、収束しつつあるこれらのパターンを、1つのランタイム契約に統合することです。永続的なツールアーティファクト、コンパクトなツールメモリ、来歴、参加者の所有関係、ブランチを考慮したグラフの組み立て、ポリシー判断、会話ログとコンテキストの分離です。
その統合こそが要点です。有用な手法の集まりを、多くのツールを使うエージェントのための、規律あるランタイムモデルに変えます。
6.1 すでに標準的と考えられるもの
短期記憶と長期記憶、古いコンテキストの圧縮、後のターンでのツール出力の利用、エージェント状態のチェックポイント化、取得した内容やツール・ユーザーの内容を潜在的に信頼できないものとして扱うこと、プロンプトを書くだけでなくモデルのコンテキストを明示的に管理すること、デバッグと可観測性のためのログ保存などは、すでに標準的、またはそれに近い考えです。
6.2 新たに広がりつつあるもの
来歴を考慮したエージェントメモリ、古いメモリの検出、矛盾と置換の処理、可搬なメモリオブジェクト、コンパクトなメモリからの生のアーティファクトの復元、プロバイダー側のデータ非保持制約に対応する自社の状態ストア、ポリシーに基づくコンテキストの組み立て、攻撃対象としてのメモリは、文献や本格的なフレームワークに見られるものの、まだ確立していません。
このアーキテクチャは、その方向に沿いながら、これらに具体的な製品ランタイムの契約を与えます。
6.3 説明が不足していると考えられるもの
特に興味深い考えは、もっと限定的です。独立した永続レコードとしてのContextAssembly、各生成に結び付くPolicyDecision、コンパクトなToolMemoryから分離した永続的で生のToolArtifact、マルチモデルチャットで参加者ごとに非公開のランタイム状態、昇格まで非公開の子サブエージェントのアーティファクト、会話の系譜に対するブランチ対応のコンテキスト組み立て、観測からメモリへの昇格の意味付け、ユーザーの会話ログから切り離したランタイムの認知処理です。
私は、この部分でアーキテクチャが最も役立つと考えています。各フィールドがそれぞれ意外だからではありません。組み合わせることで、これまで暗黙のままだった判断を表す用語体系をランタイムに与えるからです。
6.4 最も近い先例
フレームワークとして最も近い先例はLangGraphです。グラフの状態、スレッド、チェックポイント、再実行、タイムトラベル、永続的な実行パターンは、このランタイムの方向性とよく一致します。違いは範囲です。このアーキテクチャは、グラフの実行だけではありません。ツールアーティファクト、コンパクトなメモリ、参加者の可視性、ブランチの系譜、コンテキストの組み立て、ポリシー判断を、独立した主要レコードにしています。
Portable Agent MemoryとMemORAIは、メモリの来歴の面で近いものです。メモリには出典へのリンクと完全性のメタデータを持たせるべきだという考えを支持します。このアーキテクチャは、その考えを可搬なメモリオブジェクトだけでなく、ツールアーティファクトと生成コンテキストに適用します。
イベントソーシングの取り組みは、監査と再実行の面で近いものです。追記専用のイベント履歴と、再構成できる実行を支持します。このアーキテクチャには、その時間的な履歴に加え、ブランチ、参加者、アーティファクト、メモリ、ポリシー間のグラフ関係が必要です。
ARGUSなど、来歴を考慮した安全性の取り組みは、セキュリティ面で近いものです。ツールに関する判断は過去のコンテキストの影響を受けると捉え、来歴を使って安全でない行動を分析します。このアーキテクチャは、その発想を一般化します。来歴は安全性の確認だけでなく、通常のコンテキストへの包含、復元、矛盾の処理、監査も形作るべきです。
MCPが関係するのは、ツール呼び出しとコンテキストの情報源を明示するからです。ただし、MCPは連携プロトコルであり、保持、来歴、ブランチ、参加者、コンテキスト組み立てのポリシーではありません。
6.5 ZDRと自社で管理する状態
ゼロデータ保持と、プロバイダー側の非保持制約により、会話ログとコンテキストの分離は一層重要になります。
プロバイダー側での永続化が利用できない、または望ましくない場合も、アプリケーションの所有者には、内部の監査記録、復旧状態、生成ファイルへの参照、ツール呼び出しの来歴、参加者の可視性の判断、削除と保持のポリシー、モデルが見た情報を再構成する手段が必要です。
そのため、状態を所有する責任は製品のランタイムに戻ります。プロバイダーは実行のエンドポイントになります。アプリケーションが、何を保持し、墨消しし、省略し、毎回のリクエストで送るかを決める責任を持ちます。
このアーキテクチャは、そのモデルに適合します。永続的な正規の情報源として、プロバイダーが管理するスレッドには依存しません。バックエンドが独自のグラフ状態を保持し、そこからプロバイダーリクエストを組み立てます。
7. ポリシーの複雑さと管理方法
技術上の主な課題は、ポリシーに基づく組み立てが、設計、テスト、観測の必要な判断層を追加することです。
会話ログの再送は、理解が単純です。メッセージがウィンドウにあればモデルに見え、切り詰められていれば見えません。
ポリシーに基づくコンテキストの組み立ては、より強力であり、その力にはガードが必要です。ポリシー層は、有用な根拠の省略、古いメモリの混入、非公開状態の漏えい、再試行に不可欠なエラーの隠蔽、過剰な生の情報の復元、正確な根拠の復元不足、ブランチの系譜の誤り、モデルが導出した要約への過信、グラフクエリの過度な遅延、表面的な監査可能性を防がなければなりません。
これが中心的なトレードオフです。このアーキテクチャは、偶然に任せた会話ログの継承を、明示的なポリシーに置き換えます。それが改善となるのは、ポリシーをテストでき、観測でき、範囲を限定できる場合だけです。
このアーキテクチャが最も力を発揮するのは、ツールのワークフローが長時間に及ぶ、または多くのアーティファクトを扱い、生のツールの根拠が重要で、プライバシーやプロバイダーの制約が重要で、ブランチ、サブエージェント、マルチモデル実行が一般的で、古い事実が実際の誤りを引き起こし、監査可能性とコンテキストの費用が重視される場合です。
チャットが短く、ツールをほとんど使わず、出力の監査が不要で、すべての状態を安全に共有でき、後から正確な根拠が必要になることがなく、ポリシーテストやテレメトリーを支える開発リソースがない場合には、関連性は低くなります。
単純なチャットボットには、会話ログの再送で十分かもしれません。多くのツールを使うエージェントのワークスペースでは、複雑さはすでに存在しています。このアーキテクチャは、それを明示的でテスト可能にします。
8. リスクと失敗の形
R1:ポリシーのバグ
組み立て機構が、必要な根拠を省略したり、禁止されたコンテキストを含めたりする可能性があります。
対策:決定的なシナリオテスト、省略の要約、ポリシーのバージョン管理、変更前後の評価、サンプリングした組み立てのログ。
R2:ストレージの増大
生のアーティファクトは、特にファイル、APIペイロード、stdout/stderr、生成出力を伴う場合、急速に増える可能性があります。
対策:保持クラス、GC対象の条件、アカウント削除時の整理、ストレージハンドル、ハッシュ化、監査専用の保持ポリシー。
R3:プライバシーとプロバイダーへの漏えい
保存アーティファクトには、OAuth由来のデータ、Googleデータ、文書データ、ランタイムファイル、秘密情報に近いペイロードが含まれる場合があります。
対策:プライバシー分類、プロバイダーのルーティングポリシー、生の情報の復元ゲート、メタデータだけの要約、判断できない場合は省略すること。
R4:コンパクトなメモリによる誤った確信
要約は、誤っていたり、古かったり、不完全だったりする場合があります。
対策:信頼度の根拠、来歴の参照位置、鮮度クラス、矛盾のリンク、限界、生の情報を復元する経路。
R5:古いメモリ
モデルが、古い外部の観測を現在の真実として頼る可能性があります。
対策:observedAt、staleAfter、鮮度クラス、再検証用ツール、古いという印、省略ポリシー。
R6:ブランチの混入
兄弟ブランチのアーティファクトが、有効なブランチの状態を押し出す可能性があります。
対策:有効なブランチの系譜へのクエリ、明示的な会話全体/共有の可視性、ブランチによる除外のテレメトリー。
R7:参加者間の漏えい
モデルの参加者が、別の参加者の非公開のツール状態を見てしまう可能性があります。
対策:所有参加者ID、所有モデル実行ID、可視性のスコープ、ランタイムの分離ポリシー、共有先リスト、昇格判断。
R8:遅延の増大
グラフクエリ、来歴の修復、ストレージからの復元が高コストになる可能性があります。
対策:候補集合の範囲制限、ポリシー選択後の2段階の復元、所要時間のテレメトリー、修復試行数の制限、遅延の判定基準。
R9:永続性に関する過大な主張
アーティファクトとチェックポイントは復旧と監査を助けますが、完全な分散型の永続的実行と同じではありません。
対策:正確な表現、必要な箇所での冪等性、継続のチェックポイント、再試行の契約、より強いワークフロー保証のための外部オーケストレーション。
R10:省略のデバッグ可能性
悪い状態が含まれたためではなく、関連する状態が省略されたために、モデルが失敗する可能性があります。
対策:除外理由ごとの件数、決定的な詳細トレース、ブランチによる除外のテレメトリー、サンプリングした組み立てのログ、選択レコードだけでなく候補も調べられる監査/デバッグのクエリ。
R11:昇格のずれ
抽出処理が、永続的なメモリに昇格させすぎたり、モデルに見えるメモリへの昇格を不足させたりする可能性があります。
対策:明示的なpromotionPolicy、抽出処理のテスト、信頼度の来歴、プライバシー上の降格ルール、メモリが昇格されなかった場合の生のアーティファクトの復元。
R12:復元の悪用
生の情報の復元が、大きなペイロードや機密性の高いペイロードを、プロバイダーのコンテキストへ入れる隠れた経路になる可能性があります。
対策:2段階の選択、ストレージ読み取り前のプライバシー確認、バイト予算、プロバイダーのルーティングゲート、OAuth/Google/秘密情報に近いデータについて判断できない場合は省略すること。
9. 実装の測定
動作全体の検証にはより広いベンチマークが必要ですが、一部の主張は現在のNanthAI:Edgeの実装から直接評価できます。特にコードベースでは、多くのツールを使う固定シナリオで、従来の会話ログ再送のコンテキストと、組み立てたグラフコンテキストを比較できます。
これらの測定は、コンテキストの効率に関する主張を定量化します。過去のツールペイロードを、コンパクトなメモリ、選択したグラフコンテキスト、プライバシー/所有関係によるフィルタリング、保護された未解決の生の状態に置き換えると、モデル向けプロンプトの情報をどれだけ減らせるかです。
比較の構成は単純でした。従来の経路では、生のツールペイロードによる雑音を含め、会話ログとツールメッセージを再送しました。組み立ての経路では、コンパクトなツールメモリ、選択したグラフコンテキスト、プライバシーと所有関係のフィルタリング、保護された未解決の生のツール状態を使いました。
これは実装の測定であり、公開ベンチマークでも、タスク成功率の普遍的な向上を主張するものでもありません。
9.1 プロンプトのコンテキスト削減
実際に実行した比較シナリオでは、プロンプトのトークン差分は大きなマイナスでした。
- 保留された文書選択のコンテキストは1020トークンから142トークンになり、86.1%削減しました。
- 複数ツールによるファイル生成は1905トークンから221トークンになり、88.4%削減しました。
- 接続アプリの古いメモリは1051トークンから145トークンになり、86.2%削減しました。
- 複数スキルのランタイム状態は1008トークンから179トークンになり、82.2%削減しました。
- 参加者の可視性は961トークンから161トークンになり、83.2%削減しました。
- 矛盾と置換は1986トークンから197トークンになり、90.1%削減しました。
これは、アーキテクチャの第1のコンテキスト効率の主張を裏付けます。過去に成功したツール処理を、生の会話ログの荷物として再送経路に残す必要はありません。生の根拠をプロンプトの外で再取得できる状態に保ちつつ、来歴に結び付いたコンパクトなメモリにできます。
9.2 復旧と来歴の保持
トークン削減が役立つのは、重要な状態を失わない場合だけです。そのため、テストしたシナリオには、復旧、来歴、プライバシー、ブランチ、参加者の境界の事例を含めました。保留された文書選択の状態、生成ファイル、接続アプリの古いメモリ、複数スキルのランタイム状態、参加者の可視性、矛盾と置換、壊れた来歴の修復、正確な生のCSVの復元、ブランチの分離、再試行に不可欠なエラー、Googleデータのプライバシーによる省略、サブエージェントの継続状態、自律的な議論の発言者帰属、子サブエージェントのアーティファクトの記録、親サブエージェントの再開メタデータ、スケジュールジョブとの互換性、ブランチからの送信との互換性です。
組み立ての経路は、会話ログの再送に構造的な弱さがある箇所で、動作を改善しました。参加者の非公開の作業メモを渡さず、代替IDを作り上げずに来歴を修復し、有効なブランチの状態を選び、再試行に不可欠なエラーを保持し、ポリシーが求める場合はGoogleの生の本文を省略し、ポリシーで許可される場合は正確な生のアーティファクトを復元しました。
9.3 ランタイムモードの網羅
同じアーキテクチャは、単純なチャットループだけでなく、各生成モードで機能しなければなりません。通常のチャットターン、マルチモデルターン、自律的な議論、子サブエージェントの実行、親の再開、スケジュールジョブ、ブランチからの送信には、それぞれ異なるコンテキスト境界があります。
実装から得た重要な教訓は、グラフの組み立てを、その境界でテストする必要があることです。子サブエージェントの状態は、昇格まで非公開にすべきです。親の再開は、決定的なチェックポイントを使うべきです。自律的な議論は、発言者のラベルと司会者の指示を保持すべきです。ブランチからの送信は、兄弟ブランチのアーティファクトを取り込まず、有効な系譜を継承すべきです。
グラフモデルが最も重要になるのは、ここです。グラフはトークンを減らすだけではありません。どの状態がどの生成モードに属するかを決めるための用語体系を、ランタイムに与えます。
9.4 内部検証で分かったこと
内部検証には、2つの層がありました。
- 決定的な検証の層では、組み立てのポリシーが、必ず保たなければならないランタイム状態を保持するかを確認しました。生のツールアーティファクトは、メッセージ単位で切り詰める前に永続化されました。未解決、保留、失敗、再試行に不可欠なツール状態は、モデルに見える状態を保ちました。参加者の非公開状態は、兄弟参加者には渡しませんでした。古いメモリは、黙って現在の真実として扱わず、印を付けるか省略しました。置換済みのメモリは省略し、現在の置換先は選択可能に保ちました。壊れた来歴は、代替IDを作り上げず、修復するか古いと明示しました。ブランチ内のアーティファクトとメモリは、最近の兄弟ブランチではなく、有効な系譜から選びました。プライバシーで制限された生のペイロードは省略し、安全な要約と再検証のヒントは利用可能なままにしました。
- 次に実際の比較の層で、同じシナリオを、従来の会話ログの再送と、組み立てたグラフコンテキストという2つの形で表現しました。組み立ての経路は、必要な復旧/来歴の事実を保持しながら、プロンプトに提示する量を大幅に減らしました。
上記の実際に測定したシナリオでは、削減率は82.2%から90.1%でした。
9.5 解釈
これらの測定は、テストした実装シナリオにおけるコンテキスト削減の前提を検証します。NanthAI:Edgeの組み立ての経路が、過去のツールペイロードのデフォルトでの再送、参加者の非公開の作業状態の露出、接続アプリの古い状態を現在の真実として扱うこと、兄弟経路からのブランチへの混入、再試行に不可欠なツール状態の喪失、参照位置が壊れた際の来歴の捏造を、実質的に減らせることを示しています。
測定が答えるのは、次の1つの問いです。
ポリシーに基づくコンテキストの組み立ては、テストしたシナリオで、重要な復旧と来歴の状態を保持しながら、モデルに提示するコンテキストの量を減らしますか?
答えは、はいです。
10. 考察
私がこのアーキテクチャから取り出すパターンは、次のものです。会話ログは人向けの履歴に保ち、切り詰め前に生のツールアーティファクトを保存し、場当たり的な要約ではなくアーティファクトからコンパクトなメモリを導出し、生の根拠への来歴を保持し、鮮度と置換を追跡し、参加者とブランチごとにランタイム状態の範囲を定め、メッセージの古さではなくポリシーでモデルのコンテキストを組み立て、何が起きたかを説明できるだけの判断を記録し、正確な根拠が必要かつ許可される場合だけ生のアーティファクトを復元し、ユーザーが監査表示を求めない限り、ランタイムの認知処理をUXに出さないことです。
これが、実際のアーキテクチャです。
実装チームにとっての実用的なルールも、同じく明確です。グラフの候補を選ぶ前に、不変の1つの組み立てポリシーを解決します。共有や会話全体のスコープの候補で埋める前に、有効なブランチの系譜を取得します。ストレージ上の生のペイロードは、プライバシーと予算のポリシーが選択した後にだけ復元します。子サブエージェントの状態は、明示的に昇格するまで非公開または監査専用として扱います。何を含めたかだけでなく、なぜレコードを省略したかを記録します。
「長期記憶」でも、「GraphRAG」でも、「大きなコンテキストウィンドウ」でもありません。
次のモデル呼び出しに入れる価値のあるものを決める、ポリシーに基づくランタイムです。
ここから、いくつかの示唆が得られます。
- コンテキストの組み立てが、ランタイムの基本要素になります。 ほかの重要なバックエンド契約と同様に、テストとバージョン管理をするべきです。
- メモリに説明責任が生まれます。 来歴、鮮度、信頼度のメタデータのないメモリでは、本格的なツールのワークフローには不十分です。
- ツール出力が、会話ログの荷物でなくなります。 生のアーティファクトを永久に再送することなく、復旧と監査のために保持できます。
- 参加者の境界が明示されます。 マルチモデルとサブエージェントのシステムは、表示される出力と非公開のランタイム状態を区別する必要があります。
- 分岐が構造の一部になります。 ブランチは単なるUIの移動先ではありません。次のモデル呼び出しに影響するべきアーティファクトとメモリを制約します。
- 監査が、ログから説明へ移ります。 目的はイベントの保存だけでなく、モデルが特定のコンテキストを見た理由を再構成することです。
これがNanthAI:Edgeで私たちが進めている方向です。エージェントの履歴は無条件に再送せずとも永続化されるべきであり、モデルのコンテキストはメッセージ順序から引き継がず、ポリシーに基づくグラフ状態から組み立てるべきです。
11. 結論
業界は、チャットボットからツールを使うエージェントへと移っています。それにより、状態の問題も変わります。チャットボットは、会話ログの再送で済むことがよくあります。
ファイルを書き、文書を読み、APIを呼び、ウェブを検索し、サブエージェントを生成し、スケジュールジョブを実行し、会話を分岐させ、モデルを比較するエージェントは、会話ログをランタイム全体として扱うことはできません。
会話ログは投影です。必要ですが、不完全です。モデルにはコンテキストが必要で、ユーザーには履歴が必要です。
システムには根拠が、監査者には来歴が必要です。再試行ループには復旧状態が、プライバシー層にはポリシーが必要です。
製品は、すべてのモデルリクエストを過去のツールペイロードのごみ溜めにすることなく、それらすべてを共存させなければなりません。
このアーキテクチャがするのは、そのことです。今後のモデルリクエストを毎回、過去のツールペイロードの再送にすることなく、エージェントの履歴に永続的なランタイムの形を与えます。
エージェントの機能を増やすたびに、プロンプトが比例して大きくなるべきではありません。
エージェントの履歴が増えるたびに、会話ログの再送量が比例して増えるべきではありません。
次の層は、ポリシーに基づくコンテキストの組み立てです。
参考文献
- Anthropic. Effective context engineering for AI agents. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Haystack. Context engineering. https://haystack.deepset.ai/blog/context-engineering
- Atlan. How to structure context for LLM applications. https://atlan.com/know/how-to-structure-context-for-llm-applications/
- LangGraph. Persistence. https://docs.langchain.com/oss/python/langgraph/persistence
- LangGraph. Durable execution. https://docs.langchain.com/oss/python/langgraph/durable-execution
- LangGraph. Add memory. https://docs.langchain.com/oss/python/langgraph/add-memory
- Databricks. Memory scaling for AI agents. https://www.databricks.com/blog/memory-scaling-ai-agents
- Google Cloud. What is Model Context Protocol? https://cloud.google.com/discover/what-is-model-context-protocol
- Portable Agent Memory. https://arxiv.org/html/2605.11032v1
- MemORAI. https://arxiv.org/html/2605.01386v1
- ESAA: Event Sourcing for Autonomous Agents in LLM-Based Systems. https://arxiv.org/abs/2602.23193
- Audit Trails for Accountability in Large Language Models. https://arxiv.org/html/2601.20727v1
- STALE. https://arxiv.org/html/2605.06527v1
- Evaluating the Long-Term Memory of Large Language Models. https://aclanthology.org/2025.findings-acl.1014/
- OWASP Agent Memory Guard. https://owasp.org/www-project-agent-memory-guard/
- OWASP. LLM Prompt Injection Prevention Cheat Sheet. https://cheatsheetseries.owasp.org/cheatsheets/LLM_Prompt_Injection_Prevention_Cheat_Sheet.html
- ARGUS. https://arxiv.org/html/2605.11053v1
- Beyond RAG for Agent Memory. https://arxiv.org/html/2602.02007v2
- LongMemEval-V2. https://arxiv.org/html/2605.12493v1
- Agentic Memory. https://arxiv.org/html/2601.01885v2
- Governing Evolving Memory in LLM Agents. https://arxiv.org/html/2603.11768v1
- Giskard. Cross-session leak: when your AI assistant becomes a data breach. https://www.giskard.ai/knowledge/cross-session-leak-when-your-ai-assistant-becomes-a-data-breach
- Unit42. Indirect prompt injection poisons AI long-term memory. https://unit42.paloaltonetworks.com/indirect-prompt-injection-poisons-ai-longterm-memory/
- Diagrid. Checkpoints are not durable execution. https://www.diagrid.io/blog/checkpoints-are-not-durable-execution-why-langgraph-crewai-google-adk-and-others-fall-short-for-production-agent-workflows
- Zero Data Retention in LLM-based Enterprise AI Assistants. https://arxiv.org/abs/2510.11558
こちらにも掲載: LinkedIn.