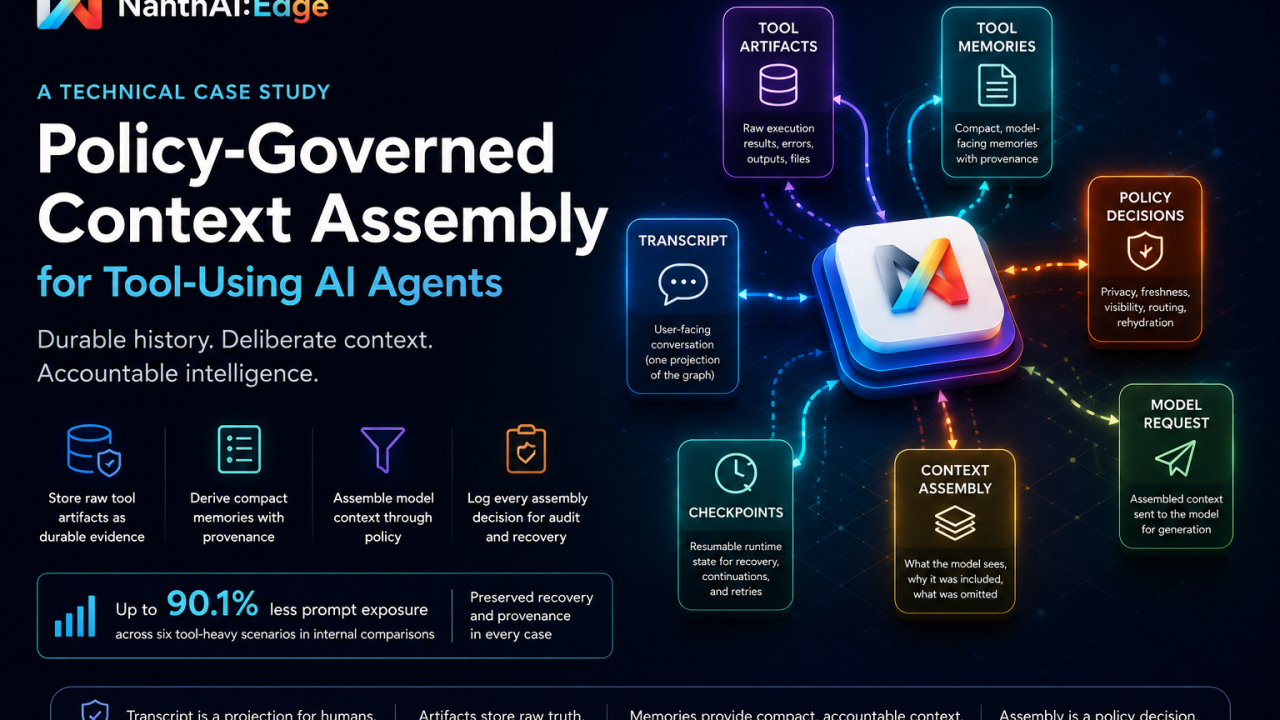
Eine technische Fallstudie zu NanthAI:Edge.
Die meisten KI-Agenten mit Werkzeugnutzung skalieren ihren Verlauf auf die falsche Weise: Jeder Werkzeugaufruf, jedes Werkzeugergebnis, jede erzeugte Datei, jeder neue Versuch, jede Zusammenfassung, jeder Fehler und jede Fortsetzung wird durch das sichtbare Chat-Transkript zurückgeführt, bis die Inhalte gekürzt, verdichtet oder verloren sind.
Bei NanthAI:Edge ist das nicht nur Theorie. In internen Vergleichstests reduzierte zusammengestellter Graphkontext den bereitgestellten Prompt-Umfang von 1.905 auf 221 Token bei einem Dateierzeugungsablauf mit mehreren Werkzeugen, von 1.986 auf 197 Token bei einem Ablauf mit Widerspruch/Ersetzung und von 1.020 auf 142 Token bei einem Ablauf mit aufgeschobener Dokumentauswahl. Das beweist keinen besseren Aufgabenerfolg. Es beweist aber, dass sich der Kontextumfang für das Modell erheblich verkleinern lässt, während der Wiederherstellungs- und Herkunftszustand erhalten bleibt.
Der einfachste Weg, einen KI-Agenten zu bauen, ist weiterhin, immer mehr an den Chat anzuhängen.
Der Nutzer stellt eine Frage. Das Modell ruft ein Werkzeug auf. Das Werkzeug gibt ein Ergebnis zurück. Das Ergebnis landet in der Unterhaltung. Das Modell ruft ein weiteres Werkzeug auf. Ein weiteres Ergebnis wird angehängt. Der Agent schreibt eine Datei, stößt auf einen Fehler, versucht es erneut, fasst zusammen, verzweigt, macht später weiter, startet vielleicht einen Subagenten, und das Transkript wächst weiter.
Anfangs wirkt das natürlich. Das Transkript ist schon da. Es ist geordnet. Es ist lesbar. Es sieht aus wie Gedächtnis. Doch für Agenten mit Werkzeugnutzung ist das Transkript eine Falle.
Das Transkript ist das, was der Nutzer lesen können sollte. Es ist nicht dasselbe wie das, was das Modell als Nächstes sehen sollte. Sobald ein Agent Werkzeuge ausführt, Dateien verarbeitet, APIs aufruft, über Zweige hinweg arbeitet, Modelle vergleicht oder privaten Laufzeitzustand mitführt, wird das sichtbare Chatprotokoll zu einer schlechten maßgeblichen Quelle. Es vermischt Produkterlebnis, Belege, Erinnerungen, Wiederholungszustand, Datenschutzgrenzen, veraltete Beobachtungen und Audit-Datensätze zu einem chronologischen Strom.
Das bessere Muster behandelt das Transkript als eine Projektion eines reichhaltigeren Laufzeitgraphen. Rohe Werkzeugausgaben werden als dauerhafte Artefakte gespeichert. Daraus werden kompakte Erinnerungen abgeleitet. Herkunftsverweise verbinden Erinnerungen mit ihren Belegen. Zweige, Teilnehmer, Modellausführungen, Werkzeugaufrufe, Checkpoints und Richtlinienentscheidungen sind getrennte Entitäten. Jede Modellanfrage erhält eine richtliniengesteuerte Kontextzusammenstellung aus diesem Graphen statt eines blinden erneuten Einspielens alter Chatnachrichten.
Für diese Architektur argumentiert dieser Artikel: nicht für „mehr Gedächtnis“, nicht für „einfach ein größeres Kontextfenster“ und nicht für „GraphRAG für alles“. Der Punkt ist präziser: Der Verlauf eines Agenten sollte dauerhaft sein, ohne endlos erneut eingespielt zu werden. Modellkontext sollte bewusst zusammengestellt werden, statt sich aus der Nachrichtenreihenfolge zu ergeben.
Zusammenfassung
Agenten auf Basis großer Sprachmodelle (LLMs), die Werkzeuge nutzen, stehen in einem strukturellen Spannungsverhältnis zwischen Unterhaltungsverlauf, Laufzeitzustand, Werkzeugbelegen, Erinnerungen, Datenschutz und sparsamem Kontext. Ein verbreitetes Implementierungsmuster behandelt das sichtbare Transkript zugleich als Verlauf für Nutzer und als Kontext für das Modell: Frühere Nachrichten, Werkzeugaufrufe, Werkzeugergebnisse, Zusammenfassungen, Fehler und erzeugte Artefakte werden in späteren Anfragen erneut eingespielt, bis sie gekürzt, verdichtet oder verloren sind. Dieser Ansatz ist einfach, koppelt aber das Nutzererlebnis an die Informationsverarbeitung der Runtime und macht Kontextauswahl zu einem zufälligen Nebenprodukt der Nachrichtenreihenfolge.
Dieser Artikel entwickelt das Entwurfsmuster der richtliniengesteuerten Kontextzusammenstellung. Dabei wird das Transkript als eine Projektion eines reichhaltigeren Laufzeitgraphen behandelt, statt als maßgebliche Datenquelle des Modells. Die Runtime speichert rohe Werkzeugartefakte getrennt von kompakten Werkzeug-Erinnerungen, erhält Herkunftsverweise von abgeleiteten Erinnerungen zurück zu Belegen, verfolgt Teilnehmer- und Zweigzuordnung und protokolliert Entscheidungen zur Kontextzusammenstellung unter ausdrücklichen Richtlinienversionen.
Der Artikel ordnet dieses Muster gegenüber bisherigen Arbeiten zu Context Engineering, Agentengedächtnis, Graphzustand, Event Sourcing, herkunftsbewusstem Gedächtnis, Fehlern durch veraltete Erinnerungen, Prompt-Injection und Agenten-Auditprotokollen ein. Anschließend verwendet er NanthAI:Edge als ein Umsetzungsbeispiel.
Der Artikel vertritt die Auffassung, dass der stärkste Beitrag im integrierten Laufzeitvertrag liegt: dauerhafte Werkzeugartefakte, kompakte Werkzeug-Erinnerungen, eigenständige Kontextzusammenstellungen, Richtlinienentscheidungen, teilnehmerbezogene Laufzeitzuordnung, zweigbewusste Graphauswahl, Aktualitäts- und Ersetzungsrichtlinien, Rehydrierung roher Artefakte (das gezielte Zurückladen der Rohdaten in den Kontext) und eine bewusst gesetzte Grenze zwischen der Informationsverarbeitung der Runtime und dem für Nutzer sichtbaren Transkript.
Der Beitrag umfasst einen konzeptionellen Rahmen zur Trennung von Transkript und Kontext bei Agenten mit Werkzeugnutzung, eine implementierungsorientierte Analyse der Architektur dauerhafter Artefakte und der Kontextzusammenstellung von NanthAI:Edge, einen Vergleich mit bisherigen Ansätzen aus Context Engineering und Graph-Runtimes, einen Risikokatalog für die Richtlinienebene sowie Implementierungsmessungen aus internen Vergleichsszenarien.
1. Einleitung
Im vorherigen NanthAI-Artikel schrieb ich über Skills als Werkzeugzugang. Das Problem war ein überladenes Fähigkeitsspektrum. Wenn ein Agent mehr Arbeitsabläufe, Integrationen und Fachanweisungen erhält, besteht der naive Ansatz darin, jeder Anfrage mehr Prompt-Text und Werkzeugschemas hinzuzufügen. NanthAI:Edge vermeidet das, indem es zunächst einen kompakten Skill-Katalog bereitstellt und vollständige Anweisungen erst lädt und das ausführbare Werkzeugregister erst erweitert, wenn eine Aufgabe es rechtfertigt. Das löst die eine Hälfte des Kontextproblems. Die andere zeigt sich nach der Werkzeugausführung.
Werkzeugaufrufe erzeugen Suchergebnisse, Dateien, Zitate, API-Nutzlasten, aus OAuth-Zugriffen stammende Daten, Fehler, Teilausgaben, Wiederholungszustand, erzeugte Artefakte, privaten Arbeitszustand, veraltete externe Beobachtungen, Subagentenzustand und Fortsetzungs-Checkpoints. Spielt die Runtime all das immer wieder über das sichtbare Chat-Transkript ein, wird der Modellkontext teuer, unübersichtlich und manchmal falsch.
Daraus entstehen zwei verwandte Probleme.
- Transkript-Überladung entsteht, wenn alte Werkzeugaufrufe, Werkzeugergebnisse, erzeugte Artefakte, Zusammenfassungen, neue Versuche und Betriebszustand sich im Unterhaltungsverlauf ansammeln und wiederholt an das Modell zurückgegeben werden.
- Mehrdeutiger Laufzeitzustand entsteht, wenn das Transkript gleichzeitig Nutzerverlauf, Modellgedächtnis, Auditprotokoll, Wiederholungszustand, Datenschutzgrenze und Speicher für Werkzeugbelege sein soll.
Beides ist teuer. Es verbraucht Eingabetoken, erhöht Latenz und Kosten, erschwert das Anbieter-Routing und macht schwerer erkennbar, was das Modell bei der Erzeugung einer Antwort tatsächlich wusste.
Noch wichtiger ist, dass die Korrektheit leiden kann. Ein Modell kann eine veraltete Werkzeugausgabe als aktuelle Wahrheit sehen. Ein für die Wiederholung entscheidender Fehler kann beim Zusammenfassen verloren gehen. Ein Zweig kann die erzeugte Datei eines Geschwisterzweigs erben. Private Arbeitsnotizen eines Teilnehmers können in den Kontext eines anderen Modells gelangen. Eine kompakte Zusammenfassung kann den genauen Wert verlieren, der später für ein Audit oder eine Wiederherstellung gebraucht wird.
Dieser Artikel untersucht eine strukturierte Alternative: richtliniengesteuerte Kontextzusammenstellung über einem Laufzeitgraphen.
Das Muster ist einfach: das Transkript als Verlauf für Menschen behandeln, rohe Werkzeugartefakte getrennt von Nachrichten speichern, kompakte Werkzeug-Erinnerungen aus Artefakten ableiten, Herkunftsverweise von Erinnerungen zurück zu rohen Belegen erhalten, jede Modellanfrage unter ausdrücklichen Richtlinien aus dem Graphzustand zusammenstellen und genug von der Auswahlentscheidung protokollieren, um erklären zu können, was das Modell gesehen hat und warum.
In NanthAI:Edge musste die öffentliche Chatoberfläche für diese Architektur nicht geändert werden. Nutzer sehen weiterhin Nachrichten, Werkzeugkarten, erzeugte Dateien, Zitate, Zweige, neue Versuche, Fortsetzungen und Modellantworten. Im Hintergrund trennt die Runtime Transkript, Artefakte, Erinnerungen, Richtlinienentscheidungen und Kontextzusammenstellungen.
Dieselbe Grenze gilt über Laufzeitmodi hinweg. Eine normale Chatrunde, ein Multi-Modell-Vergleich, eine autonome Diskussion, eine untergeordnete Subagentenausführung, die Fortsetzung des übergeordneten Agenten nach Subagenten, eine geplante Aufgabe und das Senden in einen Zweig haben nicht alle denselben Kontextvertrag. Eine autonome Diskussion im Debattenstil sollte Sprecherkennzeichnungen und Moderationsanweisungen bewahren. Ein untergeordneter Subagent sollte standardmäßig keinen rohen Arbeitsbereichszustand an den übergeordneten Agenten weitergeben. Die Fortsetzung des übergeordneten Agenten sollte ihren deterministischen Checkpoint beachten, statt blind das Transkript abzufragen. Die Kontextzusammenstellung muss den Laufzeitmodus berücksichtigen.
Der Artikel liefert Begriffe zur Trennung von Transkript, Kontext, Artefakt, Erinnerung und Richtlinie; eine konkrete Architektur für dauerhafte Werkzeugartefakte und kompakte Werkzeug-Erinnerungen; eine Analyse teilnehmerbezogenen Laufzeitzustands in Multi-Modell- und Subagentenabläufen; einen Vergleich mit bisherigen Ansätzen; sowie eine Einordnung von Implementierungsmessungen und ihren Grenzen.
TRANSCRIPT PROJECTION (User-Facing UI)
Ordered messages · Tool cards (truncated) · Generated files · Citations · Branches · Model responses
One projection of the same runtime graph
RUNTIME GRAPH (Durable State)
- MESSAGE (User/Assistant): User prompts; Assistant prose; Tool call / result messages (truncated for UI); Visible transcript
- MODEL RUN (Generation Attempt): Provider; Model & parameters; Participant; Message / Job ownership; Runtime mode
- TOOL CALL (Requested): Tool name; Arguments; Call ID; Status (requested / pending / failed); Model run linkage
- TOOL ARTIFACT (Raw Execution): Full arguments; Raw result or error; Status, timing; Tool version; Privacy classification; Storage handles; Hashes / byte size
- TOOL MEMORY (Compact, Model-Facing): Summary / structured data; Source artifact ID(s); Confidence + source; Freshness & stale-after; Provenance locators; Contradictions / supersession; Revalidation tools
- CONTEXT ASSEMBLY (Policy-Governed): Policy version; Assembler version; Selected memories; Rehydrated artifacts; Legacy vs assembled tokens; Omission summaries; Timing & telemetry
- MODEL REQUEST (Provider Prompt): System / instructions; Selected messages; Selected memories; Rehydrated raw (if any); Skill state; Recovery state; Provider + settings
KEY RELATIONSHIPS
Primary execution flow →
Artifacts produced by calls
Memories derived from artifacts
Policy selection & assembly
UI projection (readable view)
WHAT HAPPENS WHERE
ToolCall → ToolArtifact: Execute the tool and capture raw evidence.
ToolArtifact → ToolMemory: Extract, summarize, classify, link provenance.
ToolMemory → ContextAssembly: Policy decides what to include.
ContextAssembly → Model Request: Serialize the selected context.
Transcript Projection: Human-readable view, not the source of truth.
POLICY CONSIDERS
Ownership (participant / model run / branch)
Visibility (private / branch / conversation / audit)
Privacy & provider-routing constraints
Freshness, staleness, revalidation needs
Promotion, contradiction, supersession
Recovery state & retry protection
Context budget & raw rehydration bounds
Retention, deletion, and safety rules
OUTCOME
The model sees a deliberate, policy-governed context assembled from durable runtime state — not a blind replay of the transcript.
Smaller context. Better signal. Preserved evidence. Clear auditability.
Core Principle: Transcript is a projection for humans. Artifacts are raw truth. Memories provide compact, accountable context. Assembly is a policy decision.
2. Hintergrund: Context Engineering, Gedächtnis und Werkzeugzustand
2.1 Context Engineering
Context Engineering bedeutet, zu entscheiden, welche Informationen in den Modellkontext gelangen. Es geht über das Schreiben von Prompts hinaus. Es umfasst Systemanweisungen, Unterhaltungsverlauf, abgerufene Belege, Werkzeugausgaben, Erinnerungen, Richtlinien, Aufgabenzustand und Formatierung.
Aktuelle Empfehlungen zum Context Engineering stützen den Gedanken, Modellkontext ausdrücklich zusammenzustellen, statt ihn als rohes Transkript zu behandeln. Anthropic beschreibt Context Engineering als die Verwaltung der Informationen, die Agenten erhalten. Haystack und Atlan beschreiben Kontext ähnlich als strukturierte Bereiche wie Anweisungen, Verlauf, Abruf, Werkzeugausgaben und Erinnerungen.
Diese Unterscheidung ist wichtig, weil Kontextklassen unterschiedliche Lebensdauern und Vertrauenseigenschaften haben. Eine Nutzernachricht, eine erzeugte Datei-ID, eine OAuth-Nutzlast, ein veraltetes Suchergebnis, ein wiederholbarer Werkzeugfehler und ein Dokumentzitat sollten nicht nach derselben Regel gekürzt, zusammengefasst, aufbewahrt oder bereitgestellt werden.
Das Transkript ist besonders irreführend, weil es vollständig wirkt. Es enthält chronologische Belege dafür, dass etwas geschehen ist. Es enthält nicht unbedingt den rohen Vorgang, die erlaubende Richtlinie, den zuständigen Zweig, den Teilnehmer, der ihn gesehen hat, oder den Grund, weshalb spätere Runden ihm noch vertrauen sollten. Bei einem einfachen Chatprodukt kann Chronologie als Annäherung an Kontext genügen. Bei Agenten mit Werkzeugnutzung ist sie nur eine Achse.
Deshalb behandelt die Architektur Kontext als zusammengestellte Projektion. Sie kann aktuelle Unterhaltungsrunden, ausgewählte Werkzeug-Erinnerungen, ungelösten Werkzeugzustand, geladenen Skill-Zustand, Anbieter-/Datenschutzvorgaben und ausgewählte rohe Artefakte enthalten. Sie kann auch Datensätze auslassen, die veraltet, privat, ersetzt, für den Zweig unzulässig, über dem Budget oder für den gewählten Anbieter unsicher sind. Die Aufnahme ist eine Entscheidung, kein Zufall des Nachrichtenalters.
2.2 Agentengedächtnis
Die Forschung zum Agentengedächtnis unterscheidet üblicherweise Arbeitsgedächtnis, episodisches, semantisches und prozedurales Gedächtnis sowie Langzeitgedächtnis. Frameworks wie LangGraph unterscheiden Kurzzeit- und Langzeitgedächtnis. Übersichtsarbeiten zum Gedächtnis von LLM-Agenten betonen die weiterhin bestehende Fragmentierung: Es gibt kein etabliertes frameworkübergreifendes Schema für Erinnerungsdarstellung, Herkunft, Aktualität, Widerspruch oder Aufbewahrung.
Diese Fragmentierung ist wichtig. „Gedächtnis“ wird oft als weiter Begriff für sehr unterschiedliche Dinge verwendet: Nutzerpräferenzen, aus früheren Unterhaltungen extrahierte Fakten, Zusammenfassungen alter Dialoge, Werkzeugbeobachtungen, Referenzen auf erzeugte Dateien, abgerufene Dokumente, Aufgabenpläne, Ausführungsspuren und Herkunftsverweise.
Die Architektur trennt Nutzer-Erinnerungen von Werkzeug-Erinnerungen. Nutzer-Erinnerungen dienen der Personalisierung. Werkzeug-Erinnerungen halten aus Werkzeugartefakten abgeleitete Laufzeitbelege fest.
Diese Trennung ist mehr als eine Produkttaxonomie. Sie verhindert, dass eine Laufzeitbeobachtung allein dadurch zu einem dauerhaften Nutzerfakt wird, dass sie in einem Chat erschien. Liest ein Werkzeug einen Slack-Thread, kann daraus eine nützliche, begrenzte Erinnerung über dessen Zustand entstehen. Daraus sollte keine dauerhafte Nutzerpräferenz werden. Erstellt ein Dokumenterzeugungswerkzeug eine Datei, kann die Dateireferenz dauerhafter Betriebszustand sein. Das ist nicht dieselbe Erinnerungsart wie „der Nutzer bevorzugt knappe Antworten“.
Werkzeug-Erinnerungen benötigen deshalb Felder, die gewöhnliche Personalisierungserinnerungen oft nicht brauchen: Artefakt-IDs, Namen der Quellwerkzeuge, Datenschutzklasse, Aktualitätsklasse, Herkunftslokatoren, Konfidenzquelle, Reparaturversuche, Widerspruchsverknüpfungen, Ersetzungsverknüpfungen und Übernahmerichtlinie. Erinnerung ist in dieser Architektur nicht „was das Modell sich vielleicht merken möchte“. Sie ist eine kompakte, richtliniengesteuerte Darstellung von Belegen, für die die Runtime Rechenschaft ablegen kann.
2.3 Werkzeugspuren als Zustand
Agenten mit Werkzeugnutzung erzeugen bei jedem Werkzeugaufruf Zustand. Aufrufargumente, Ergebnis, Fehler, Zeitangaben, Anbieter, Runtime, aktiver Skill-Zustand und Zuordnungskontext können später wichtig sein.
Das wird in Industrie und Forschung zunehmend anerkannt. Databricks behandelt Werkzeugaufrufverläufe und Ausführungsergebnisse als Agentenzustand. LangGraph speichert Graphzustand und Checkpoints dauerhaft. MCP macht Werkzeuge und Kontextquellen ausdrücklich sichtbar und strukturiert protokollierbar. Arbeiten zum Event Sourcing argumentieren, dass autonome Agenten Append-only-Aufzeichnungen brauchen, die Rekonstruktion und Audit ermöglichen.
Die zentrale Schlussfolgerung lautet, dass Werkzeugergebnisse nicht nur als Transkriptnachrichten existieren sollten. Nachrichten sind zur Anzeige nützlich. Als Speicherschicht für rohe Belege sind sie schwach.
Eine Transkriptnachricht ist meist auf menschliche Lesbarkeit und Client-Kompatibilität optimiert. Sie kann gekürzt, geschwärzt, zusammengefasst, für die Darstellung umgeordnet oder durch Verdichtung entfernt werden. Genau das braucht eine Produktoberfläche. Es ist nicht das, was ein Wiederherstellungssystem benötigt, wenn der Nutzer später sagt „Verwende genau die CSV von vorhin“ oder ein Audit fragt, warum eine bestimmte Datei-ID zitiert wurde.
Die Architektur erfasst das Artefakt vor dieser darstellungsorientierten Umwandlung. Die Nachricht kann weiterhin eine übersichtliche Werkzeugkarte oder ein kompaktes Ergebnis zeigen. Der Artefaktspeicher bewahrt rohe Argumente, rohes Ergebnis oder Fehler, Hashes, Byte-Anzahlen, Speicherreferenzen, Laufzeitzuständigkeit, Datenschutzklassifizierung und Werkzeugversionsmetadaten auf, die Wiederherstellung und Audit benötigen.
2.4 Veraltete Erinnerungen und Widersprüche
Dauerhafte Erinnerungen bringen einen Fehlermodus mit sich: Der Agent kann weiter auf Informationen vertrauen, die veraltet, widerlegt oder ersetzt sind. Benchmarks wie STALE und Studien wie LOCCO verdeutlichen, dass Langzeitgedächtnis nicht automatisch zuverlässig ist. Mehr zu behalten kann das System verschlechtern, wenn alte Fakten als aktuelle Wahrheit behandelt werden.
Das spricht für ausdrückliche Aktualitäts- und Ersetzungsrichtlinien. Die Zusammenfassung eines Slack-Threads, eine CRM-Momentaufnahme, ein Kalenderverfügbarkeitsergebnis, eine Referenz auf eine erzeugte Datei und eine unveränderliche Dokumentversion sollten nicht gleich altern.
Das Problem veralteter Erinnerungen ist nicht nur, dass alte Fakten falsch werden. Oft erhält das Modell sie ohne sichtbare Ablaufmarkierung. Ein sechs Wochen altes Kalenderverfügbarkeitsergebnis und die ID einer unveränderlichen Dokumentversion können beide als „früherer Kontext“ erscheinen, wenn die Runtime nur Nachrichten erneut einspielt. Die Architektur macht diesen Unterschied durch Aktualitätsklassen und Metadaten zum Zeitpunkt des Veraltens ausdrücklich sichtbar.
Widersprüche sind der verwandte Fehlermodus. Zwei Erinnerungen können aus echten Artefakten abgeleitet sein und dennoch widersprechen, weil sie aus unterschiedlichen Dokumentversionen, Zweigen, Anbietern oder Extraktionsverfahren stammen. Das System sollte diese Datensätze nicht zu einer einzigen Zusammenfassung nach dem Prinzip „letzter Schreibzugriff gewinnt“ verschmelzen, sofern eine Richtlinie nicht über genügend Herkunfts- und Konfidenzinformationen verfügt, um diese Auflösung zu rechtfertigen.
2.5 Herkunft und Audit
Herkunftsbewusstes Gedächtnis ist ein aufkommendes Thema. MemORAI verknüpft Graph-Erinnerungen mit Quellrunden. Portable Agent Memory schlägt Erinnerungsobjekte mit geprüfter Herkunft vor. ARGUS verwendet Einfluss-Herkunftsgraphen, um unsichere Werkzeugaufrufe zu untersuchen. Auch die Literatur zu Auditprotokollen und Event Sourcing argumentiert, dass KI-Systeme rekonstruierbare Verläufe von Daten-, Modell-, Werkzeug- und Entscheidungsereignissen benötigen.
Für eine Agenten-Runtime lautet die wichtige Auditfrage:
Warum hat das Modell das gesagt?
Die Antwort kann nicht allein aus dem Transkript kommen. Man muss wissen, welcher Kontext zusammengestellt wurde, welche Erinnerungen enthalten waren, welche rohen Artefakte rehydriert wurden, welche Richtlinien Daten ausgelassen haben und welchem Teilnehmer oder Zweig der Zustand zugeordnet war. Eine zweite Auditfrage ist ebenso wichtig:
Warum hat das Modell etwas nicht gesehen?
Hier unterscheidet sich richtliniengesteuerte Zusammenstellung von gewöhnlicher Protokollierung. Ein Produktionsvorfall muss nicht durch ein schlechtes Werkzeugergebnis verursacht werden. Er kann entstehen, weil ein nützliches Ergebnis ausgeschlossen wurde: Es war veraltet, über dem Budget, für den Zweig unzulässig, für einen anderen Teilnehmer privat, als von Google abgeleitete Daten klassifiziert oder von der Rehydrierung roher Daten ausgeschlossen. Die Architektur protokolliert kompakte Zusammenfassungen von Auslassungen, damit die Fehlersuche nach Abwesenheit und nicht nur nach Anwesenheit fragen kann.
3. Richtliniengesteuerte Kontextzusammenstellung
Richtliniengesteuerte Kontextzusammenstellung behandelt Modellkontext als Projektion über dem Laufzeitzustand. Das Transkript wird nicht verworfen. Es bleibt der Verlauf für Menschen. Es muss aber nicht länger jede Laufzeitverantwortung tragen.
Die Runtime unterscheidet Transkriptnachrichten, Modellausführungen, Werkzeugaufrufe, rohe Werkzeugartefakte, kompakte Werkzeug-Erinnerungen, geladenen Skill-Zustand, Fortsetzungs-Checkpoints, Zweigabstammung, Teilnehmerzuordnung, Richtlinienentscheidungen und Kontextzusammenstellungsprotokolle. Ein Kontext-Assembler kann dann anhand von aktueller Aufgabe, Zweig, Teilnehmer, Anbieter, Datenschutzrichtlinie, Aktualitätsrichtlinie und Wiederherstellungszustand auswählen, was das Modell sieht.
Dieses Muster trennt vier oft vermischte Bereiche. Das Transkript dient dem Nutzer: lesbar, stabil und produktgerecht. Der Artefaktspeicher dient der Runtime- und Auditebene: rohe Belege, Wiederherstellbarkeit und Aufbewahrungsrichtlinie. Werkzeug-Erinnerungen dienen dem Modellkontext: kompakt, mit Herkunft verknüpft und aktualitätsbewusst. Die Kontextzusammenstellung dient der Modellanfrage selbst: der richtliniengesteuerten Auswahl für eine Generierung.
Die wichtigste Beziehung lautet:
Werkzeugausführung erzeugt zuerst Artefakte; Erinnerung ist eine darüberliegende Richtlinienentscheidung.
Das ist der konzeptionelle Kern der Architektur. Die zweite Beziehung lautet:
Kontextzusammenstellung ist eine durch Richtlinien begrenzte Graphabfrage, keine Transkriptumwandlung.
Der Assembler beginnt an der aktiven Generierungsgrenze: aktueller Chat, auslösende Nutzernachricht, Zweigabstammung, Teilnehmer, Laufzeitart, Fortsetzungszustand, gewählter Anbieter, geladene Skills und Werkzeugverfügbarkeit. Dann wählt er zulässige Graphdatensätze aus und entscheidet, wie jeder erscheinen soll. Eine aktuelle Nachricht kann Unterhaltungskontext bleiben. Eine Werkzeugbeobachtung kann als kompakte Erinnerung eingehen. Ein veralteter Datensatz kann nur als Markierung „veraltet“ mit Hinweis zur erneuten Prüfung erscheinen. Ein rohes Artefakt kann rehydriert werden, wenn genaue Belege nötig sind. Ein ungelöster Werkzeugaufruf kann als Wiederherstellungszustand geschützt werden. Ein privater, veralteter, ersetzter, zweigunzulässiger oder anbieterbeschränkter Datensatz kann ausgelassen werden. Der Grund wird protokolliert, ohne den Inhalt offenzulegen.
Dieser Entwurf verlangt nicht, dass jeder Abruf über eine Graphdatenbank erfolgt. Der Graph ist das Laufzeitmodell: verknüpfte Unterhaltungen, Zweige, Teilnehmer, Modellausführungen, Werkzeugaufrufe, Artefakte, Erinnerungen, Checkpoints, Zusammenstellungen und Richtlinienentscheidungen. Vektorsuche, indizierte Tabellenabfragen, Speicherlesezugriffe und Graphdurchläufe können innerhalb dieses Modells Implementierungstechniken sein.
Ein hilfreiches Denkmodell ist:
Für Nutzer sichtbares Transkript = eine lesbare Projektion ausgewählter Message-Knoten
Kontext für das Modell = eine richtlinienbasierte Projektion über Message + ToolMemory + ToolArtifact + SkillState + ContinuationCheckpoint + PolicyDecision + Zweigabstammung
Der Unterschied ist nicht akademisch. Ein Transkript beantwortet: „Was haben Nutzer und Assistent anscheinend gesagt?“ Ein Laufzeitgraph beantwortet die Fragen, die das Transkript nicht beantworten kann: Welche Modellausführung erzeugte die Antwort, welche Werkzeuge forderte sie an, welche Artefakte erzeugten diese Werkzeuge, welche Erinnerungen wurden daraus abgeleitet, welchem Zweig und Teilnehmer war der Zustand zugeordnet, welche Richtlinie erlaubte oder verwarf jeden Datensatz und welche älteren Erinnerungen waren veraltet, widerlegt oder ersetzt?
Diese Fragen machen den Graphansatz wertvoll. Er macht aus der Kontextauswahl eine Abfrage über typisierte Beziehungen statt einer Kürzungsstrategie über einer Nachrichtenliste.
Praktisch hat der Graphansatz drei Aufgaben. Er bewahrt Belege, indem er rohe Werkzeugartefakte außerhalb des Transkripts unter Aufbewahrungs- und Datenschutzrichtlinien erhält. Er erzeugt kompakten, nutzbaren Kontext, indem er nützliche Artefaktinhalte in Werkzeug-Erinnerungen für gewöhnliche Modellaufrufe umwandelt. Und er erklärt die Auswahl, indem er protokolliert, warum ein Modell eine bestimmte Projektion des Graphen statt einer anderen sah.
Der Graph muss für Nutzer nicht sichtbar sein. Der Nutzer sieht die Unterhaltung. Die Runtime verwendet den Graphen, um zu entscheiden, was der nächste Modellaufruf wissen sollte.
TRADITIONAL TRANSCRIPT REPLAY
- Message
- Message
- Message
- Message
- LARGE PROMPT
Replays old tool calls and results
Includes stale, private, and noisy data
Loses important structure and provenance
Wasteful, expensive, error-prone
POLICY-GOVERNED ASSEMBLY
- RAW ARTIFACTS
- COMPACT MEMORIES
- SELECTED CONTEXT
- MODEL REQUEST
Keeps raw evidence out of the prompt
Includes only relevant, current, and allowed data
Preserves provenance and recovery state
Smaller, faster, safer, and more reliable
4. Implementierungsmuster
Dieser Abschnitt beschreibt die konkrete Form des Musters, wie es in NanthAI:Edge umgesetzt ist. Die Details sind hilfreich, weil sie zeigen, was vorhanden sein muss, sobald das Transkript nicht mehr die maßgebliche Datenquelle für den Modellkontext ist.
4.1 Laufzeitgraphmodell
Der Laufzeitgraph beginnt damit, die wichtigen Begriffe ausdrücklich zu modellieren. Eine Conversation ist der dem Nutzer gehörende Chatcontainer. Ein Branch ist ein geordneter Pfad durch diesen Unterhaltungsgraphen, der früheren gemeinsamen Verlauf erbt. Ein Participant ist die für eine Ausführung aktive Modell- oder Persona-Konfiguration. Eine Message ist der für Nutzer sichtbare Transkriptknoten. Ein ModelRun ist ein Generierungsversuch beim Anbieter für einen Teilnehmer, eine Nachricht oder eine Aufgabe.
Werkzeugarbeit erhält dann eigene Begriffe. Ein ToolCall ist der vom Modell angeforderte Funktionsaufruf mit Argumenten und Aufruf-ID. Ein ToolArtifact ist der dauerhafte rohe Ausführungsdatensatz für diesen Aufruf oder dieses Ergebnis. Eine ToolMemory ist die aus einem oder mehreren Artefakten abgeleitete kompakte Erinnerung für das Modell. SkillState erfasst geladene Skills, aktive Profile, direkte Werkzeuge und den für eine Ausführung sichtbaren Integrationszustand. Ein ContinuationCheckpoint speichert fortsetzbaren Laufzeitzustand über Aktionsgrenzen hinweg.
Auch die Zusammenstellungsebene ist ausdrücklich modelliert. Eine ContextAssembly ist der versionierte Entscheidungsdatensatz für eine Prompt-Zusammenstellung für das Modell. Eine PolicyDecision protokolliert Entscheidungen zu Datenschutz, Aktualität, Kürzung, Rehydrierung, Anbieter-Routing oder Wiederherstellung.
Die kanonischen Beziehungen sind überschaubar.
- Assistenteninhalte im Transkript werden von einem bestimmten ModelRun erzeugt.
- Ein ModelRun fordert einen oder mehrere ToolCall-Datensätze an.
- Jeder ausgeführte, fehlgeschlagene, ausstehende oder aufgeschobene ToolCall erzeugt ein dauerhaftes ToolArtifact.
- Aus diesem Artefakt wird eine ToolMemory abgeleitet, wobei die Herkunft bis zu den rohen Belegen erhalten bleibt.
- Zweige erben von früheren Zweigen, ohne den gesamten Zustand zu kopieren.
- Eine ContextAssembly protokolliert, welche Erinnerungen aufgenommen und welche rohen Artefakte rehydriert wurden.
- Ein ContinuationCheckpoint stellt Laufzeitzustand statt bloß Transkriptnachrichten wieder her.
- Eine PolicyDecision begrenzt die Zusammenstellung, sodass Entscheidungen zu Datenschutz, Anbieter, Aktualität, Kürzung und Wiederherstellung ausdrücklich festgehalten sind.
Runtime graph
- Conversation
- Branch
- Participant
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- Participant
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- Participant
- Branch
Tool memories across the active lineage → ContextAssembly → PolicyDecision → Checkpoint
Relationships
Conversation contains / has Branches; Branches inherit from the conversation.
Branches contain Participants; Participants contain Messages; Messages generate ModelRuns.
ModelRun requests ToolCall; ToolCall produces ToolArtifact; ToolMemory is derived from ToolArtifact.
ToolMemory is assembled into ContextAssembly. ContextAssembly is constrained by PolicyDecision. Checkpoint restores state.
Legend: contains / has; inherits from; generates; requests; derived from; assembled into; constrained by; restores.
4.2 Dauerhafte Werkzeugartefakte
Ein ToolArtifact ist der dauerhafte rohe Datensatz einer Werkzeugausführung.
Es erfasst Werkzeugaufruf-ID, Werkzeugname, Argumente, rohes Ergebnis oder Fehler, Status, Nachrichten- und Aufgabenzuordnung, Teilnehmer- und Modellausführungszuordnung, Zweiggeltung, Datenschutzklassifizierung, aktive Skills und Werkzeugprofile, Anbieter- und Laufzeitmetadaten sowie Speicherreferenzen für übergroße Argumente oder Ergebnisse.
Werkzeugergebnisse auf Nachrichtenebene können für Client-Kompatibilität und Darstellung weiterhin existieren. Sie können gekürzt, zusammengefasst oder für die Oberfläche aufbereitet werden. Für die Anzeige ist das in Ordnung. Für lange Arbeitsabläufe, Audit, erneute Versuche oder exakte Rehydrierung reicht es nicht.
Der wichtige Schritt ist, vollständige Artefakte vor der Kürzung auf Nachrichtenebene zu erfassen. Die Oberfläche kann kompakt bleiben, während das Backend wiederherstellbare Belege behält.
Das ist wichtig, wenn eine spätere Runde genau die CSV aus einem früheren Werkzeugaufruf benötigt, ein fehlgeschlagener Aufruf wiederholt werden muss, eine aufgeschobene Auswahl fortgesetzt werden muss, ein zitiertes Dokument erklärt werden soll, eine erzeugte Datei-ID erhalten bleiben muss, die Ausgabe eines Subagenten geprüft werden muss oder eine private Werkzeugnutzlast aus den Kontexten anderer Modelle herausgehalten werden muss.
4.3 Werkzeug-Erinnerungen
Eine ToolMemory ist ein kompakter Datensatz für das Modell, der aus einem oder mehreren Artefakten abgeleitet wird.
Werkzeug-Erinnerungen sind von Nutzer-Erinnerungen getrennt. Nutzer-Erinnerungen stehen für Personalisierung und dauerhafte Nutzerfakten. Werkzeug-Erinnerungen stehen für Laufzeitbelege und aus Werkzeugen abgeleiteten Zustand.
Werkzeug-Erinnerungen enthalten Quellartefakt-IDs, Namen der Quellwerkzeuge, Zusammenfassungstext, strukturierte Nutzlasten, Konfidenz, Konfidenzquelle, Konfidenzbegründung, Hinweise auf Mehrdeutigkeiten und Grenzen, Datenschutzklassifizierung, Aktualitätsklasse, Zeitpunkt des Veraltens, Werkzeuge zur erneuten Prüfung, Herkunftslokatoren, letzten Auflösungsstatus, Reparaturversuche, Widerspruchsverknüpfungen, Ersetzungsverknüpfungen und Übernahmerichtlinie.
Das Ziel ist nicht, dass das Modell alles behält. Das Ziel ist nachvollziehbare Erinnerung. Eine kompakte Erinnerung sollte genügend Herkunftsinformationen bewahren, damit das System später beantworten kann, woher sie stammt, ob sie noch gültig ist und ob genaue rohe Belege rehydriert werden können oder sollten.
- 1. USER REQUEST: User asks a question or gives a task
- 2. MODEL RUN: Model decides to call one or more tools
- 3. TOOL CALL(S): Tool(s) executed with arguments from the model
- 4. TOOL ARTIFACT: Raw result or error captured as durable evidence (artifact)
- 5. TOOL MEMORY: Compact memory derived from artifact(s) with provenance
- 6. CONTEXT ASSEMBLY: Policy selects what to include, what to rehydrate, what to omit, and why
- 7. MODEL REQUEST: Assembled context sent to the model for the next generation
FEEDBACK LOOPS (as needed)
Revalidation · Retries · Continuations · Checkpoints · Branches · Subagent Promotion
Feedback returns to the relevant execution and context stages.
4.4 ContextAssembly
ContextAssembly ist der eigenständige Datensatz darüber, was in eine bestimmte Modellanfrage eingegangen ist.
Er speichert Nachrichtenanzahl des bisherigen Ansatzes, zusammengestellte Nachrichtenanzahl, geschätzte Token-Differenz, Anzahl roher Artefakte, ausgewählter Erinnerungen und rehydrierter Artefakte, Richtlinienversion, Assembler-Version, ausgewählte Graphverweise, Auslassungszusammenfassungen, Sicherheits- und Datenschutzentscheidungen sowie Zeitmessungen für Graphabfrage, Richtlinienauswertung und Serialisierung.
Das Auditziel lautet:
Warum hat das Modell diesen Kontext gesehen?
Die Antwort sollte nicht lauten: „Weil er in den letzten N Nachrichten stand.“ Sie sollte eher so aussehen:
Diese Antwort enthielt ToolMemory_123, abgeleitet aus ToolArtifact_88, vom aktiven Zweig geerbt, für diesen Teilnehmer sichtbar und unter Richtlinienversion 4 zusammengestellt. Die Rehydrierung des rohen Artefakts wurde übersprungen, weil die kompakte Erinnerung ausreichte.
Oder:
Diese Antwort ließ eine von Google abgeleitete rohe Nutzlast aus, weil die Anbieter-Routing-/Datenschutzrichtlinie sie als beschränkt einstufte, enthielt aber eine unbedenkliche Zusammenfassung und einen Hinweis auf ein Werkzeug zur erneuten Prüfung.
4.5 PolicyDecision
Kontextzusammenstellung ist Richtlinienauswertung, nicht nur Kürzung.
- Zuordnungsrichtlinie fragt, welchem Teilnehmer oder welcher Modellausführung ein Datensatz gehört.
- Sichtbarkeitsrichtlinie entscheidet, ob er teilnehmerprivat, zweigsichtbar, unterhaltungssichtbar oder nur für Audits bestimmt ist.
- Datenschutzrichtlinie bestimmt, ob die Daten an das gewählte Modell oder den Anbieter gesendet werden dürfen.
- Aktualitätsrichtlinie entscheidet, ob ein Datensatz aktuell, veraltet, dauerhaft oder erneut zu prüfen ist.
- Übernahmerichtlinie entscheidet, ob ein Artefakt zu einer Erinnerung für das Modell werden soll.
- Rehydrierungsrichtlinie entscheidet, ob eine kompakte Erinnerung genügt oder genaue rohe Belege erforderlich sind.
- Widerspruchs- und Ersetzungsrichtlinie lösen Konflikte und Ersetzungen auf.
- Wiederherstellungsrichtlinie schützt ungelösten, fehlgeschlagenen, aufgeschobenen oder für erneute Versuche wichtigen Zustand.
- Aufbewahrungsrichtlinie entscheidet, ob der Datensatz behalten, gekürzt, archiviert oder gelöscht werden soll.
Die Implementierung protokolliert kompakte Richtlinienzusammenfassungen und Auslassungszahlen statt ausführlicher Spuren für jeden Datensatz jeder Zusammenstellung im Produktivbetrieb. Detaillierte Spuren bleiben in Tests und gezielten Audits verfügbar.
| Scenario | Policy Decision | Action | In Context? | Why |
|---|---|---|---|---|
| Google Gmail body (ZDR provider) | Privacy / Provider Restriction | Omit raw body, include safe summary + revalidation tool | Partial | Provider cannot receive Google content |
| Slack thread summary (2 weeks old) | Freshness (Bounded) | Include as stale marker + revalidation tool | Stale | May be outdated, needs recheck |
| Generated CSV file handle | Durability (Session) | Include compact memory (file ID, schema) | Yes | Still valid in session, low risk |
| Sibling branch analysis result | Branch Visibility (Branch-Private) | Omit from active branch context | No | Different branch, not relevant |
| Failed tool call (retry needed) | Recovery (Protected) | Include error + retry state | Yes | Required for recovery |
Every inclusion or omission is logged with policy version, reason, and scope.
4.6 Kontextklassen
Kontext wird danach klassifiziert, wie er gekürzt, aufbewahrt, zusammengefasst, rehydriert und bereitgestellt werden sollte.
- Unterhaltungskontext umfasst Nutzer- und Assistententexte oder zweiglokale Diskussionen und kann durch Fenster begrenzt und zusammengefasst werden.
- Betriebskontext umfasst Werkzeugargumente, Werkzeugergebnisse, Arbeitsbereichspfade und erzeugte Datei-IDs. Er sollte vor dem Zusammenfassen als Artefakt bewahrt werden.
- Erkenntniskontext umfasst Aussagen, Erkenntnisse und extrahierte Fakten und gehört mit Konfidenz- und Aktualitätsmetadaten in Werkzeug-Erinnerungen.
- Herkunftskontext umfasst Artefakt-IDs, Dokument-IDs und Zitate und sollte für Audits bewahrt oder rehydriert werden, wenn Aussagen davon abhängen.
- Richtlinienkontext umfasst Anbietervorgaben, OAuth-Berechtigungsumfang und Zugangsberechtigungen und muss vor der Zusammenstellung durchgesetzt werden.
- Wiederherstellungskontext umfasst Fehler, aufgeschobenen Zustand und Wiederholungsverträge und sollte im ungelösten Zustand nicht gekürzt werden.
- Planungskontext umfasst geladene Skills, aktive Profile und Aufgabenzerlegung für die aktuelle Ausführung oder Fortsetzung.
Das verhindert, dass das Nachrichtenalter zur einzigen Kürzungsregel wird.
4.7 Aktualität und Veralten
Werkzeug-Erinnerungen dürfen nicht stillschweigend zu ewigen Wahrheiten werden. Jede Werkzeug-Erinnerung erhält eine Aktualitätsklasse:
- Flüchtige Erinnerungen betreffen etwa Ungelesen-Zähler, Verfügbarkeit und Suchrangfolgen.
- Sitzungserinnerungen betreffen temporäre Laufzeitdateien, Arbeitsverzeichnisse und Arbeitszustand.
- Zeitlich begrenzte Erinnerungen betreffen Momentaufnahmen wie CRM-Datensätze, Slack-Thread-Zusammenfassungen oder Notion-Seitenzustand.
- Dauerhafte Erinnerungen betreffen Metadaten erzeugter Dateien, Dokumentzitate und explizite Anbieter-Entitäts-IDs.
- Permanente Erinnerungen betreffen unveränderliche Dokumentversions-IDs oder Identitäten erzeugter Speicherartefakte.
Der Assembler fügt veraltete flüchtige oder zeitlich begrenzte Erinnerungen standardmäßig nicht als aktuelle Fakten ein. Er kann sie als veralteten Kontext aufnehmen, einen Weg zur erneuten Prüfung bereitstellen, sie auslassen oder rohe Daten rehydrieren, wenn genaue Belege erforderlich und erlaubt sind.
4.8 Widerspruch und Ersetzung
Dieser Ansatz vermeidet nach Möglichkeit Erinnerungen nach dem Prinzip „letzter Schreibzugriff gewinnt“.
Werkzeug-Erinnerungen können sich widersprechen. Ein Zweig analysiert vielleicht einen Dokumententwurf und zieht eine Schlussfolgerung. Ein anderer analysiert eine spätere Version. Eine Anbieterabfrage meldet vielleicht eine Mitarbeiterzahl, der eine spätere Abfrage widerspricht. Ein Modell fasst eine Quelle falsch zusammen, während ein anderes den genauen Wert aus der Rohdatei extrahiert.
Die Runtime verfolgt Konflikt- und Ersetzungsverknüpfungen, Konfidenz, Konfidenzquelle, Quellartefakte, Grenzen und Mehrdeutigkeitshinweise. Die wichtigen Felder sind gerichtet: conflictsWith markiert einen Widerspruch, supersedes bedeutet, dass die aktuelle Erinnerung ältere ersetzt, und supersededBy verweist von einer überholten Erinnerung auf ihren Ersatz zurück.
Die Richtlinie ist zurückhaltend. Widersprüchliche Erinnerungen bleiben getrennte Datensätze. Ersetzte Erinnerungen werden normalerweise aus dem aktuellen Modellkontext ausgelassen, während der aktuelle Ersatz auswählbar bleibt. Wenn Unsicherheit wichtig ist, können beide Seiten eines Widerspruchs aufgenommen werden. Die Auflösung erfordert Herkunft und Konfidenz, nicht nur Aktualität.
Ein praktisches Detail ist wichtig: supersedes sollte bedeuten „diese aktuelle Erinnerung ersetzt ältere Erinnerungen“. Die Gegenrichtung sollte ein separates Feld wie supersededBy verwenden.
Das klingt klein, doch Mehrdeutigkeit kann hier echte Fehler verursachen. Ein Kontext-Assembler, der die ersetzende statt der überholten Erinnerung verwirft, kann das Modell aus veraltetem Zustand schlussfolgern lassen und dabei glauben, besonders sorgfältig zu sein.
4.9 Teilnehmer- und Laufzeitzuordnung
NanthAI:Edge unterstützt Multi-Modell-Ausführungen, autonome Diskussionen, Subagenten, Zweige, geplante Aufgaben und werkzeugreiche Fortsetzungen. Das macht die Zuordnung wichtig.
Eine sichtbare Assistentennachricht kann zu gemeinsamem Unterhaltungskontext werden.
Roher Laufzeitzustand sollte aber nicht automatisch gemeinsam werden, nur weil er im selben Chat entstanden ist.
In dieser Architektur tragen Werkzeugartefakte, Werkzeug-Erinnerungen, Kontextzusammenstellungen und Fortsetzungs-Checkpoints Zuordnungsmetadaten wie visibilityScope, ownerParticipantId, ownerModelRunId, sharedWithParticipants, runtimeIsolationPolicy und runtimeKind.
Standardmäßig ist der Zustand einer Modellausführung teilnehmerbezogen und isoliert. Für Nutzer sichtbare Assistentenausgaben können nach Abschluss zu Zweig- oder Unterhaltungskontext werden. Privater Arbeitszustand gelangt nicht zu anderen Teilnehmern. Ungelöste Werkzeugaufrufe bleiben für den zuständigen Teilnehmer und erforderliche Fortsetzungen sichtbar. Artefakte untergeordneter Subagenten bleiben privat oder nur für Audits bestimmt, bis sie ausdrücklich freigegeben werden.
Das ist einer der weniger dokumentierten Bereiche der Agentenarchitektur.
Viele Multi-Agenten-Beispiele behandeln Zusammenarbeit. Weniger definieren die Grenze zwischen dem, was ein Modell sichtbar gesagt hat, was es privat gesehen hat, was seine Werkzeuge zurückgaben, was ein untergeordneter Subagent entdeckte, was der übergeordnete Agent später nutzen darf und was nur für Audits bestimmt bleibt.
Diese Architektur macht die Grenze ausdrücklich sichtbar.
4.10 Zweigbewusste Graphzusammenstellung
NanthAI-Unterhaltungen können sich verzweigen. Deshalb kann Kontextzusammenstellung nicht nur „neue Erinnerungen nach Chat-ID abrufen“ bedeuten. Wenn zwei Zweige unterschiedliche Dokument-IDs, Dateien oder Analyseergebnisse erzeugen, sollte der aktive Zweig nicht durch neuere Artefakte eines Geschwisterzweigs verunreinigt werden.
Die Lösung ist eine zweigbewusste Zusammenstellung. Kandidaten werden zuerst aus der Abstammungslinie des aktiven Zweigs ausgewählt. Ausdrücklich geteilte oder unterhaltungsweite Datensätze können übrige Plätze füllen. Privater Zustand von Geschwisterzweigen verdrängt jedoch keinen Kontext des aktiven Zweigs.
Die Kontextzusammenstellungsprotokolle erfassen Zweigausschlüsse getrennt von normalen Auslassungen wegen des Kontextbudgets. Das ist wichtig, weil Zweigfehler subtil sind. Das Modell kann selbstbewusst mit einer Datei, einem Zitat oder einer Dokument-ID antworten, die zu einem anderen Zweig gehören. Die Oberfläche sieht korrekt aus. Das Transkript wirkt plausibel. Die Runtime hat jedoch zwei unvereinbare Pfade vermischt.
Zweigbewusste Zusammenstellung behandelt die Unterhaltung als Graphen, nicht als flache Nachrichtenliste.
BROKEN: TRANSCRIPT REPLAY (BRANCH POLLUTION)
- Root conversation → Branch Point (User question)
- Branch A (Active) → Generates File_A.csv
- Branch B (Sibling) → Generates File_B.csv
- Active Branch A – Next Call Context: Root conversation; Branch A messages; File_A.csv (correct); Branch B messages (leaked); File_B.csv (incorrectly included)
Linear transcripts can leak sibling branch artifacts into the active branch.
POLLUTION EXAMPLE: When Branch A asks a follow-up, transcript replay includes everything in the history — including artifacts from Branch B.
Result: Sibling branch contamination, higher token cost, and incorrect or confusing model context.
CORRECT: BRANCH-AWARE ASSEMBLY
- Root conversation → Branch Point (User question)
- Branch A (Active) → File_A.csv
- Branch B (Sibling) → File_B.csv (Private to B); Explicit Share (Optional) → Branch A
- Active Branch A – Next Call Context: Root conversation; Branch A messages; File_A.csv (correct); Shared from B (if any); Branch B private items (excluded)
Assembler selects only active lineage and explicitly shared records.
ASSEMBLY RULES (Examples): Include active lineage only; Include explicitly shared records; Respect branch-private boundaries; Apply policy and freshness rules; Avoid sibling branch leakage.
Result: Clean, relevant context. Lower token cost. No branch leakage. Policy-governed and auditable.
Legend: Active Branch; Sibling Branch; Branch Point; Message; Artifact / Generated File; Explicitly Shared; Branch-Private (Not Visible); Active Lineage; Sibling Lineage; Explicit Share; Leak / Pollution (Bad).
4.11 Rehydrierung roher Artefakte
Kompakte Erinnerung genügt meistens. Manchmal nicht. Fragt der Nutzer „Verwende genau die vorherige CSV“, reicht eine Zusammenfassung nicht aus. Die Runtime muss das rohe Artefakt zurückholen.
Die Architektur unterstützt eine begrenzte Rehydrierung roher Artefakte. Das wichtige Wort ist begrenzt. Speicherbasierte rohe Artefakte werden erst nach richtlinienbasierter Auswahl rehydriert, nicht vorsorglich.
Der Assembler prüft, ob genaue Details benötigt werden, ob das Artefakt ausgewählt wurde, ob die Datenschutzklassifizierung erlaubt ist, ob das Byte-Budget eingehalten wird, ob der Anbieterweg erlaubt ist und ob der Datensatz ungelöst oder für die Wiederherstellung kritisch ist.
- Falls ja, kann das rohe Artefakt aufgenommen werden.
- Falls nein, kann der Assembler eine kompakte Erinnerung, einen Verweis, eine Markierung „veraltet“, einen Hinweis zur erneuten Prüfung oder nichts aufnehmen.
Das vermeidet zwei schlechte Extreme: rohe Werkzeugnutzlasten endlos erneut einzuspielen und Belege wegzuzusammenfassen, die spätere Runden genau benötigen.
POLICY-GOVERNED ASSEMBLY
- RAW ARTIFACTS
- COMPACT MEMORIES
- SELECTED CONTEXT
- MODEL REQUEST
Keeps raw evidence out of the prompt
Includes only relevant, current, and allowed data
Preserves provenance and recovery state
Smaller, faster, safer, and more reliable
4.12 Informationsverarbeitung der Runtime ist nicht UX
Diese Architektur fügt viel internen Laufzeitzustand hinzu. Dieser gehört nicht automatisch in die Chatoberfläche. Werkzeug-Erinnerungen, Kontextzusammenstellungen, Richtlinienentscheidungen, Herkunftsreparaturdatensätze, Auslassungszahlen und Graphabfragespuren gehören zur Informationsverarbeitung der Runtime.
Sie sollten nicht zu Unterhaltungstext werden, außer der Nutzer fragt nach einer Audit-/Debug-Erklärung oder öffnet gezielt eine Inspektionsansicht.
Diese Grenze ist wichtig. Viele KI-Produkte verwischen sie. Der Assistent beginnt, seine Erinnerungen, Richtlinien, internen Zustände und Werkzeugbuchführung in die Unterhaltung hineinzuerzählen.
Das macht das Transkript unübersichtlicher und oft weniger vertrauenswürdig. In NanthAI:Edge bleibt das Transkript für Nutzer die Produktoberfläche. Der Laufzeitgraph bleibt die Ausführungsebene.
Herkunft kann über Zitate, Karten erzeugter Dateien, Debug-Ansichten oder eine künftige Inspektionsansicht „Warum hat das Modell das gesagt?“ sichtbar werden.
Die Runtime sollte aber nicht den Unterhaltungsverlauf umschreiben, um sich selbst zu erklären.
4.13 Grenzen zwischen Laufzeitmodi
Unterschiedliche Laufzeitmodi brauchen unterschiedliche Zusammenstellungsregeln. Normaler Chat und Multi-Modell-Chat verwenden zweigbewusst zusammengestellten Kontext für den aktiven Teilnehmer. Autonome Diskussionen bewahren Debatten-Prompt-Struktur, Moderationsanweisungen, Sprecherkennzeichnungen und unterstützte nichttextliche Inhalte und ergänzen für den Teilnehmer sichtbaren zusammengestellten Kontext. Eine untergeordnete Subagentenausführung erfasst lokale Werkzeugartefakte und Erinnerungen mit Zuordnung zum untergeordneten Agenten, standardmäßig privat oder nur für Audits. Die Fortsetzung eines übergeordneten Agenten behält ihren deterministischen Checkpoint, fügt ausgewählte Zusammenstellungsverweise an und protokolliert die Wiederherstellungsentscheidung, statt blind das Transkript abzufragen. Geplante Aufgaben nutzen den normalen Backend-Generierungsweg, auf dem die Aufgabe Chatrunden erzeugt und in die Generierung weiterleitet. Das Senden in Ideascape-Zweige verwendet denselben zweigbewussten Generierungsweg, nachdem der Client ausdrückliche Eltern-IDs gesendet hat.
Das war ein wichtiger Abschlussschritt, weil die schwierigsten Kontextfehler oft an Orchestrierungsgrenzen liegen. Eine normale Chatrunde kann den aktiven Zweig und Teilnehmer direkt verwenden. Eine Fortsetzung nach Subagenten ist anders: Der übergeordnete Agent sollte freigegebene Zusammenfassungen der untergeordneten Agenten, Referenzen auf erzeugte Dateien, den Status fehlgeschlagener Agenten und wiederholungsrelevanten Zustand erhalten, aber keine rohen Nutzlasten aus deren Arbeitsbereichen, sofern diese nicht ausdrücklich freigegeben wurden.
Das erfordert bei Bedarf Metadaten wie Laufzeitart, Subagenten-Batch-/Ausführungs-IDs, übergeordnete Nachrichten-/Aufgaben-IDs, übergeordnete Werkzeugaufruf-IDs und Freigabeentscheidungen. Es geht nicht darum, um seiner selbst willen mehr Schema zu schaffen. Es geht darum, Zuordnungs- und Freigabeentscheidungen darstellbar zu machen, bevor der Assembler etwas in eine Anbieteranfrage serialisiert.
4.14 Freigabegrenzen bei Subagenten
Subagenten machen die Trennung von Transkript und Kontext konkret.
Ein untergeordneter Subagent kann Werkzeuge aufrufen, Dokumente lesen, Zwischendateien erzeugen, auf Fehler stoßen und privaten Arbeitszustand pflegen. Der übergeordnete Agent braucht möglicherweise nur den Abschlussbericht, eine Referenz auf eine erzeugte Datei, eine kompakte Fehlerzusammenfassung oder einen Batch-Status. Speichert die Runtime untergeordneten Zustand nur als transkriptartige Nachrichten, liegt es nahe, zu viel an den übergeordneten Agenten weiterzugeben. Verwirft sie den Zustand nach dem Zusammenfassen, leiden Audit und Wiederherstellung.
Die Runtime verwendet eine Freigabesemantik. Rohe Werkzeugargumente und -ergebnisse untergeordneter Agenten sind standardmäßig privat oder nur für Audits bestimmt. Referenzen auf erzeugte Dateien werden nach der Freigabe beim Abschluss des untergeordneten Agenten für den übergeordneten Agenten sichtbar. Der Abschlussbericht ist bei dessen Fortsetzung sichtbar. Der Status fehlgeschlagener oder abgelaufener untergeordneter Agenten kann als kompakter Wiederherstellungskontext freigegeben werden. Arbeitsnotizen oder Arbeitsbereichsdetails sind für den übergeordneten Agenten nur bei ausdrücklicher Freigabe sichtbar.
Damit erhält der übergeordnete Agent genug Kontext zum Weitermachen, ohne dass jede untergeordnete Ausführung zu rohem Transkriptballast wird.
Parent Agent (Orchestrator) — Before Subagent Call
- User request: “Research ACME Corp and prepare a report.”
- Subagent Call: Task scope, inputs, and constraints
Parent State (continues): Conversation history; Long-term memories; Policy & preferences; Runtime checkpoints
Child Subagent (Isolated Runtime) — Owns private runtime state and working context
Does Private Work: Tool Calls — Executes tools and external API calls; Raw Tool Payloads — Full results, responses, files, logs (verbose); Scratch / Intermediate State — Notes, reasoning, partial results, drafts, retries; Temporary Artifacts — Working files, temp exports, debug data.
Private to Subagent: Not visible to parent.
Produces Outputs: Final Report / Answer — Curated, high-quality result for the parent; Generated File Handle — Compact reference (file ID, schema, hash, storage pointer); Compact Memories — Summaries with provenance, TTL, and freshness; Audit Trail (Optional) — Tool call list, key decisions, policy summary (not raw data).
Isolation Boundary: Subagent state is not accessible to the parent at any time.
Promotion Gate
Policy-driven promotion of explicit outputs only. Everything else stays private.
Parent Resumes (after subagent completion)
- Receives Promoted Outputs Only: Final Report / Answer; Generated File Handle; Compact Memories; Audit Trail (if provided)
- Parent State (updated): Adds promoted memories; Stores file handle reference; Records audit summary; Continues conversation
- Next Steps: Parent decides what to do next (e.g., follow-up questions, new tasks, branch, or additional subagents).
What gets promoted?
Final Report / Answer: Curated output intended for the parent.
Generated File Handle: Stable reference to large or expensive artifacts.
Compact Memories: Bounded, policy-checked context for future turns.
Audit Trail (Optional): High-level trace for accountability (no raw data unless allowed).
What stays private?
Raw tool payloads
Scratch / intermediate state
Temporary artifacts
All internal tool activity
Only promoted outputs cross the boundary.
Isolation Guarantees
No raw data leakage: Parent never sees raw tool payloads or scratch state.
Least-privilege promotion: Only explicit, policy-approved outputs are shared.
Bounded lifetime: Subagent state is discarded after completion.
Clean parent context: Parent resumes with only promoted, relevant context.
Auditability preserved: Policy decisions and summaries are recorded for traceability.
4.15 Aufbewahrung und Speicherbereinigung
Dauerhafte Artefakte schaffen Verantwortung für die Speicherung. Die Architektur bedeutet nicht „alles für immer speichern“. Sie bedeutet, die Aufbewahrung ausdrücklich zu regeln.
Das Aufbewahrungsmodell muss Nachprüfbarkeit und Datenschutz ausbalancieren. Rohe Artefakte können nach Richtlinie behalten, archiviert, geschwärzt, gehasht, ausgelagert oder gelöscht werden. Stichprobenartig erfasste contextAssemblyLogs sollten konsequent bereinigt werden. Beim Löschen eines Kontos müssen Artefakte, Erinnerungen und Zusammenstellungsprotokolle entfernt werden. Nur für Audits bestimmte Artefakte sollten außerhalb des normalen Modellkontexts bleiben. Speicherbasierte Nutzlasten sollten erst nach Datenschutz- und Byte-Budget-Prüfungen rehydriert werden. Verweise auf erzeugte Dateien und Dokumente brauchen eine referenzerhaltende Bereinigung, damit aktive Zitate und Dateireferenzen nicht ungültig werden.
Das ist ein Grund, weshalb die Architektur vor allem bei anspruchsvoller Werkzeugarbeit gerechtfertigt ist.
Rohe Belege zu behalten verbessert Wiederherstellung und Audit, erhöht aber auch die Anforderungen an Klassifizierung, Verschlüsselung, Zugriffskontrolle, Löschung und diszipliniertes Anbieter-Routing.
5. Architekturanalyse
5.1 Token-Kostenmodell
Beim erneuten Einspielen des Transkripts entsprechen die Kosten für das Modell bei einer werkzeugreichen Unterhaltung ungefähr:
conversation_window + historical_tool_calls + historical_tool_results + summaries + retry_state
Bei graphbasierter Kontextzusammenstellung entsprechen die Kosten ungefähr:
conversation_window + selected_tool_memories + protected_recovery_state + selected_skill_state + optional_raw_rehydration
Entscheidend ist, was mit dem Umfang historischer Werkzeugnutzung skaliert. Beim erneuten Einspielen des Transkripts können alte Werkzeugnutzlasten im Wiedereinspielpfad verbleiben, bis sie gekürzt oder zusammengefasst werden. In dieser Architektur werden rohe Artefakte getrennt aufbewahrt. Nur kompakte Erinnerungen, geschützter ungelöster Zustand oder ausdrücklich rehydrierte Belege gelangen in den Modellkontext.
Das ist der wirtschaftliche Kern der Architektur.
5.2 Rohe Artefakte gegenüber kompakten Erinnerungen
Die Trennung von rohen Artefakten und Erinnerungen schafft zwei Ebenen. Die Belegebene enthält vollständige Argumente, rohe Ausgaben, Fehler, Hashes, Speicherreferenzen, Herkunft und Laufzeitmetadaten. Die Kontextebene enthält kompakte Zusammenfassungen, strukturierte Fakten, Referenzen auf erzeugte Dateien, Markierungen als veraltet, Konfidenzmetadaten und Hinweise zur erneuten Prüfung.
So kann das System den Kontext verkleinern, ohne Nachprüfbarkeit zu verlieren. Eine Zusammenfassung kann günstig und nützlich sein, sollte aber nicht der einzige erhaltene Datensatz sein.
5.3 ContextAssembly als Cache- und Auditgrenze
Die Kontextzusammenstellung schafft eine stabile Grenze zwischen gespeichertem Zustand und der Serialisierung der Anbieteranfrage. Die Runtime kann die Nachrichtenserialisierung ändern. Der Zusammenstellungsdatensatz hält dennoch fest, welche Graphverweise ausgewählt wurden und welche Richtlinienversion sie ausgewählt hat.
Die Architektur zielt auf Reproduzierbarkeit nach Richtlinienversion, nicht auf dauerhaft byteidentisches erneutes Einspielen. Dieselbe Richtlinienversion sollte über derselben Graphmomentaufnahme dieselbe Artefaktmenge, Erinnerungsmenge, denselben geschützten Rohzustand und dieselben Richtlinienentscheidungen auswählen. Das garantiert weder identische Tokenisierung noch identische Live-Modellausgaben nichtdeterministischer Anbieter.
5.4 Teilnehmerbezogener Kontext
Im Multi-Modell-Chat sind das Teilen des Transkripts und das Teilen von Laufzeitzustand unterschiedliche Dinge.
Wenn zwei Modelle denselben Nutzer-Prompt beantworten, kann der Nutzer beide Endausgaben direkt vergleichen. Das bedeutet nicht, dass private Arbeitsnotizen, Werkzeugfehler oder rohe aus OAuth-Zugriffen stammende Nutzlasten von Modell A für Modell B sichtbar sein sollten.
Die Architektur macht diese Unterscheidung durch Sichtbarkeitsumfang und Laufzeitisolationsrichtlinie ausdrücklich sichtbar.
Das ist ein erheblicher Vorteil für die Evaluation. Fehler lassen sich nach Ebenen aufschlüsseln: War der Datensatz zweigsichtbar, teilnehmerprivat, nur für Audits bestimmt, freigegeben, veraltet, durch Anbieter-/Datenschutzrichtlinie ausgelassen oder rehydriert, weil genaue Belege erforderlich waren?
5.5 Kontextzusammenstellung als Graphabfrage
Die Architektur versteht Kontextzusammenstellung als Graphabfrage über Laufzeitentitäten, begrenzt durch aktive Zweigabstammung, Teilnehmersichtbarkeit, Laufzeitisolation, Datenschutzklassifizierung, Übernahmerichtlinie, Aktualitätsrichtlinie, Konfidenzherkunft, Widerspruch und Ersetzung, Fortsetzungszustand, Wiederholungs-/Wiederherstellungsschutz, Kontextbudget und Grenzen der Rehydrierung roher Daten.
Deshalb ist „GraphRAG“ nicht die passende vorrangige Einordnung. GraphRAG bedeutet meist Abruf über Fachwissen oder Dokumentbeziehungen. Der Laufzeitgraph umfasst Ausführungszustand, Richtlinien, Teilnehmer, Zweige, Artefakte, Erinnerungen und Kontextzusammenstellungen.
Der Laufzeitgraph ist umfassender als ein Wissensgraph.
5.6 Determinismus und Reproduzierbarkeit
Die Architektur zielt auf Reproduzierbarkeit nach Richtlinienversion, nicht auf dauerhaft byteidentisches erneutes Einspielen von Prompts.
Dieser Unterschied ist wichtig. Ein Anbieter-SDK kann die Serialisierung ändern. Das OpenRouter-Routing kann das Modell hinter einer automatischen Route ändern. Die Tokenisierung kann sich zwischen Anbietern unterscheiden. Ein Live-Modellaufruf kann auch bei identischer Eingabe nichtdeterministisch sein.
Das Reproduzierbarkeitsziel ist enger und nützlicher. Dieselbe Richtlinienversion sollte über derselben Graphmomentaufnahme dieselbe Artefaktmenge, Erinnerungsmenge, denselben geschützten Rohzustand und dieselben Richtlinienentscheidungen auswählen. Entscheidungen zu Datenschutz, Anbieter-Routing, Zweiggeltung, Wiederholung und Fortsetzung sollten aus dem gespeicherten Zustand erklärbar sein. Eine frühere Kontextzusammenstellung sollte für Audit-/Debug-Abläufe inhaltlich rekonstruierbar sein. Harmlose Formatierungsänderungen sollten die semantische Nachprüfbarkeit nicht zerstören.
Deshalb sind policyVersion, assemblerVersion, ausgewählte Verweise, Auslassungszusammenfassungen und Zeitmessfelder wichtig. Sie definieren die Grenze zwischen Laufzeitzustand und der Serialisierung von Anbieternachrichten.
5.7 Warum es nicht einfach um größeren Kontext geht
Große Kontextfenster helfen, lösen aber das Architekturproblem nicht.
Ein größeres Fenster kann mehr veraltete Belege, privaten Arbeitszustand, störende Informationen aus Geschwisterzweigen, alte Werkzeugfehler und rohe OAuth-abgeleitete Nutzlasten aufnehmen. Es kann den Zeitpunkt verschieben, an dem Kürzung sichtbar wird. Es entscheidet aber nicht, was aufgenommen werden sollte.
Die Architektur ist kein Argument gegen Modelle mit großem Kontext. Sie ist ein Argument dafür, Kontextfenster bewusst zu füllen. Der Assembler kann weiterhin ein großes Fenster nutzen, wenn die Aufgabe es braucht. Der Unterschied ist, dass rohe Artefakte, kompakte Erinnerungen, Wiederherstellungszustand und Richtlinienvorgaben über ausdrückliche Regeln konkurrieren, statt aufgrund ihrer zeitlichen Position erhalten zu bleiben.
6. Vergleich mit bisherigen Ansätzen
Die Architektur steht in einer starken Tradition von Arbeiten zu Context Engineering, Graph-Runtimes, Gedächtnis, Herkunft und Audit.
- Context Engineering ist inzwischen ein etabliertes Konzept im Agentenentwurf. Anthropic, Haystack, Atlan und andere haben argumentiert, dass Modellkontext ausdrücklich aus Anweisungen, Verlauf, abgerufenen Daten, Werkzeugen, Erinnerungen und Aufgabenzustand zusammengestellt werden sollte, statt ihn als Prompt-Zeichenkette zu behandeln.
- LangGraph bietet starke Vorbilder für Graphzustand, Threads, Checkpoints, Momentaufnahmen, erneutes Einspielen und dauerhafte Ausführungsmuster.
- Agentengedächtnissysteme unterscheiden Kurzzeit-, Langzeit-, episodisches, semantisches, prozedurales und Arbeitsgedächtnis.
- MCP und Frameworks zur Werkzeugnutzung machen Werkzeuge ausdrücklich sichtbar und protokollierbar.
- Literatur zu Event Sourcing und Auditprotokollen stützt Append-only-Ausführungsdatensätze und rekonstruierbare Verläufe.
- Forschung zu herkunftsbewusstem Gedächtnis, darunter Systeme wie MemORAI und Portable Agent Memory, weist in Richtung quellverknüpfter Erinnerungen.
- Sicherheitsarbeiten zu Prompt-Injection, Erinnerungsvergiftung, sitzungsübergreifenden Datenlecks und herkunftsbewusster Werkzeugsicherheit stützen strengere Richtliniengrenzen.
NanthAIs Beitrag besteht darin, diese zusammenlaufenden Muster in einen Laufzeitvertrag zu integrieren: dauerhafte Werkzeugartefakte, kompakte Werkzeug-Erinnerungen, Herkunft, Teilnehmerzuordnung, zweigbewusste Graphzusammenstellung, Richtlinienentscheidungen und Trennung von Transkript und Kontext.
Diese Integration ist der Punkt. Sie macht aus nützlichen Techniken ein diszipliniertes Laufzeitmodell für werkzeugreiche Agenten.
6.1 Was bereits Standard zu sein scheint
Mehrere Ideen sind bereits Standard oder nahe daran: Kurzzeit- und Langzeitgedächtnis, die Verdichtung alten Kontexts, die Nutzung von Werkzeugausgaben in späteren Runden, Checkpoints für den Agentenzustand, die Behandlung abgerufener Inhalte sowie von Werkzeug- und Nutzerinhalten als potenziell nicht vertrauenswürdig, die ausdrückliche Verwaltung des Modellkontexts statt nur des Schreibens von Prompts und gespeicherte Protokolle für Fehlersuche und Beobachtbarkeit.
6.2 Was sich gerade entwickelt
Andere Ideen sind in der Literatur und in ausgereiften Frameworks sichtbar, aber noch nicht gefestigt: herkunftsbewusstes Agentengedächtnis, Erkennung veralteter Erinnerungen, Umgang mit Widerspruch und Ersetzung, portable Erinnerungsobjekte, Rehydrierung roher Artefakte aus kompakten Erinnerungen, eigene Zustandsspeicher für anbieterseitige Zero-Retention-Vorgaben, richtliniengesteuerte Kontextzusammenstellung und Gedächtnis als Angriffsfläche.
Die Architektur folgt dieser Richtung, gibt diesen Ideen aber einen konkreten Vertrag für die Produkt-Runtime.
6.3 Was unzureichend dokumentiert zu sein scheint
Die interessantesten Ideen sind enger gefasst: ContextAssembly als eigenständiger dauerhaft gespeicherter Datensatz, mit jeder Generierung verknüpfte PolicyDecision, dauerhaftes rohes ToolArtifact getrennt von kompakter ToolMemory, teilnehmerprivater Laufzeitzustand im Multi-Modell-Chat, bis zur Freigabe private Artefakte untergeordneter Subagenten, zweigbewusste Kontextzusammenstellung über der Unterhaltungsabstammung, Übernahmesemantik zwischen Beobachtung und Erinnerung und die Trennung der Informationsverarbeitung der Runtime vom Nutzertranskript.
Hier halte ich die Architektur für besonders nützlich. Nicht weil jedes einzelne Feld überraschend wäre, sondern weil die Kombination der Runtime Begriffe für Entscheidungen gibt, die sonst implizit bleiben.
6.4 Die nächstliegenden Vorbilder
Das nächste Framework-Vorbild ist LangGraph: Graphzustand, Threads, Checkpoints, erneutes Einspielen, Zeitreisen und dauerhafte Ausführungsmuster passen stark zur Richtung der Runtime. Der Unterschied liegt im Umfang. Die Architektur umfasst nicht nur Graphausführung. Sie macht Werkzeugartefakte, kompakte Erinnerungen, Teilnehmersichtbarkeit, Zweigabstammung, Kontextzusammenstellungen und Richtlinienentscheidungen zu eigenständigen Datensätzen.
Portable Agent Memory und MemORAI liegen bei der Erinnerungsherkunft nahe. Sie stützen die Idee, dass Erinnerungen Quellenverknüpfungen und Integritätsmetadaten tragen sollten. Die Architektur wendet diese Logik auf Werkzeugartefakte und Generierungskontext an, nicht nur auf portable Erinnerungsobjekte.
Arbeiten zum Event Sourcing liegen bei Audit und erneutem Einspielen nahe. Sie stützen Append-only-Ereignisverläufe und rekonstruierbare Ausführung. Die Architektur braucht diesen zeitlichen Verlauf, aber auch Graphbeziehungen zwischen Zweigen, Teilnehmern, Artefakten, Erinnerungen und Richtlinien.
ARGUS und verwandte Arbeiten zu herkunftsbewusster Sicherheit liegen auf der Sicherheitsseite nahe. Sie behandeln Werkzeugentscheidungen als durch früheren Kontext beeinflusst und nutzen Herkunft, um unsichere Aktionen zu beurteilen. Die Architektur verallgemeinert diesen Gedanken: Herkunft sollte nicht nur Sicherheitsprüfungen prägen, sondern auch die normale Kontextaufnahme, Rehydrierung, Widerspruchsbehandlung und Audits.
MCP ist relevant, weil Werkzeugaufrufe und Kontextquellen ausdrücklich sichtbar werden. MCP ist jedoch ein Integrationsprotokoll, keine Richtlinie für Aufbewahrung, Herkunft, Zweige, Teilnehmer oder Kontextzusammenstellung.
6.5 ZDR und eigener Zustand
Zero Data Retention und anbieterseitige Vorgaben zur Nichtaufbewahrung machen die Trennung von Transkript und Kontext wichtiger.
Wenn anbieterseitige dauerhafte Speicherung nicht verfügbar oder nicht erwünscht ist, benötigt der Anwendungsbetreiber dennoch interne Audit-Datensätze, Wiederherstellungszustand, Verweise auf erzeugte Dateien, Werkzeugaufrufherkunft, Entscheidungen zur Teilnehmersichtbarkeit, Lösch- und Aufbewahrungsrichtlinien und eine Möglichkeit, zu rekonstruieren, was das Modell sah.
Damit fällt die Zustandsverantwortung an die Produkt-Runtime zurück. Der Anbieter wird zum Ausführungsendpunkt. Die Anwendung entscheidet, was sie aufbewahrt, schwärzt, auslässt und bei jeder Anfrage sendet.
Die Architektur passt zu diesem Modell. Sie verlässt sich nicht auf anbieterverwaltete Threads als dauerhafte maßgebliche Datenquelle. Das Backend behält seinen eigenen Graphzustand und stellt daraus Anbieteranfragen zusammen.
7. Richtlinienkomplexität und ihr Umgang
Die zentrale technische Herausforderung ist, dass richtliniengesteuerte Zusammenstellung eine Entscheidungsebene einführt, die entworfen, getestet und beobachtet werden muss.
Das erneute Einspielen des Transkripts ist leicht nachzuvollziehen. Liegt eine Nachricht im Fenster, sieht das Modell sie. Wurde sie gekürzt, sieht es sie nicht.
Richtliniengesteuerte Kontextzusammenstellung ist leistungsfähiger, und diese Stärke braucht Leitplanken. Die Richtlinienebene muss Folgendes verhindern: ausgelassene nützliche Belege, aufgenommene veraltete Erinnerungen, offengelegten privaten Zustand, verborgene wiederholungsentscheidende Fehler, übermäßige Rehydrierung roher Daten, unzureichende Wiederherstellung genauer Belege, Fehler bei der Zweigabstammung, zu großes Vertrauen in modellabgeleitete Zusammenfassungen, zu hohe Latenz bei Graphabfragen und zu oberflächliche Nachprüfbarkeit.
Das ist die zentrale Abwägung. Die Architektur tauscht zufällige Transkriptvererbung gegen ausdrückliche Richtlinien. Das ist nur dann besser, wenn diese Richtlinien testbar, beobachtbar und begrenzt sind.
Die Architektur ist am stärksten, wenn Werkzeugabläufe lange laufen oder viele Artefakte erzeugen, rohe Werkzeugbelege wichtig sind, Datenschutz- oder Anbietervorgaben zählen, Zweige, Subagenten oder Multi-Modell-Ausführungen häufig sind, veraltete Fakten echte Fehler verursachen können, Nachprüfbarkeit wertvoll ist und Kontextkosten relevant sind.
Sie ist weniger relevant, wenn Chats kurz sind, Werkzeuge selten vorkommen, Ausgaben kein Audit benötigen, jeder Zustand gefahrlos geteilt werden kann, genaue Belege später nie gebraucht werden oder die Entwicklungsressourcen keine Richtlinientests und Telemetrie tragen können.
Für einen einfachen Chatbot kann das erneute Einspielen des Transkripts genügen. Bei einer werkzeugreichen Agenten-Arbeitsumgebung besteht die Komplexität bereits. Die Architektur macht sie ausdrücklich sichtbar und testbar.
8. Risiken und Fehlermodi
R1: Richtlinienfehler
Der Assembler kann benötigte Belege auslassen oder unzulässigen Kontext aufnehmen.
Gegenmaßnahmen: deterministische Szenariotests, Auslassungszusammenfassungen, Richtlinienversionierung, Vorher-nachher-Bewertung und stichprobenartige Zusammenstellungsprotokolle.
R2: Speicherwachstum
Rohe Artefakte können schnell wachsen, besonders bei Dateien, API-Nutzlasten, stdout/stderr und erzeugten Ausgaben.
Gegenmaßnahmen: Aufbewahrungsklassen, Zulässigkeit der Speicherbereinigung, Bereinigung bei Kontolöschung, Speicherreferenzen, Hashing und Aufbewahrungsrichtlinien für reine Auditdaten.
R3: Datenschutzverletzungen und Datenabfluss an Anbieter
Gespeicherte Artefakte können OAuth-abgeleitete Daten, Google-Daten, Dokumentdaten, Laufzeitdateien oder Nutzlasten mit Bezug zu Geheimnissen enthalten.
Gegenmaßnahmen: Datenschutzklassifizierung, Anbieter-Routing-Richtlinie, Freigabeprüfungen vor der Rehydrierung roher Daten, reine Metadatenzusammenfassungen und Auslassen im Zweifelsfall.
R4: Falsche Sicherheit durch kompakte Erinnerungen
Zusammenfassungen können falsch, veraltet oder unvollständig sein.
Gegenmaßnahmen: Konfidenzquelle, Herkunftslokatoren, Aktualitätsklasse, Widerspruchsverknüpfungen, Hinweise auf Grenzen und Wege zur Rehydrierung roher Daten.
R5: Veraltete Erinnerungen
Das Modell kann alte externe Beobachtungen als aktuelle Wahrheit verwenden.
Gegenmaßnahmen: observedAt, staleAfter, Aktualitätsklasse, Werkzeuge zur erneuten Prüfung, Markierungen als veraltet und Auslassungsrichtlinie.
R6: Zweigverunreinigung
Artefakte von Geschwisterzweigen können den Zustand des aktiven Zweigs verdrängen.
Gegenmaßnahmen: Abfrage der aktiven Zweigabstammung, ausdrückliche Unterhaltungs-/gemeinsame Sichtbarkeit und Telemetrie zu Zweigausschlüssen.
R7: Datenlecks zwischen Teilnehmern
Ein Modellteilnehmer kann den privaten Werkzeugzustand eines anderen sehen.
Gegenmaßnahmen: IDs zuständiger Teilnehmer und Modellausführungen, Sichtbarkeitsumfang, Laufzeitisolationsrichtlinie, Freigabelisten und Freigabeentscheidungen.
R8: Schleichend steigende Latenz
Graphabfragen, Herkunftsreparatur und Rehydrierung aus dem Speicher können teuer werden.
Gegenmaßnahmen: begrenzte Kandidatenmengen, zweistufige Rehydrierung nach Richtlinienauswahl, Zeitmessungs-Telemetrie, Grenzen für Reparaturversuche und Latenzprüfungen.
R9: Überzogene Zusagen zur Dauerhaftigkeit
Artefakte und Checkpoints helfen bei Wiederherstellung und Audit, sind aber nicht dasselbe wie vollständig verteilte dauerhafte Ausführung.
Gegenmaßnahmen: präzise Sprache, Idempotenz wo nötig, Fortsetzungs-Checkpoints, Wiederholungsverträge und externe Orchestrierung für stärkere Arbeitsablaufgarantien.
R10: Fehlersuche bei Auslassungen
Das Modell kann scheitern, weil relevanter Zustand ausgelassen wurde, nicht weil schlechter Zustand aufgenommen wurde.
Gegenmaßnahmen: Zählung von Ausschlussgründen, deterministische Detailspuren, Telemetrie zu Zweigausschlüssen, stichprobenartige Zusammenstellungsprotokolle und Audit-/Debug-Abfragen, die Kandidaten ebenso wie ausgewählte Datensätze untersuchen können.
R11: Abweichende Übernahme
Die Extraktionslogik kann zu viel in dauerhafte Erinnerungen oder zu wenig in für das Modell sichtbare Erinnerungen übernehmen.
Gegenmaßnahmen: ausdrückliche promotionPolicy, Extraktortests, Konfidenzherkunft, Regeln zur Herabstufung aus Datenschutzgründen und Wiederherstellung roher Artefakte, wenn eine Erinnerung nicht übernommen wurde.
R12: Missbrauch der Rehydrierung
Die Rehydrierung roher Daten kann zu einem verborgenen Weg werden, über den große oder sensible Nutzlasten in den Anbieterkontext gelangen.
Gegenmaßnahmen: zweistufige Auswahl, Datenschutzprüfungen vor Speicherlesezugriffen, Byte-Budgets, Anbieter-Routing-Prüfungen und Auslassen im Zweifelsfall bei OAuth-/Google-/geheimnisbezogenen Daten.
9. Implementierungsmessungen
Die vollständige Verhaltensvalidierung erfordert breitere Benchmarks. Einige Aussagen lassen sich aber direkt anhand der aktuellen NanthAI:Edge-Implementierung prüfen. Insbesondere erlaubt die Codebasis den Vergleich zwischen dem bisherigen Kontext durch erneutes Einspielen des Transkripts und zusammengestelltem Graphkontext für festgelegte werkzeugreiche Szenarien.
Diese Messungen quantifizieren die Seite des Arguments, die den sparsamen Umgang mit Kontext betrifft: Wie viel Prompt-Material für das Modell wird vermieden, wenn alte Werkzeugnutzlasten durch kompakte Erinnerungen, ausgewählten Graphkontext, Datenschutz-/Zuordnungsfilter und geschützten ungelösten Rohzustand ersetzt werden?
Der Vergleich war einfach aufgebaut. Der bisherige Durchlauf spielte Transkript und Werkzeugnachrichten mit störenden rohen Werkzeugnutzlasten erneut ein. Der zusammengestellte Durchlauf verwendete kompakte Werkzeug-Erinnerungen, ausgewählten Graphkontext, Datenschutz- und Zuordnungsfilter sowie geschützten ungelösten rohen Werkzeugzustand.
Das sind Implementierungsmessungen, kein öffentlicher Benchmark und keine Behauptung einer allgemeinen Verbesserung des Aufgabenerfolgs.
9.1 Reduktion des Prompt-Kontexts
Die Prompt-Token-Differenzen waren in den getesteten Live-Vergleichsszenarien deutlich negativ.
- Der Kontext der aufgeschobenen Dokumentauswahl sank von 1.020 auf 142 Token, eine Reduktion um 86,1 %.
- Die Dateierzeugung mit mehreren Werkzeugen sank von 1.905 auf 221 Token, eine Reduktion um 88,4 %.
- Veraltete Erinnerungen aus verbundenen Apps sanken von 1.051 auf 145 Token, eine Reduktion um 86,2 %.
- Laufzeitzustand mit mehreren Skills sank von 1.008 auf 179 Token, eine Reduktion um 82,2 %.
- Teilnehmersichtbarkeit sank von 961 auf 161 Token, eine Reduktion um 83,2 %.
- Widerspruch und Ersetzung sanken von 1.986 auf 197 Token, eine Reduktion um 90,1 %.
Das stützt die erste Aussage der Architektur zum sparsamen Umgang mit Kontext: Erfolgreiche frühere Werkzeugrunden müssen nicht als roher Transkriptballast im Wiedereinspielpfad bleiben. Sie können zu kompakten, herkunftsverknüpften Erinnerungen werden, während rohe Belege außerhalb des Prompts wiederherstellbar bleiben.
9.2 Erhalt von Wiederherstellung und Herkunft
Token-Reduktion ist nur nützlich, wenn wichtiger Zustand nicht verloren geht. Die getesteten Szenarien umfassten deshalb Fälle zu Wiederherstellung, Herkunft, Datenschutz sowie Zweig- und Teilnehmergrenzen: Zustand aufgeschobener Dokumentauswahl, erzeugte Dateien, veraltete Erinnerungen aus verbundenen Apps, Laufzeitzustand mit mehreren Skills, Teilnehmersichtbarkeit, Widerspruch und Ersetzung, Reparatur beschädigter Herkunftsverweise, exakte Rehydrierung roher CSV-Daten, Zweigisolation, wiederholungsentscheidende Fehler, datenschutzbedingte Auslassung von Google-Daten, Subagenten-Fortsetzungszustand, Zuordnung in autonomen Diskussionen, Erfassung untergeordneter Subagentenartefakte, Metadaten zur Fortsetzung übergeordneter Agenten, Kompatibilität geplanter Aufgaben und Kompatibilität des Sendens in Zweige.
Der zusammengestellte Weg verbesserte das Verhalten dort, wo das erneute Einspielen des Transkripts strukturell schwach war. Er hielt teilnehmerprivate Arbeitsnotizen zurück, reparierte Herkunftsverweise statt Ersatz-IDs zu erfinden, wählte den Zustand des aktiven Zweigs, bewahrte wiederholungsentscheidende Fehler, ließ rohe Google-Inhalte aus, wenn die Richtlinie es verlangte, und stellte exakte rohe Artefakte wieder her, wenn die Richtlinie es erlaubte.
9.3 Abdeckung der Laufzeitmodi
Dieselbe Architektur muss über Generierungsmodi hinweg funktionieren, nicht nur in der einfachen Chatschleife. Eine normale Chatrunde, eine Multi-Modell-Runde, eine autonome Diskussion, eine untergeordnete Subagentenausführung, die Fortsetzung des übergeordneten Agenten, eine geplante Aufgabe und das Senden in einen Zweig haben jeweils andere Kontextgrenzen.
Die wichtige Erkenntnis aus der Implementierung ist, dass Graphzusammenstellung an diesen Grenzen getestet werden muss. Zustand untergeordneter Subagenten sollte bis zur Freigabe privat bleiben. Die Fortsetzung des übergeordneten Agenten sollte einen deterministischen Checkpoint verwenden. Autonome Diskussionen sollten Sprecherkennzeichnungen und Moderationsanweisungen erhalten. Beim Senden in Zweige sollte die aktive Abstammung geerbt werden, ohne Artefakte von Geschwisterzweigen einzubeziehen.
Hier ist das Graphmodell besonders wichtig. Der Graph reduziert nicht nur Token. Er gibt der Runtime Begriffe, um zu entscheiden, welcher Zustand zu welchem Generierungsmodus gehört.
9.4 Was die interne Validierung zeigte
Die interne Validierung hatte zwei Ebenen.
- Die deterministische Ebene prüfte, ob die Zusammenstellungsrichtlinie unverzichtbaren Laufzeitzustand bewahrte. Rohe Werkzeugartefakte wurden vor der Kürzung auf Nachrichtenebene dauerhaft gespeichert. Ungelöster, aufgeschobener, fehlgeschlagener und wiederholungsentscheidender Werkzeugzustand blieb für das Modell sichtbar. Teilnehmerprivater Zustand wurde anderen Teilnehmern vorenthalten. Veraltete Erinnerungen wurden markiert oder ausgelassen, statt stillschweigend als aktuelle Wahrheit behandelt zu werden. Ersetzte Erinnerungen wurden ausgelassen, während ihre aktuellen Ersatz-Erinnerungen auswählbar blieben. Beschädigte Herkunftsverweise wurden repariert oder als veraltet markiert, ohne Ersatz-IDs zu erfinden. Zweiglokale Artefakte und Erinnerungen wurden aus der aktiven Abstammung statt aus neuen Geschwisterzweigen ausgewählt. Datenschutzbeschränkte rohe Nutzlasten wurden ausgelassen, während unbedenkliche Zusammenfassungen und Hinweise zur erneuten Prüfung verfügbar blieben.
- Die Live-Vergleichsebene stellte dieselben Szenarien anschließend in zwei Formen dar: bisheriges erneutes Einspielen des Transkripts und zusammengestellter Graphkontext. Der zusammengestellte Weg bewahrte die erforderlichen Wiederherstellungs- und Herkunftsfakten und reduzierte gleichzeitig den bereitgestellten Prompt-Umfang stark.
In den oben gemessenen Live-Szenarien lagen die Reduktionen zwischen 82,2 % und 90,1 %.
9.5 Einordnung
Diese Messungen bestätigen die Annahme der Kontextreduktion in den getesteten Implementierungsszenarien. Sie zeigen, dass der zusammengestellte Weg von NanthAI:Edge Folgendes erheblich reduzieren kann: standardmäßiges erneutes Einspielen historischer Werkzeugnutzlasten, Offenlegung privaten Arbeitszustands von Teilnehmern, Behandlung veralteten Zustands verbundener Apps als aktuelle Wahrheit, Zweigverunreinigung durch Geschwisterpfade, Verlust wiederholungsentscheidenden Werkzeugzustands und erfundene Herkunft bei beschädigten Lokatoren.
Die Messungen beantworten eine Frage:
Reduziert richtliniengesteuerte Kontextzusammenstellung den für das Modell bereitgestellten Kontextumfang und bewahrt dabei in den getesteten Szenarien wichtigen Wiederherstellungs- und Herkunftszustand?
Die Antwort lautet ja.
10. Diskussion
Das Muster, das ich aus der Architektur mitnehmen würde, lautet: das Transkript als Verlauf für Menschen behalten, rohe Werkzeugartefakte vor der Kürzung speichern, kompakte Erinnerungen aus Artefakten statt aus losen Zusammenfassungen ableiten, Herkunft bis zu rohen Belegen bewahren, Aktualität und Ersetzung verfolgen, Laufzeitzustand nach Teilnehmer und Zweig abgrenzen, Modellkontext anhand von Richtlinien statt Nachrichtenalter zusammenstellen, genug von der Auswahlentscheidung protokollieren, um den Vorgang zu erklären, rohe Artefakte nur dann rehydrieren, wenn genaue Belege benötigt und erlaubt sind und die Informationsverarbeitung der Runtime aus dem Nutzererlebnis heraushalten, sofern der Nutzer keine Auditansicht verlangt.
Das ist die eigentliche Architektur.
Für Umsetzungsteams sind die praktischen Regeln ebenso direkt. Vor der Auswahl von Graphkandidaten eine unveränderliche Zusammenstellungsrichtlinie bestimmen. Die aktive Zweigabstammung abrufen, bevor mit geteilten oder unterhaltungsweiten Kandidaten aufgefüllt wird. Speicherbasierte rohe Nutzlasten erst rehydrieren, nachdem Datenschutz- und Budgetrichtlinien sie ausgewählt haben. Zustand untergeordneter Subagenten bis zur ausdrücklichen Freigabe als privat oder nur für Audits bestimmt behandeln. Protokollieren, warum Datensätze ausgelassen wurden, nicht nur, was aufgenommen wurde.
Nicht „Langzeitgedächtnis“. Nicht „GraphRAG“. Nicht „größere Kontextfenster“.
Eine richtliniengesteuerte Runtime, die entscheidet, was in den nächsten Modellaufruf gehört.
Daraus ergeben sich mehrere Folgen:
- Kontextzusammenstellung wird zu einem Laufzeitgrundbaustein. Sie sollte wie jeder andere kritische Backend-Vertrag getestet und versioniert werden.
- Erinnerung wird nachvollziehbar. Eine Erinnerung ohne Herkunfts-, Aktualitäts- und Konfidenzmetadaten reicht für anspruchsvolle Werkzeugabläufe nicht aus.
- Werkzeugausgaben sind kein Transkriptballast mehr. Rohe Artefakte können für Wiederherstellung und Audit aufbewahrt werden, ohne endlos erneut eingespielt zu werden.
- Teilnehmergrenzen werden ausdrücklich sichtbar. Multi-Modell- und Subagentensysteme müssen sichtbare Ausgaben von privatem Laufzeitzustand unterscheiden.
- Verzweigung wird strukturell. Ein Zweig ist nicht nur Navigation in der Oberfläche. Er begrenzt, welche Artefakte und Erinnerungen den nächsten Modellaufruf beeinflussen sollten.
- Audit verlagert sich von Protokollen zu Erklärungen. Das Ziel ist nicht nur, Ereignisse zu speichern, sondern zu rekonstruieren, warum ein Modell einen bestimmten Kontext sah.
Diese Richtung verfolgen wir in NanthAI:Edge: Agentenverlauf sollte dauerhaft sein, ohne blind erneut eingespielt zu werden. Modellkontext sollte aus richtliniengesteuertem Graphzustand zusammengestellt werden, statt sich aus der Nachrichtenreihenfolge zu ergeben.
11. Fazit
Die Branche bewegt sich von Chatbots zu Agenten mit Werkzeugnutzung. Das verändert das Zustandsproblem. Ein Chatbot kommt oft mit erneutem Einspielen des Transkripts aus.
Ein Agent, der Dateien schreibt, Dokumente liest, APIs aufruft, das Web durchsucht, Subagenten startet, geplante Aufgaben ausführt, Unterhaltungen verzweigt und Modelle vergleicht, kann das Transkript nicht als gesamte Runtime behandeln.
Das Transkript ist eine Projektion. Es ist notwendig, aber unvollständig. Das Modell braucht Kontext. Der Nutzer braucht Verlauf.
Das System braucht Belege. Der Auditor braucht Herkunft. Die Wiederholungsschleife braucht Wiederherstellungszustand. Die Datenschutzebene braucht Richtlinien.
Das Produkt braucht all das nebeneinander, ohne jede Modellanfrage zu einer Halde alter Werkzeugnutzlasten zu machen.
Genau das leistet die Architektur: Sie gibt dem Agentenverlauf eine dauerhafte Laufzeitstruktur, ohne jede künftige Modellanfrage zu einem erneuten Einspielen alter Werkzeugnutzlasten zu machen.
Agentenfähigkeiten sollten nicht linear mit der Prompt-Größe skalieren.
Agentenverlauf sollte nicht linear mit dem erneuten Einspielen des Transkripts skalieren.
Die nächste Ebene ist richtliniengesteuerte Kontextzusammenstellung.
Literatur
- Anthropic. Effective context engineering for AI agents. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Haystack. Context engineering. https://haystack.deepset.ai/blog/context-engineering
- Atlan. How to structure context for LLM applications. https://atlan.com/know/how-to-structure-context-for-llm-applications/
- LangGraph. Persistence. https://docs.langchain.com/oss/python/langgraph/persistence
- LangGraph. Durable execution. https://docs.langchain.com/oss/python/langgraph/durable-execution
- LangGraph. Add memory. https://docs.langchain.com/oss/python/langgraph/add-memory
- Databricks. Memory scaling for AI agents. https://www.databricks.com/blog/memory-scaling-ai-agents
- Google Cloud. What is Model Context Protocol? https://cloud.google.com/discover/what-is-model-context-protocol
- Portable Agent Memory. https://arxiv.org/html/2605.11032v1
- MemORAI. https://arxiv.org/html/2605.01386v1
- ESAA: Event Sourcing for Autonomous Agents in LLM-Based Systems. https://arxiv.org/abs/2602.23193
- Audit Trails for Accountability in Large Language Models. https://arxiv.org/html/2601.20727v1
- STALE. https://arxiv.org/html/2605.06527v1
- Evaluating the Long-Term Memory of Large Language Models. https://aclanthology.org/2025.findings-acl.1014/
- OWASP Agent Memory Guard. https://owasp.org/www-project-agent-memory-guard/
- OWASP. LLM Prompt Injection Prevention Cheat Sheet. https://cheatsheetseries.owasp.org/cheatsheets/LLM_Prompt_Injection_Prevention_Cheat_Sheet.html
- ARGUS. https://arxiv.org/html/2605.11053v1
- Beyond RAG for Agent Memory. https://arxiv.org/html/2602.02007v2
- LongMemEval-V2. https://arxiv.org/html/2605.12493v1
- Agentic Memory. https://arxiv.org/html/2601.01885v2
- Governing Evolving Memory in LLM Agents. https://arxiv.org/html/2603.11768v1
- Giskard. Cross-session leak: when your AI assistant becomes a data breach. https://www.giskard.ai/knowledge/cross-session-leak-when-your-ai-assistant-becomes-a-data-breach
- Unit42. Indirect prompt injection poisons AI long-term memory. https://unit42.paloaltonetworks.com/indirect-prompt-injection-poisons-ai-longterm-memory/
- Diagrid. Checkpoints are not durable execution. https://www.diagrid.io/blog/checkpoints-are-not-durable-execution-why-langgraph-crewai-google-adk-and-others-fall-short-for-production-agent-workflows
- Zero Data Retention in LLM-based Enterprise AI Assistants. https://arxiv.org/abs/2510.11558
Auch veröffentlicht auf LinkedIn.