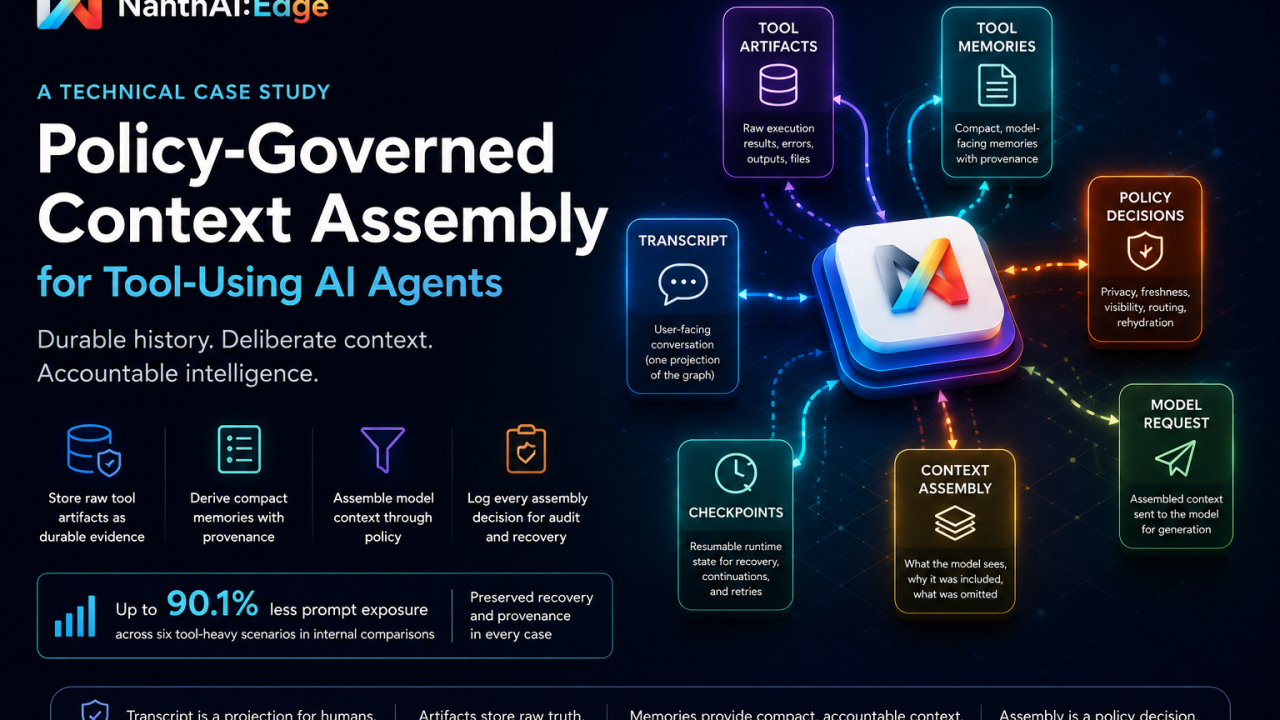
Un caso di studio tecnico su NanthAI:Edge.
La maggior parte degli agenti AI che usano strumenti fa crescere la cronologia nel modo sbagliato: ogni chiamata a uno strumento, risultato, file generato, nuovo tentativo, riepilogo, errore e continuazione viene reinserito nella trascrizione visibile della chat finché non viene tagliato, compattato o perso.
In NanthAI:Edge, non è solo una teoria. Nei test comparativi interni, il contesto assemblato dal grafo ha ridotto il contenuto esposto nel prompt da 1905 a 221 token per un flusso di generazione di file con più strumenti, da 1986 a 197 token per un flusso di contraddizione/sostituzione e da 1020 a 142 token per un flusso con selettore di documenti differito. Questo non dimostra una maggiore riuscita dei compiti, ma dimostra che la superficie del contesto rivolta al modello può essere resa sensibilmente più piccola conservando lo stato di recupero e provenienza.
Il modo più facile di costruire un agente AI resta aggiungere continuamente cose alla chat.
L’utente fa una domanda. Il modello richiama uno strumento. Lo strumento restituisce un risultato. Il risultato viene inserito nella conversazione. Il modello richiama un altro strumento. Viene aggiunto un altro risultato. L’agente scrive un file, incontra un errore, riprova, riassume, crea un ramo, riprende più tardi, magari avvia un sottoagente, e la trascrizione continua a crescere.
All’inizio sembra naturale. La trascrizione è lì. È ordinata. È leggibile. Sembra memoria. Ma per gli agenti che usano strumenti, la trascrizione è una trappola.
La trascrizione è ciò che l’utente dovrebbe poter leggere. Non è la stessa cosa di ciò che il modello dovrebbe vedere al passaggio successivo. Quando un agente esegue strumenti, gestisce file, richiama API, lavora su più rami, confronta modelli o porta con sé stato privato del runtime, il registro visibile della chat diventa una fonte di verità inadeguata. Mescola esperienza utente del prodotto, prove, memoria, stato dei nuovi tentativi, confini di privacy, osservazioni obsolete e record di audit in un unico flusso cronologico.
Lo schema migliore è trattare la trascrizione come una proiezione di un grafo del runtime più ricco. I risultati grezzi degli strumenti vengono conservati come artefatti persistenti. Da quegli artefatti si ricavano memorie compatte. La provenienza collega la memoria alle prove. Rami, partecipanti, esecuzioni dei modelli, chiamate agli strumenti, punti di ripristino e decisioni di policy sono entità separate. Ogni richiesta al modello riceve un contesto assemblato da quel grafo secondo policy esplicite, anziché una riproposizione cieca dei vecchi messaggi della chat.
È questa l’architettura sostenuta dall’articolo: non “più memoria”, non “basta usare una finestra di contesto più grande” e non “GraphRAG per tutto”. Il punto è più preciso: la cronologia di un agente dovrebbe essere persistente senza essere riproposta per sempre, e il contesto del modello dovrebbe essere assemblato deliberatamente anziché ereditato dall’ordine dei messaggi.
Sintesi
Gli agenti basati su modelli linguistici di grandi dimensioni (LLM) che usano strumenti affrontano una tensione strutturale tra cronologia della conversazione, stato del runtime, prove degli strumenti, memoria, privacy ed economia del contesto. Uno schema di implementazione comune tratta la trascrizione visibile sia come cronologia rivolta all’utente sia come contesto rivolto al modello: messaggi precedenti, chiamate agli strumenti, risultati, riepiloghi, errori e artefatti generati vengono riproposti nelle richieste successive finché non vengono tagliati, compattati o persi. Questo approccio è semplice, ma accoppia l’esperienza utente alla cognizione del runtime e rende la selezione del contesto un effetto accidentale dell’ordine dei messaggi.
Questo articolo sviluppa lo schema progettuale dell’assemblaggio del contesto governato da policy, in cui la trascrizione viene trattata come una proiezione di un grafo del runtime più ricco anziché come fonte di verità del modello. Il runtime archivia gli artefatti grezzi degli strumenti separatamente dalle memorie compatte, conserva la provenienza dalla memoria derivata alle prove, tiene traccia della titolarità di partecipanti e rami e registra le decisioni di assemblaggio del contesto sotto versioni esplicite delle policy.
L’articolo colloca questo schema rispetto al lavoro precedente su ingegneria del contesto, memoria degli agenti, stato a grafo, event sourcing, memoria consapevole della provenienza, errori dovuti a memoria obsoleta, prompt injection e tracce di audit degli agenti. Usa poi NanthAI:Edge come esempio di implementazione dello schema.
L’articolo sostiene che il contributo più forte sia il contratto integrato del runtime: artefatti persistenti degli strumenti, memorie compatte degli strumenti, assemblaggi del contesto come entità esplicite, decisioni di policy, titolarità del runtime delimitata per partecipante, selezione dal grafo consapevole dei rami, policy di freschezza e sostituzione, reinserimento degli artefatti grezzi e un confine deliberato tra cognizione del runtime e trascrizione visibile all’utente.
Il contributo comprende un quadro concettuale per separare trascrizione e contesto negli agenti che usano strumenti, un’analisi orientata all’implementazione dell’architettura di artefatti persistenti e assemblaggio del contesto di NanthAI:Edge, un confronto con il lavoro precedente su ingegneria del contesto e runtime a grafo, un catalogo dei rischi del livello delle policy e misurazioni dell’implementazione da scenari comparativi interni.
1. Introduzione
Nel precedente articolo di NanthAI ho scritto dell’uso delle skill come porte di accesso agli strumenti. Il problema era l’appesantimento dovuto alle capacità. Man mano che un agente acquisisce flussi di lavoro, integrazioni e istruzioni di dominio, l’approccio ingenuo continua ad aggiungere testo al prompt e schemi di strumenti a ogni richiesta. NanthAI:Edge lo evita esponendo prima un catalogo compatto di skill, poi caricando le istruzioni complete ed espandendo il registro degli strumenti eseguibili solo quando un compito lo giustifica. Questo risolve metà del problema del contesto. L’altra metà emerge dopo l’esecuzione degli strumenti.
Le chiamate agli strumenti producono risultati di ricerca, file, citazioni, contenuti API, dati derivati da OAuth, errori, risultati parziali, stato dei nuovi tentativi, artefatti generati, stato di lavoro provvisorio privato, osservazioni esterne obsolete, stato dei sottoagenti e punti di ripristino per la continuazione. Se il runtime continua a riproporre tutto questo attraverso la trascrizione visibile della chat, il contesto del modello diventa costoso, rumoroso e talvolta sbagliato.
Questo crea due problemi collegati.
- L’appesantimento della trascrizione si verifica quando vecchie chiamate agli strumenti, risultati, artefatti generati, riepiloghi, nuovi tentativi e stato operativo si accumulano nella cronologia della conversazione e vengono ripassati ripetutamente al modello.
- L’ambiguità dello stato del runtime si verifica quando alla trascrizione viene chiesto di fungere contemporaneamente da cronologia dell’utente, memoria del modello, traccia di audit, stato dei nuovi tentativi, confine di privacy e archivio delle prove degli strumenti.
Entrambi sono costosi. Consumano token in ingresso, aumentano latenza e costi, complicano l’instradamento verso i provider e rendono più difficile capire che cosa sapesse davvero il modello quando ha generato una risposta.
Soprattutto, possono compromettere la correttezza. Un modello può vedere un risultato obsoleto di uno strumento come verità attuale. Un errore cruciale per un nuovo tentativo può scomparire in un riepilogo. Un ramo può ereditare il file generato da un ramo fratello. Gli appunti privati di un partecipante possono finire nel contesto di un altro modello. Un riepilogo compatto può perdere il valore esatto necessario in seguito per un audit o per reinserire il dato originale.
Questo articolo esamina un’alternativa strutturata: l’assemblaggio del contesto governato da policy su un grafo del runtime.
Lo schema è semplice: trattare la trascrizione come cronologia per le persone, archiviare gli artefatti grezzi degli strumenti separatamente dai messaggi, ricavare memorie compatte dagli artefatti, conservare la provenienza dalla memoria alle prove grezze, assemblare ogni richiesta al modello dallo stato del grafo secondo policy esplicite e registrare una parte sufficiente della decisione di assemblaggio per spiegare che cosa ha visto il modello e perché.
In NanthAI:Edge, l’interfaccia pubblica della chat non ha dovuto cambiare per far funzionare l’architettura. Gli utenti vedono ancora messaggi, schede degli strumenti, file generati, citazioni, rami, nuovi tentativi, continuazioni e risposte dei modelli. Dietro le quinte, il runtime separa trascrizione, artefatti, memorie, decisioni di policy e assemblaggi del contesto.
Lo stesso confine si applica alle diverse modalità del runtime. Un normale turno di chat, un confronto multimodello, una discussione autonoma, l’esecuzione di un sottoagente figlio, la ripresa del padre dopo i sottoagenti, un’attività pianificata e un invio in un ramo non hanno tutti lo stesso contratto di contesto. Una discussione autonoma in forma di dibattito dovrebbe conservare le etichette degli interlocutori e le direttive del moderatore. Un sottoagente figlio non dovrebbe trasmettere al padre lo stato grezzo dello spazio di lavoro per impostazione predefinita. La ripresa del padre dovrebbe rispettare il proprio punto di ripristino deterministico anziché interrogare ciecamente la trascrizione. L’assemblaggio del contesto deve tener conto della modalità del runtime.
L’articolo offre un vocabolario per separare trascrizione, contesto, artefatto, memoria e policy; un’architettura concreta per artefatti persistenti e memorie compatte degli strumenti; un’analisi dello stato del runtime delimitato per partecipante nei flussi multimodello e con sottoagenti; un confronto con il lavoro precedente; e un’interpretazione delle misurazioni dell’implementazione e dei loro limiti.
TRANSCRIPT PROJECTION (User-Facing UI)
Ordered messages · Tool cards (truncated) · Generated files · Citations · Branches · Model responses
One projection of the same runtime graph
RUNTIME GRAPH (Durable State)
- MESSAGE (User/Assistant): User prompts; Assistant prose; Tool call / result messages (truncated for UI); Visible transcript
- MODEL RUN (Generation Attempt): Provider; Model & parameters; Participant; Message / Job ownership; Runtime mode
- TOOL CALL (Requested): Tool name; Arguments; Call ID; Status (requested / pending / failed); Model run linkage
- TOOL ARTIFACT (Raw Execution): Full arguments; Raw result or error; Status, timing; Tool version; Privacy classification; Storage handles; Hashes / byte size
- TOOL MEMORY (Compact, Model-Facing): Summary / structured data; Source artifact ID(s); Confidence + source; Freshness & stale-after; Provenance locators; Contradictions / supersession; Revalidation tools
- CONTEXT ASSEMBLY (Policy-Governed): Policy version; Assembler version; Selected memories; Rehydrated artifacts; Legacy vs assembled tokens; Omission summaries; Timing & telemetry
- MODEL REQUEST (Provider Prompt): System / instructions; Selected messages; Selected memories; Rehydrated raw (if any); Skill state; Recovery state; Provider + settings
KEY RELATIONSHIPS
Primary execution flow →
Artifacts produced by calls
Memories derived from artifacts
Policy selection & assembly
UI projection (readable view)
WHAT HAPPENS WHERE
ToolCall → ToolArtifact: Execute the tool and capture raw evidence.
ToolArtifact → ToolMemory: Extract, summarize, classify, link provenance.
ToolMemory → ContextAssembly: Policy decides what to include.
ContextAssembly → Model Request: Serialize the selected context.
Transcript Projection: Human-readable view, not the source of truth.
POLICY CONSIDERS
Ownership (participant / model run / branch)
Visibility (private / branch / conversation / audit)
Privacy & provider-routing constraints
Freshness, staleness, revalidation needs
Promotion, contradiction, supersession
Recovery state & retry protection
Context budget & raw rehydration bounds
Retention, deletion, and safety rules
OUTCOME
The model sees a deliberate, policy-governed context assembled from durable runtime state — not a blind replay of the transcript.
Smaller context. Better signal. Preserved evidence. Clear auditability.
Core Principle: Transcript is a projection for humans. Artifacts are raw truth. Memories provide compact, accountable context. Assembly is a policy decision.
2. Contesto: ingegneria del contesto, memoria e stato degli strumenti
2.1 Ingegneria del contesto
L’ingegneria del contesto è la pratica di decidere quali informazioni entrano nel contesto del modello. È più ampia della scrittura dei prompt. Comprende istruzioni di sistema, cronologia della conversazione, prove recuperate, risultati degli strumenti, memoria, policy, stato del compito e formattazione.
Le indicazioni moderne sull’ingegneria del contesto sostengono l’idea che il contesto del modello debba essere assemblato esplicitamente anziché trattato come una trascrizione grezza. Anthropic descrive l’ingegneria del contesto come il lavoro di gestione delle informazioni fornite agli agenti. Haystack e Atlan descrivono analogamente il contesto come zone strutturate, quali istruzioni, cronologia, recupero, risultati degli strumenti e memoria.
Questa distinzione conta perché classi diverse di contesto hanno durate e proprietà di attendibilità diverse. Un messaggio utente, l’ID di un file generato, un contenuto OAuth, un risultato di ricerca obsoleto, un errore di strumento per cui è possibile riprovare e una citazione di documento non dovrebbero essere rimossi, riassunti, conservati o esposti secondo la stessa regola.
La trascrizione è particolarmente ingannevole perché sembra completa. Contiene prove cronologiche che qualcosa è successo. Non contiene necessariamente l’evento grezzo, la policy che lo ha consentito, il ramo a cui apparteneva, il partecipante che lo ha visto o il motivo per cui i turni successivi dovrebbero ancora fidarsene. Per un prodotto di chat semplice, la cronologia può essere un’approssimazione sufficiente del contesto. Per gli agenti che usano strumenti, è solo un asse.
Ecco perché l’architettura tratta il contesto come una proiezione assemblata. La proiezione può includere turni recenti della conversazione, memorie selezionate degli strumenti, stato irrisolto degli strumenti, stato delle skill caricate, vincoli del provider e della privacy e artefatti grezzi selezionati. Può anche omettere record obsoleti, privati, sostituiti, non ammissibili per il ramo, oltre il budget o non sicuri per il provider selezionato. L’inclusione è una decisione, non un effetto accidentale dell’età dei messaggi.
2.2 Memoria degli agenti
La ricerca sulla memoria degli agenti distingue comunemente memoria di lavoro, episodica, semantica, procedurale e a lungo termine. Framework come LangGraph distinguono memoria a breve e a lungo termine. Le rassegne sulla memoria degli agenti LLM sottolineano che il campo è ancora frammentato: non esiste uno schema consolidato comune ai framework per rappresentazione, provenienza, freschezza, contraddizione o conservazione della memoria.
Questa frammentazione è importante. “Memoria” viene spesso usata come termine ampio per cose molto diverse: preferenze dell’utente, fatti estratti da conversazioni precedenti, riepiloghi di vecchi dialoghi, osservazioni degli strumenti, riferimenti a file generati, documenti recuperati, piani dei compiti, tracce di esecuzione e riferimenti di provenienza.
L’architettura separa la memoria dell’utente da quella degli strumenti. La memoria dell’utente gestisce la personalizzazione. Quella degli strumenti gestisce prove del runtime derivate dagli artefatti degli strumenti.
Questa separazione va oltre la classificazione del prodotto. Impedisce che un’osservazione del runtime diventi un fatto persistente sull’utente solo perché è apparsa in una chat. Se uno strumento legge una discussione Slack, può creare una memoria utile e circoscritta sul suo stato. Non dovrebbe diventare una preferenza permanente dell’utente. Se uno strumento di generazione documenti crea un file, il riferimento al file può essere stato operativo persistente. Non è lo stesso tipo di memoria di “l’utente preferisce risposte concise”.
La memoria degli strumenti richiede quindi campi che spesso non servono alla normale memoria di personalizzazione: ID degli artefatti, nomi degli strumenti di origine, classe di privacy, classe di freschezza, localizzatori di provenienza, fonte dell’attendibilità, tentativi di correzione, collegamenti di contraddizione, collegamenti di sostituzione e policy di promozione. In questa architettura, la memoria non è “ciò che il modello potrebbe voler ricordare”. È una rappresentazione compatta, governata da policy, di prove di cui il runtime può rendere conto.
2.3 Tracce degli strumenti come stato
Gli agenti che usano strumenti creano stato ogni volta che uno strumento viene richiamato. Argomenti della chiamata, risultato, errore, tempi, provider, runtime, stato delle skill attive e contesto di titolarità possono contare tutti in seguito.
Questo è sempre più riconosciuto nell’industria e nella ricerca. Databricks discute le sequenze di chiamate agli strumenti e i risultati di esecuzione come stato dell’agente. LangGraph rende persistenti lo stato del grafo e i punti di ripristino. MCP rende espliciti strumenti e fonti di contesto, consentendone una registrazione strutturata. Il lavoro sull’event sourcing sostiene che gli agenti autonomi abbiano bisogno di record di sola aggiunta che supportino ricostruzione e audit.
La deduzione chiave è che i risultati degli strumenti non dovrebbero vivere solo come messaggi della trascrizione. I messaggi sono utili per la visualizzazione. Sono un livello di archiviazione debole per le prove grezze.
Un messaggio della trascrizione è di solito ottimizzato per leggibilità umana e compatibilità con i client. Può essere troncato, oscurato, riassunto, riordinato per la presentazione o eliminato dalla compattazione. È proprio ciò di cui ha bisogno l’interfaccia di un prodotto. Non è ciò che serve a un sistema di recupero quando l’utente dice in seguito “usa esattamente il CSV di prima” o quando un audit chiede perché sia stato citato un particolare ID di file.
L’architettura acquisisce l’artefatto prima di quella trasformazione orientata alla visualizzazione. Il messaggio può comunque mostrare una scheda dello strumento pulita o un risultato compatto. L’archivio degli artefatti conserva gli argomenti grezzi, il risultato o errore grezzo, gli hash, i conteggi dei byte, i riferimenti di archiviazione, il titolare del runtime, la classificazione di privacy e i metadati di versione dello strumento necessari per recupero e audit.
2.4 Memoria obsoleta e contraddizione
La memoria persistente introduce una modalità di errore: l’agente può continuare ad affidarsi a informazioni diventate obsolete, contraddette o sostituite. Benchmark come STALE e studi come LOCCO mostrano che la memoria a lungo termine non è automaticamente affidabile. Ricordare di più può peggiorare il sistema se i vecchi fatti vengono trattati come verità attuali.
Questo sostiene policy esplicite di freschezza e sostituzione. Un riepilogo di una discussione Slack, un’istantanea CRM, un risultato sulla disponibilità del calendario, un riferimento a un file generato e una versione immutabile di un documento non dovrebbero invecchiare allo stesso modo.
Il problema della memoria obsoleta non è solo che i vecchi fatti diventano falsi. È che il modello li riceve spesso senza un indicatore visibile di scadenza. Un risultato di disponibilità del calendario di sei settimane prima e l’ID immutabile di una versione di documento possono entrambi apparire come “contesto precedente” se il runtime si limita a riproporre i messaggi. L’architettura rende esplicita questa differenza attraverso classi di freschezza e metadati che indicano dopo quando un dato diventa obsoleto.
La contraddizione è la modalità di errore collegata. Due memorie possono derivare entrambe da artefatti reali e risultare comunque in conflitto perché provengono da versioni diverse di documenti, rami diversi, provider diversi o metodi di estrazione diversi. Il sistema non dovrebbe appiattire quei record in un unico riepilogo in cui prevale l’ultima scrittura, a meno che una policy non disponga di informazioni sufficienti su provenienza e attendibilità per giustificare quella risoluzione.
2.5 Provenienza e audit
La memoria consapevole della provenienza è un tema emergente. MemORAI collega le memorie a grafo ai turni di origine. Portable Agent Memory propone oggetti di memoria con provenienza verificata. ARGUS usa grafi di influenza e provenienza per ragionare sulle chiamate non sicure agli strumenti. La letteratura su tracce di audit ed event sourcing sostiene analogamente che i sistemi AI necessitino di cronologie ricostruibili di eventi relativi a dati, modelli, strumenti e decisioni.
Per il runtime di un agente, la domanda importante dell’audit è:
Perché il modello ha detto questo?
La risposta non può venire dalla sola trascrizione. Richiede di sapere quale contesto è stato assemblato, quali memorie sono state incluse, quali artefatti grezzi sono stati reinseriti, quali policy hanno omesso dati e a quale partecipante o ramo apparteneva lo stato. C’è una seconda domanda di audit altrettanto importante:
Perché il modello non ha visto qualcosa?
È qui che l’assemblaggio governato da policy differisce dal normale logging. Un incidente in produzione potrebbe non essere causato da un cattivo risultato di uno strumento. Potrebbe essere causato dall’esclusione di un risultato utile perché obsoleto, oltre il budget, non ammissibile per il ramo, privato di un altro partecipante, classificato come dato derivato da Google o bloccato dal reinserimento dei dati grezzi. L’architettura registra riepiloghi compatti delle omissioni, così il debug può interrogare l’assenza, non solo la presenza.
3. Assemblaggio del contesto governato da policy
L’assemblaggio del contesto governato da policy tratta il contesto del modello come una proiezione sullo stato del runtime. La trascrizione non viene eliminata. Rimane la cronologia rivolta alle persone. Ma non le viene più chiesto di sostenere ogni responsabilità del runtime.
Il runtime distingue messaggi della trascrizione, esecuzioni dei modelli, chiamate agli strumenti, artefatti grezzi degli strumenti, memorie compatte degli strumenti, stato delle skill caricate, punti di ripristino per la continuazione, ascendenza dei rami, titolarità dei partecipanti, decisioni di policy e log dell’assemblaggio del contesto. Un assemblatore può quindi scegliere ciò che il modello vede in base al compito corrente, al ramo, al partecipante, al provider, alle policy di privacy e freschezza e allo stato di recupero.
Questo schema separa quattro superfici spesso confuse. La trascrizione è per l’utente: leggibile, stabile e adatta al prodotto. L’archivio degli artefatti è per il runtime e il livello di audit: prove grezze, recuperabilità e policy di conservazione. La memoria degli strumenti è per il contesto del modello: compatta, collegata alla provenienza e consapevole della freschezza. L’assemblaggio del contesto è per la richiesta al modello: la selezione governata da policy per una singola generazione.
La relazione più importante è:
l’esecuzione degli strumenti crea prima gli artefatti; la memoria è una decisione di policy applicata sopra di essi.
È questo il nucleo concettuale dell’architettura. La seconda relazione è:
l’assemblaggio del contesto è un’interrogazione del grafo vincolata da policy, non una trasformazione della trascrizione.
L’assemblatore parte dal confine della generazione attiva: chat corrente, messaggio utente di origine, ascendenza del ramo, partecipante, tipo di runtime, stato della continuazione, provider selezionato, skill caricate e disponibilità degli strumenti. Seleziona poi i record ammissibili del grafo e decide come deve apparire ciascuno. Un messaggio recente può rimanere contesto della conversazione. Un’osservazione di uno strumento può entrare come memoria compatta. Un record obsoleto può apparire solo come indicatore di obsolescenza e suggerimento di riconvalida. Un artefatto grezzo può essere reinserito quando servono prove esatte. Una chiamata irrisolta a uno strumento può essere protetta come stato di recupero. Un record privato, obsoleto, sostituito, non ammissibile per il ramo o limitato per il provider può essere omesso, registrando il motivo senza esporne il contenuto.
Questa impostazione non richiede che ogni operazione di recupero avvenga da un database a grafo. Il grafo è il modello del runtime: conversazioni, rami, partecipanti, esecuzioni dei modelli, chiamate agli strumenti, artefatti, memorie, punti di ripristino, assemblaggi e decisioni di policy collegati tra loro. Ricerca vettoriale, interrogazioni di tabelle indicizzate, letture dall’archivio e attraversamento del grafo possono essere tutte tecniche di implementazione all’interno di quel modello.
Un modello mentale utile è:
Trascrizione visibile all’utente = una proiezione leggibile di nodi Message selezionati
Contesto rivolto al modello = una proiezione selezionata dalle policy su Message + ToolMemory + ToolArtifact + SkillState + ContinuationCheckpoint + PolicyDecision + ascendenza del ramo
La differenza non è accademica. Una trascrizione risponde a “Che cosa sembrano aver detto l’utente e l’assistente?”. Un grafo del runtime risponde alle domande a cui la trascrizione non può rispondere: quale esecuzione del modello ha prodotto la risposta, quali strumenti ha richiesto, quali artefatti hanno prodotto quegli strumenti, quali memorie sono state ricavate dagli artefatti, a quale ramo e partecipante apparteneva lo stato, quale policy ha consentito o omesso ogni record e quali memorie precedenti erano obsolete, contraddette o sostituite.
Sono queste domande a rendere prezioso l’approccio a grafo. Trasforma la selezione del contesto in un’interrogazione su relazioni tipizzate anziché in una strategia di troncamento di un elenco di messaggi.
In pratica, l’approccio a grafo ha tre compiti. Conserva le prove mantenendo gli artefatti grezzi degli strumenti fuori dalla trascrizione, nel rispetto delle policy di conservazione e privacy. Crea un contesto compatto e utilizzabile trasformando i contenuti utili degli artefatti in memorie degli strumenti per le normali chiamate al modello. E spiega la selezione registrando perché un modello ha visto una proiezione del grafo anziché un’altra.
Il grafo non deve essere visibile agli utenti. L’utente vede la conversazione. Il runtime usa il grafo per decidere che cosa debba sapere la chiamata successiva al modello.
TRADITIONAL TRANSCRIPT REPLAY
- Message
- Message
- Message
- Message
- LARGE PROMPT
Replays old tool calls and results
Includes stale, private, and noisy data
Loses important structure and provenance
Wasteful, expensive, error-prone
POLICY-GOVERNED ASSEMBLY
- RAW ARTIFACTS
- COMPACT MEMORIES
- SELECTED CONTEXT
- MODEL REQUEST
Keeps raw evidence out of the prompt
Includes only relevant, current, and allowed data
Preserves provenance and recovery state
Smaller, faster, safer, and more reliable
4. Schema di implementazione
Questa sezione descrive la forma concreta dello schema implementato in NanthAI:Edge. I dettagli sono utili perché mostrano che cosa deve esistere quando la trascrizione non è più la fonte di verità del contesto del modello.
4.1 Modello del grafo del runtime
Il grafo del runtime parte rendendo esplicite le entità importanti. Una Conversation è il contenitore della chat appartenente all’utente. Un Branch è un percorso ordinato attraverso quel grafo della conversazione, che eredita la cronologia condivisa precedente. Un Participant è la configurazione del modello o del profilo Persona attiva per un’esecuzione. Un Message è il nodo della trascrizione visibile all’utente. Un ModelRun è un tentativo di generazione rivolto al provider per un partecipante, messaggio o attività.
Il lavoro degli strumenti ha poi un proprio vocabolario. Una ToolCall è la chiamata di funzione richiesta dal modello, con argomenti e ID della chiamata. Un ToolArtifact è il record grezzo persistente dell’esecuzione per quella chiamata o risultato. Una ToolMemory è la memoria compatta rivolta al modello ricavata da uno o più artefatti. SkillState acquisisce skill caricate, profili attivi, strumenti diretti e stato delle integrazioni visibili a un’esecuzione. Un ContinuationCheckpoint conserva lo stato del runtime riprendibile attraverso i confini delle azioni.
Anche il livello di assemblaggio è esplicito. Un ContextAssembly è il record versionato delle decisioni per un assemblaggio del prompt rivolto al modello. Una PolicyDecision registra decisioni di privacy, freschezza, rimozione, reinserimento dei dati grezzi, instradamento verso i provider o recupero.
Le relazioni canoniche sono semplici.
- Il contenuto della trascrizione dell’assistente viene generato da uno specifico ModelRun.
- Un ModelRun richiede uno o più record ToolCall.
- Ogni ToolCall eseguita, fallita, in attesa o differita produce un ToolArtifact persistente.
- Da quell’artefatto viene ricavata una ToolMemory, conservando la provenienza fino alle prove grezze.
- I rami ereditano dai rami precedenti senza copiare tutto lo stato.
- Un ContextAssembly registra quali memorie sono state incluse e quali artefatti grezzi sono stati reinseriti.
- Un ContinuationCheckpoint ripristina lo stato del runtime anziché i soli messaggi della trascrizione.
- Una PolicyDecision vincola l’assemblaggio rendendo esplicite le scelte di privacy, provider, freschezza, rimozione e recupero.
Runtime graph
- Conversation
- Branch
- Participant
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- Participant
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- Participant
- Branch
Tool memories across the active lineage → ContextAssembly → PolicyDecision → Checkpoint
Relationships
Conversation contains / has Branches; Branches inherit from the conversation.
Branches contain Participants; Participants contain Messages; Messages generate ModelRuns.
ModelRun requests ToolCall; ToolCall produces ToolArtifact; ToolMemory is derived from ToolArtifact.
ToolMemory is assembled into ContextAssembly. ContextAssembly is constrained by PolicyDecision. Checkpoint restores state.
Legend: contains / has; inherits from; generates; requests; derived from; assembled into; constrained by; restores.
4.2 Artefatti persistenti degli strumenti
Un ToolArtifact è il record grezzo persistente dell’esecuzione di uno strumento.
Acquisisce ID della chiamata, nome dello strumento, argomenti, risultato o errore grezzo, stato, titolarità del messaggio e dell’attività, titolarità del partecipante e dell’esecuzione del modello, ambito del ramo, classificazione di privacy, skill attive e profili di strumenti, metadati di provider e runtime e riferimenti di archiviazione per argomenti o risultati troppo grandi.
I risultati degli strumenti a livello di messaggio possono continuare a esistere per compatibilità con i client e visualizzazione. Possono essere troncati, riassunti o adattati all’interfaccia. Va bene per la visualizzazione. Non basta per flussi di lavoro lunghi, audit, nuovi tentativi o reinserimento esatto dei dati.
Il passaggio importante è acquisire gli artefatti completi prima del troncamento a livello di messaggio. L’interfaccia può restare compatta mentre il backend conserva prove recuperabili.
Questo conta quando un turno successivo richiede esattamente il CSV di una precedente chiamata a uno strumento, una chiamata fallita deve essere ritentata, un selettore differito deve proseguire, un documento citato deve essere spiegato, l’ID di un file generato deve sopravvivere, il risultato di un sottoagente deve essere sottoposto ad audit o un contenuto privato di uno strumento deve restare fuori dai contesti dei modelli fratelli.
4.3 Memorie degli strumenti
Una ToolMemory è un record compatto rivolto al modello, ricavata da uno o più artefatti.
Le memorie degli strumenti sono separate da quelle dell’utente. Le memorie dell’utente rappresentano personalizzazione e fatti persistenti sull’utente. Quelle degli strumenti rappresentano prove del runtime e stato derivato dagli strumenti.
Le memorie degli strumenti contengono ID degli artefatti di origine, nomi degli strumenti di origine, testo di riepilogo, contenuti strutturati, attendibilità, fonte e motivazione dell’attendibilità, note su ambiguità e limiti, classificazione di privacy, classe di freschezza, data e ora oltre cui il dato è obsoleto, strumenti di riconvalida, localizzatori di provenienza, ultimo stato di risoluzione, tentativi di correzione, collegamenti di contraddizione e sostituzione e policy di promozione.
L’obiettivo non è far ricordare tutto al modello. È rendere la memoria verificabile. Una memoria compatta dovrebbe conservare abbastanza provenienza da permettere al sistema di rispondere in seguito da dove proviene, se è ancora valida e se le prove grezze esatte possono o devono essere reinserite.
- 1. USER REQUEST: User asks a question or gives a task
- 2. MODEL RUN: Model decides to call one or more tools
- 3. TOOL CALL(S): Tool(s) executed with arguments from the model
- 4. TOOL ARTIFACT: Raw result or error captured as durable evidence (artifact)
- 5. TOOL MEMORY: Compact memory derived from artifact(s) with provenance
- 6. CONTEXT ASSEMBLY: Policy selects what to include, what to rehydrate, what to omit, and why
- 7. MODEL REQUEST: Assembled context sent to the model for the next generation
FEEDBACK LOOPS (as needed)
Revalidation · Retries · Continuations · Checkpoints · Branches · Subagent Promotion
Feedback returns to the relevant execution and context stages.
4.4 ContextAssembly
ContextAssembly è il record esplicito di ciò che è entrato in una specifica richiesta al modello.
Conserva il numero di messaggi del sistema precedente, il numero di messaggi assemblati, la differenza stimata di token, il numero di artefatti grezzi, il numero di memorie selezionate e di artefatti reinseriti, la versione delle policy e dell’assemblatore, i riferimenti selezionati del grafo, i riepiloghi delle omissioni, le decisioni di sicurezza e privacy e i tempi di interrogazione del grafo, valutazione delle policy e serializzazione.
L’obiettivo dell’audit è:
Perché il modello ha visto questo contesto?
La risposta non dovrebbe essere “perché era negli ultimi N messaggi”. Dovrebbe essere più vicina a:
Questa risposta ha incluso ToolMemory_123, ricavata da ToolArtifact_88, ereditata dal ramo attivo, visibile a questo partecipante, assemblata con la versione 4 delle policy, saltando il reinserimento dell’artefatto grezzo perché la memoria compatta era sufficiente.
Oppure:
Questa risposta ha omesso un contenuto grezzo derivato da Google perché le policy di instradamento verso i provider e di privacy lo classificavano come limitato, ma ha incluso un riepilogo sicuro e un’indicazione sullo strumento di riconvalida.
4.5 PolicyDecision
L’assemblaggio del contesto è valutazione di regole, non solo taglio.
- Le policy di titolarità chiedono a quale partecipante o esecuzione del modello appartiene un record.
- Le policy di visibilità decidono se è privato del partecipante, visibile al ramo, visibile alla conversazione o riservato all’audit.
- Le policy di privacy determinano se i dati possono essere inviati al modello o provider selezionato.
- Le regole di freschezza decidono se un record è attuale, obsoleto, persistente o richiede riconvalida.
- Le policy di promozione decidono se un artefatto debba diventare memoria rivolta al modello.
- Le policy di reinserimento decidono se la memoria compatta basta o se servono prove grezze esatte.
- Le policy di contraddizione e sostituzione risolvono conflitti e rimpiazzi.
- Le policy di recupero proteggono lo stato irrisolto, fallito, differito o cruciale per un nuovo tentativo.
- Le policy di conservazione decidono se il record debba essere mantenuto, rimosso, archiviato o eliminato.
L’implementazione registra riepiloghi compatti delle policy e conteggi delle omissioni anziché tracce dettagliate per ogni record in ogni assemblaggio di produzione. Le tracce dettagliate restano disponibili nei test e negli audit mirati.
| Scenario | Policy Decision | Action | In Context? | Why |
|---|---|---|---|---|
| Google Gmail body (ZDR provider) | Privacy / Provider Restriction | Omit raw body, include safe summary + revalidation tool | Partial | Provider cannot receive Google content |
| Slack thread summary (2 weeks old) | Freshness (Bounded) | Include as stale marker + revalidation tool | Stale | May be outdated, needs recheck |
| Generated CSV file handle | Durability (Session) | Include compact memory (file ID, schema) | Yes | Still valid in session, low risk |
| Sibling branch analysis result | Branch Visibility (Branch-Private) | Omit from active branch context | No | Different branch, not relevant |
| Failed tool call (retry needed) | Recovery (Protected) | Include error + retry state | Yes | Required for recovery |
Every inclusion or omission is logged with policy version, reason, and scope.
4.6 Classi di contesto
Il contesto viene classificato in base a come dovrebbe essere rimosso, conservato, riassunto, reinserito ed esposto.
- Il contesto della conversazione include il testo di utente e assistente o discussioni locali al ramo e può essere limitato a una finestra e riassunto.
- Il contesto operativo include argomenti e risultati degli strumenti, percorsi dello spazio di lavoro e ID dei file generati; dovrebbe essere conservato come artefatto prima di essere riassunto.
- Il contesto epistemico include affermazioni, conclusioni e fatti estratti e appartiene alla memoria degli strumenti con metadati di attendibilità e freschezza.
- Il contesto di provenienza include ID degli artefatti, ID dei documenti e citazioni e dovrebbe essere conservato per l’audit o reinserito quando le affermazioni ne dipendono.
- Il contesto delle regole include vincoli dei provider, ambiti OAuth e diritti di accesso e deve essere applicato prima dell’assemblaggio.
- Il contesto di recupero include errori, stato differito e contratti per i nuovi tentativi e non dovrebbe essere rimosso finché è irrisolto.
- Il contesto di pianificazione include skill caricate, profili attivi e scomposizione dei compiti per l’esecuzione o continuazione corrente.
Questo impedisce che l’età dei messaggi diventi l’unica regola di rimozione.
4.7 Freschezza e obsolescenza
Le memorie degli strumenti non devono diventare silenziosamente verità eterne. Ogni memoria riceve una classe di freschezza:
- Le memorie volatili coprono elementi come conteggi dei non letti, disponibilità e ordine dei risultati di ricerca.
- Le memorie di sessione coprono file temporanei del runtime, directory di lavoro e stato provvisorio.
- Le memorie circoscritte coprono istantanee come record CRM, riepiloghi di discussioni Slack o stato delle pagine Notion.
- Le memorie persistenti coprono metadati di file generati, citazioni di documenti e ID espliciti di entità dei provider.
- Le memorie permanenti coprono ID immutabili di versioni di documenti o identità di artefatti di archiviazione generati.
L’assemblatore non inserisce per impostazione predefinita memorie volatili o circoscritte obsolete come fatti attuali. Può includerle come contesto obsoleto, esporre un percorso di riconvalida, ometterle o scegliere il reinserimento dei dati grezzi quando servono prove esatte ed è consentito.
4.8 Contraddizione e sostituzione
Questo approccio evita, dove possibile, una memoria in cui prevale l’ultima scrittura.
Le memorie degli strumenti possono essere in conflitto. Un ramo può analizzare una bozza di documento e produrre una conclusione. Un altro ramo può analizzare una versione successiva. Una ricerca presso un provider può riportare un numero di dipendenti di un’azienda che una ricerca successiva contraddice. Un modello può riassumere erroneamente una fonte mentre un altro estrae il valore esatto dal file grezzo.
Il runtime tiene traccia di collegamenti di conflitto e sostituzione, attendibilità, fonte dell’attendibilità, artefatti di origine, limiti e note di ambiguità. I campi importanti hanno una direzione: conflictsWith indica un disaccordo, supersedes significa che la memoria corrente sostituisce memorie precedenti e supersededBy punta da una memoria obsoleta al suo rimpiazzo.
La policy è prudente. Le memorie in conflitto restano record separati. Le memorie sostituite vengono normalmente omesse dal contesto attuale del modello, mentre il rimpiazzo corrente resta selezionabile. Entrambi i lati di una contraddizione possono essere inclusi quando l’incertezza conta. La risoluzione richiede provenienza e attendibilità, non solo recenza.
Un dettaglio pratico conta: supersedes dovrebbe significare “questa memoria corrente sostituisce memorie precedenti”. La direzione opposta dovrebbe usare un campo separato come supersededBy.
Sembra un dettaglio, ma qui l’ambiguità può causare veri errori. Un assemblatore che scarta la memoria sostitutiva invece di quella obsoleta può far ragionare il modello su uno stato vecchio, credendo di essere prudente.
4.9 Titolarità dei partecipanti e del runtime
NanthAI:Edge supporta esecuzioni multimodello, discussioni autonome, sottoagenti, rami, attività pianificate e continuazioni con uso intenso di strumenti. Questo rende importante la titolarità.
Un messaggio visibile dell’assistente può diventare contesto condiviso della conversazione.
Ma lo stato grezzo del runtime non dovrebbe diventare automaticamente condiviso solo perché è stato prodotto nella stessa chat.
In questa architettura, artefatti degli strumenti, memorie degli strumenti, assemblaggi del contesto e punti di ripristino per la continuazione portano metadati di titolarità come visibilityScope, ownerParticipantId, ownerModelRunId, sharedWithParticipants, runtimeIsolationPolicy e runtimeKind.
La policy predefinita prevede che lo stato dell’esecuzione del modello sia delimitato per partecipante e isolato. Il risultato dell’assistente visibile all’utente può diventare contesto del ramo o della conversazione dopo la finalizzazione. Lo stato provvisorio privato non passa ai partecipanti fratelli. Le chiamate irrisolte agli strumenti restano visibili al partecipante titolare e alle continuazioni necessarie. Gli artefatti dei sottoagenti figli restano privati o riservati all’audit finché non vengono promossi esplicitamente.
È una delle parti meno documentate dell’architettura degli agenti.
Molti esempi con più agenti discutono la collaborazione. Meno esempi definiscono il confine tra ciò che un modello ha detto visibilmente, ciò che ha visto privatamente, ciò che hanno restituito i suoi strumenti, ciò che ha scoperto un sottoagente figlio, ciò che il padre può usare in seguito e ciò che resta riservato all’audit.
Questa architettura rende esplicito quel confine.
4.10 Assemblaggio del grafo consapevole dei rami
Le conversazioni di NanthAI possono ramificarsi. Questo significa che l’assemblaggio del contesto non può essere solo “recupera le memorie recenti per ID della chat”. Se due rami producono ID di documenti, file generati o risultati di analisi diversi, il ramo attivo non dovrebbe essere contaminato da artefatti più recenti di un ramo fratello.
La soluzione è rendere l’assemblaggio consapevole dei rami. I candidati vengono selezionati prima dall’ascendenza del ramo attivo. I record condivisi esplicitamente o con ambito di conversazione possono comunque riempire gli spazi rimanenti, ma lo stato privato dei rami fratelli non sottrae posto al contesto del ramo attivo.
I log dell’assemblaggio del contesto distinguono le esclusioni per ramo dalle normali omissioni dovute al budget di contesto. È importante perché gli errori dei rami sono sottili. Il modello può rispondere con sicurezza usando un file, una citazione o un ID di documento che appartiene a un ramo diverso. L’interfaccia sembrerà corretta. La trascrizione sembrerà plausibile. Ma il runtime avrà mescolato due percorsi incompatibili.
L’assemblaggio consapevole dei rami tratta la conversazione come un grafo, non come un elenco piatto di messaggi.
BROKEN: TRANSCRIPT REPLAY (BRANCH POLLUTION)
- Root conversation → Branch Point (User question)
- Branch A (Active) → Generates File_A.csv
- Branch B (Sibling) → Generates File_B.csv
- Active Branch A – Next Call Context: Root conversation; Branch A messages; File_A.csv (correct); Branch B messages (leaked); File_B.csv (incorrectly included)
Linear transcripts can leak sibling branch artifacts into the active branch.
POLLUTION EXAMPLE: When Branch A asks a follow-up, transcript replay includes everything in the history — including artifacts from Branch B.
Result: Sibling branch contamination, higher token cost, and incorrect or confusing model context.
CORRECT: BRANCH-AWARE ASSEMBLY
- Root conversation → Branch Point (User question)
- Branch A (Active) → File_A.csv
- Branch B (Sibling) → File_B.csv (Private to B); Explicit Share (Optional) → Branch A
- Active Branch A – Next Call Context: Root conversation; Branch A messages; File_A.csv (correct); Shared from B (if any); Branch B private items (excluded)
Assembler selects only active lineage and explicitly shared records.
ASSEMBLY RULES (Examples): Include active lineage only; Include explicitly shared records; Respect branch-private boundaries; Apply policy and freshness rules; Avoid sibling branch leakage.
Result: Clean, relevant context. Lower token cost. No branch leakage. Policy-governed and auditable.
Legend: Active Branch; Sibling Branch; Branch Point; Message; Artifact / Generated File; Explicitly Shared; Branch-Private (Not Visible); Active Lineage; Sibling Lineage; Explicit Share; Leak / Pollution (Bad).
4.11 Reinserimento dei dati grezzi
La memoria compatta di solito basta. A volte no. Se l’utente chiede “usa esattamente il CSV precedente”, un riepilogo non è sufficiente. Il runtime deve recuperare l’artefatto grezzo.
L’architettura supporta un reinserimento delimitato dei dati grezzi. La parola importante è delimitato. Gli artefatti grezzi conservati nell’archivio vengono reinseriti solo dopo la selezione secondo le policy, non in anticipo.
L’assemblatore verifica se servono dettagli esatti, se l’artefatto è stato selezionato, se la classificazione di privacy è consentita, se il budget di byte è accettabile, se il percorso verso il provider è consentito e se il record è irrisolto o cruciale per il recupero.
- In caso affermativo, l’artefatto grezzo può essere incluso.
- Altrimenti, l’assemblatore può includere una memoria compatta, un riferimento, un indicatore di obsolescenza, un suggerimento di riconvalida o nulla.
Questo evita due estremi negativi: riproporre per sempre i contenuti grezzi degli strumenti e perdere nei riepiloghi prove che ai turni successivi servono esattamente.
POLICY-GOVERNED ASSEMBLY
- RAW ARTIFACTS
- COMPACT MEMORIES
- SELECTED CONTEXT
- MODEL REQUEST
Keeps raw evidence out of the prompt
Includes only relevant, current, and allowed data
Preserves provenance and recovery state
Smaller, faster, safer, and more reliable
4.12 La cognizione del runtime non è l’esperienza utente
Questa architettura aggiunge molto stato interno al runtime. Quello stato non appartiene automaticamente all’interfaccia della chat. Memorie degli strumenti, assemblaggi del contesto, decisioni di policy, record di correzione della provenienza, conteggi delle omissioni e tracce delle interrogazioni del grafo sono cognizione del runtime.
Non dovrebbero diventare testo della conversazione a meno che l’utente non chieda una spiegazione di audit o debug o apra intenzionalmente un pannello di ispezione.
Questo confine è importante. Molti prodotti AI lo sfumano. L’assistente comincia a raccontare nella conversazione la propria memoria, le policy, lo stato interno e la contabilità degli strumenti.
Questo rende la trascrizione più rumorosa e spesso meno affidabile. In NanthAI:Edge, la trascrizione rivolta all’utente resta la superficie del prodotto. Il grafo del runtime resta la superficie di esecuzione.
La provenienza può apparire attraverso citazioni, schede dei file generati, viste di debug o un futuro pannello “perché il modello ha detto questo?”.
Ma il runtime non dovrebbe riscrivere la cronologia della conversazione per spiegare sé stesso.
4.13 Confini delle modalità del runtime
Modalità diverse del runtime richiedono policy di assemblaggio diverse. La chat normale e quella multimodello usano il contesto assemblato consapevole dei rami per il partecipante attivo. La discussione autonoma conserva la struttura del prompt del dibattito, le direttive del moderatore, le etichette degli interlocutori e i contenuti non testuali supportati, aggiungendo contesto assemblato visibile al partecipante. L’esecuzione di un sottoagente figlio acquisisce artefatti e memorie degli strumenti locali al figlio con titolarità del figlio, privati o riservati all’audit per impostazione predefinita. La ripresa del padre di un sottoagente mantiene il proprio punto di ripristino deterministico, allega riferimenti selezionati dell’assemblaggio e registra la decisione di ripristino anziché interrogare ciecamente la trascrizione. Le attività pianificate usano il normale percorso di generazione del backend, in cui l’attività crea turni di chat e li instrada alla generazione. Gli invii nei rami di Ideascape usano lo stesso percorso di generazione consapevole dei rami dopo che il client ha inviato ID espliciti dei messaggi padre.
Questo è stato un importante passaggio di completamento, perché gli errori di contesto più difficili spesso vivono ai confini dell’orchestrazione. Un normale turno di chat può usare direttamente ramo e partecipante attivi. La ripresa di un padre dopo i sottoagenti è diversa: il padre dovrebbe ricevere riepiloghi promossi dei figli, riferimenti ai file generati, stato dei figli falliti e stato pertinente ai nuovi tentativi, ma non contenuti grezzi dello spazio di lavoro dei figli, a meno che non siano stati promossi esplicitamente.
Questo richiede metadati come tipo di runtime, ID di gruppi ed esecuzioni dei sottoagenti, ID di messaggi e attività del padre, ID delle chiamate agli strumenti del padre e decisioni di promozione dove necessario. Il punto non è creare altri schemi fini a sé stessi. È rendere rappresentabili le decisioni di titolarità e promozione prima che l’assemblatore serializzi qualsiasi cosa in una richiesta al provider.
4.14 Confini della promozione dei sottoagenti
I sottoagenti rendono concreta la separazione tra trascrizione e contesto.
Un sottoagente figlio può richiamare strumenti, leggere documenti, generare file intermedi, incontrare errori e mantenere uno stato provvisorio privato. Al padre possono bastare il report finale del figlio, un riferimento a un file generato, un riepilogo compatto dell’errore o lo stato di un gruppo di esecuzioni. Se il runtime archivia lo stato del figlio solo come messaggi in forma di trascrizione, è allettante riproporre troppo al padre. Se scarta lo stato del figlio dopo averlo riassunto, audit e recupero ne risentono.
Il runtime usa una semantica di promozione. Argomenti e risultati grezzi degli strumenti del figlio sono privati del figlio o riservati all’audit per impostazione predefinita. I riferimenti ai file generati diventano visibili al padre dopo la promozione al termine dell’esecuzione del figlio. Il report finale del figlio è visibile alla ripresa del padre. Lo stato di un figlio fallito o scaduto può essere promosso come contesto di recupero compatto. I dettagli provvisori o dello spazio di lavoro del figlio non sono visibili al padre, salvo promozione esplicita.
Questo dà al padre abbastanza contesto per proseguire senza trasformare ogni esecuzione del figlio in bagaglio grezzo della trascrizione.
Parent Agent (Orchestrator) — Before Subagent Call
- User request: “Research ACME Corp and prepare a report.”
- Subagent Call: Task scope, inputs, and constraints
Parent State (continues): Conversation history; Long-term memories; Policy & preferences; Runtime checkpoints
Child Subagent (Isolated Runtime) — Owns private runtime state and working context
Does Private Work: Tool Calls — Executes tools and external API calls; Raw Tool Payloads — Full results, responses, files, logs (verbose); Scratch / Intermediate State — Notes, reasoning, partial results, drafts, retries; Temporary Artifacts — Working files, temp exports, debug data.
Private to Subagent: Not visible to parent.
Produces Outputs: Final Report / Answer — Curated, high-quality result for the parent; Generated File Handle — Compact reference (file ID, schema, hash, storage pointer); Compact Memories — Summaries with provenance, TTL, and freshness; Audit Trail (Optional) — Tool call list, key decisions, policy summary (not raw data).
Isolation Boundary: Subagent state is not accessible to the parent at any time.
Promotion Gate
Policy-driven promotion of explicit outputs only. Everything else stays private.
Parent Resumes (after subagent completion)
- Receives Promoted Outputs Only: Final Report / Answer; Generated File Handle; Compact Memories; Audit Trail (if provided)
- Parent State (updated): Adds promoted memories; Stores file handle reference; Records audit summary; Continues conversation
- Next Steps: Parent decides what to do next (e.g., follow-up questions, new tasks, branch, or additional subagents).
What gets promoted?
Final Report / Answer: Curated output intended for the parent.
Generated File Handle: Stable reference to large or expensive artifacts.
Compact Memories: Bounded, policy-checked context for future turns.
Audit Trail (Optional): High-level trace for accountability (no raw data unless allowed).
What stays private?
Raw tool payloads
Scratch / intermediate state
Temporary artifacts
All internal tool activity
Only promoted outputs cross the boundary.
Isolation Guarantees
No raw data leakage: Parent never sees raw tool payloads or scratch state.
Least-privilege promotion: Only explicit, policy-approved outputs are shared.
Bounded lifetime: Subagent state is discarded after completion.
Clean parent context: Parent resumes with only promoted, relevant context.
Auditability preserved: Policy decisions and summaries are recorded for traceability.
4.15 Conservazione e garbage collection
Gli artefatti persistenti creano una responsabilità di archiviazione. L’architettura non implica “conservare tutto per sempre”. Implica rendere esplicita la conservazione.
Il modello di conservazione deve bilanciare verificabilità e privacy. Gli artefatti grezzi possono essere mantenuti, archiviati, oscurati, convertiti in hash, conservati separatamente o eliminati secondo le policy. I contextAssemblyLogs campionati dovrebbero essere ripuliti con decisione. L’eliminazione dell’account deve ripulire artefatti, memorie e log degli assemblaggi. Gli artefatti riservati all’audit dovrebbero restare fuori dal normale contesto del modello. I contenuti conservati nell’archivio dovrebbero essere reinseriti solo dopo controlli di privacy e budget di byte. I riferimenti a file generati e documenti richiedono una pulizia che conservi i riferimenti, così citazioni attive e riferimenti ai file non si interrompono.
È uno dei motivi per cui l’architettura è particolarmente giustificata per il lavoro impegnativo con gli strumenti.
Conservare le prove grezze migliora recupero e audit, ma aumenta anche l’onere di classificazione, crittografia, controllo degli accessi, eliminazione e rigore nell’instradamento verso i provider.
5. Analisi dell’architettura
5.1 Modello del costo in token
Con la riproposizione della trascrizione, il costo rivolto al modello di una conversazione con uso intenso di strumenti è approssimativamente:
conversation_window + historical_tool_calls + historical_tool_results + summaries + retry_state
Con l’assemblaggio del contesto basato sul grafo, il costo è approssimativamente:
conversation_window + selected_tool_memories + protected_recovery_state + selected_skill_state + optional_raw_rehydration
La distinzione critica è ciò che cresce con il volume storico degli strumenti. Nella riproposizione della trascrizione, i vecchi contenuti degli strumenti possono restare nel percorso di riproposizione finché non vengono tagliati o riassunti. In questa architettura, gli artefatti grezzi vengono conservati separatamente e solo memorie compatte, stato irrisolto protetto o prove reinserite esplicitamente entrano nel contesto del modello.
È questo il nucleo economico dell’architettura.
5.2 Artefatti grezzi e memorie compatte
La separazione tra artefatti grezzi e memoria crea due livelli. Il livello delle prove contiene argomenti completi, risultati grezzi, errori, hash, riferimenti di archiviazione, provenienza e metadati del runtime. Il livello del contesto contiene riepiloghi compatti, fatti strutturati, riferimenti ai file generati, indicatori di obsolescenza, metadati di attendibilità e suggerimenti di riconvalida.
Questo permette al sistema di ridurre le dimensioni del contesto senza perdere verificabilità. Un riepilogo può essere economico e utile, ma non dovrebbe essere l’unico record rimasto.
5.3 ContextAssembly come confine della cache e dell’audit
L’assemblaggio del contesto crea un confine stabile tra stato archiviato e serializzazione delle richieste al provider. Il runtime può cambiare il modo in cui serializza i messaggi, ma il record dell’assemblaggio continua a registrare quali riferimenti del grafo sono stati selezionati e quale versione delle policy li ha selezionati.
L’architettura mira a una riproducibilità legata alla versione delle policy, non a una riproposizione identica byte per byte per sempre. Questo significa che la stessa versione delle policy sullo stesso snapshot del grafo dovrebbe selezionare lo stesso insieme di artefatti e memorie, lo stesso stato grezzo protetto e le stesse decisioni di policy. Non garantisce una tokenizzazione identica o risultati identici di modelli attivi presso provider non deterministici.
5.4 Contesto delimitato per partecipante
Nella chat multimodello, condividere la trascrizione e condividere il runtime sono cose diverse.
Se due modelli rispondono allo stesso prompt utente, l’utente può vedere entrambi i risultati finali affiancati. Questo non significa che gli appunti privati, gli errori degli strumenti o i contenuti grezzi derivati da OAuth del modello A debbano essere visibili al modello B.
L’architettura rende esplicita questa distinzione tramite l’ambito di visibilità e le policy di isolamento del runtime.
È un vantaggio sostanziale nella valutazione. Gli errori possono essere scomposti per livello: se il record era visibile al ramo, privato del partecipante, riservato all’audit, promosso, obsoleto, omesso dalle policy del provider o della privacy oppure ripristinato perché servivano prove esatte.
5.5 Assemblaggio del contesto come interrogazione del grafo
L’architettura inquadra l’assemblaggio del contesto come un’interrogazione sulle entità del runtime vincolata da ascendenza del ramo attivo, visibilità del partecipante, isolamento del runtime, classificazione di privacy, policy di promozione e freschezza, provenienza dell’attendibilità, contraddizione e sostituzione, stato della continuazione, protezione di nuovi tentativi e recupero, budget del contesto e limiti del reinserimento dei dati grezzi.
Ecco perché “GraphRAG” non è l’inquadramento principale giusto. GraphRAG è solitamente recupero su conoscenze di dominio o relazioni tra documenti. Il grafo del runtime comprende stato di esecuzione, policy, partecipanti, rami, artefatti, memorie e assemblaggi del contesto.
Il grafo del runtime è più ampio di un grafo della conoscenza.
5.6 Determinismo e riproducibilità
L’architettura mira a una riproducibilità legata alla versione delle policy, non a una riproposizione del prompt identica byte per byte per sempre.
Questa distinzione è importante. Un SDK del provider può cambiare la serializzazione. L’instradamento OpenRouter può cambiare il modello dietro un percorso automatico. La tokenizzazione può differire tra provider. Una chiamata a un modello attivo può essere non deterministica anche con un input identico.
L’obiettivo di riproducibilità è più circoscritto e più utile. La stessa versione delle policy sullo stesso snapshot del grafo dovrebbe selezionare lo stesso insieme di artefatti e memorie, lo stesso stato grezzo protetto e le stesse decisioni di policy. Le decisioni di privacy, instradamento verso i provider, ambito del ramo, nuovi tentativi e continuazione dovrebbero essere spiegabili dallo stato archiviato. Un assemblaggio precedente dovrebbe essere sostanzialmente ricostruibile per i flussi di audit e debug. Modifiche innocue di formattazione non dovrebbero distruggere la verificabilità semantica.
Ecco perché policyVersion, assemblerVersion, riferimenti selezionati, riepiloghi delle omissioni e campi dei tempi contano. Definiscono il confine tra stato del runtime e serializzazione dei messaggi al provider.
5.7 Perché non è solo un contesto più grande
Finestre di contesto grandi aiutano, ma non risolvono il problema architetturale.
Una finestra più grande può contenere più prove obsolete, più stato provvisorio privato, più rumore dei rami fratelli, più vecchi errori degli strumenti e più contenuti grezzi derivati da OAuth. Può ritardare il momento in cui il taglio diventa visibile, ma non decide che cosa meriti di essere incluso.
L’architettura non è un argomento contro i modelli con contesti grandi. Sostiene che le finestre di contesto debbano essere riempite deliberatamente. L’assemblatore può comunque usare una finestra grande quando il compito ne ha bisogno. La differenza è che artefatti grezzi, memorie compatte, stato di recupero e vincoli di policy competono attraverso policy esplicite anziché sopravvivere per cronologia.
6. Confronto con il lavoro precedente
L’architettura si inserisce in una solida tradizione di lavoro su ingegneria del contesto, runtime a grafo, memoria, provenienza e audit.
- L’ingegneria del contesto è ormai un concetto diffuso nella progettazione degli agenti. Anthropic, Haystack, Atlan e altri hanno tutti sostenuto che il contesto del modello debba essere assemblato esplicitamente da istruzioni, cronologia, dati recuperati, strumenti, memoria e stato del compito anziché essere trattato come una stringa di prompt.
- LangGraph offre precedenti solidi per stato a grafo, thread, punti di ripristino, istantanee, riproposizione e modelli di esecuzione durevole.
- I sistemi di memoria degli agenti distinguono memoria a breve termine, a lungo termine, episodica, semantica, procedurale e di lavoro.
- MCP e i framework per l’uso degli strumenti rendono gli strumenti espliciti e registrabili.
- La letteratura su event sourcing e tracce di audit sostiene record di esecuzione di sola aggiunta e cronologie ricostruibili.
- La ricerca sulla memoria consapevole della provenienza, inclusi sistemi come MemORAI e Portable Agent Memory, indica una direzione verso memorie collegate alle fonti.
- Il lavoro di sicurezza su prompt injection, avvelenamento della memoria, fughe tra sessioni e sicurezza degli strumenti consapevole della provenienza sostiene confini più rigorosi delle regole.
Il contributo di NanthAI è integrare questi schemi convergenti in un unico contratto del runtime: artefatti persistenti degli strumenti, memorie compatte, provenienza, titolarità dei partecipanti, assemblaggio del grafo consapevole dei rami, decisioni di policy e separazione tra trascrizione e contesto.
Il punto è l’integrazione. Trasforma una raccolta di tecniche utili in un modello rigoroso di runtime per agenti con uso intenso di strumenti.
6.1 Ciò che sembra consolidato
Diverse idee sono già consolidate o quasi: memoria a breve e lungo termine, compattazione del vecchio contesto, uso dei risultati degli strumenti nei turni successivi, salvataggio dello stato dell’agente in punti di ripristino, trattamento dei contenuti recuperati, degli strumenti e degli utenti come potenzialmente non affidabili, gestione esplicita del contesto del modello anziché sola scrittura dei prompt e archiviazione di log per debug e osservabilità.
6.2 Ciò che sembra emergente
Altre idee sono visibili nella letteratura e nei framework più solidi, ma non sono consolidate: memoria degli agenti consapevole della provenienza, rilevamento della memoria obsoleta, gestione di contraddizione e sostituzione, oggetti di memoria portabili, reinserimento di artefatti grezzi da memorie compatte, archivi di stato gestiti dall’applicazione per i vincoli di mancata conservazione presso il provider, assemblaggio del contesto governato da policy e memoria come superficie di attacco.
L’architettura è allineata a questa direzione, ma dà a queste idee un contratto concreto nel runtime di un prodotto.
6.3 Ciò che sembra poco documentato
Le idee più interessanti sono più circoscritte: ContextAssembly come record persistente esplicito, PolicyDecision collegata a ogni generazione, ToolArtifact grezzo persistente separato dalla ToolMemory compatta, stato privato del runtime per partecipante nella chat multimodello, artefatti dei sottoagenti figli privati fino alla promozione, assemblaggio del contesto consapevole dei rami sull’ascendenza della conversazione, semantica di promozione tra osservazione e memoria e cognizione del runtime separata dalla trascrizione dell’utente.
È qui che penso l’architettura sia più utile. Non perché ogni campo sia sorprendente da solo. Perché la combinazione dà al runtime un vocabolario per decisioni che altrimenti restano implicite.
6.4 Precedenti più vicini
Il precedente più vicino tra i framework è LangGraph: stato a grafo, thread, punti di ripristino, riproposizione, navigazione nel tempo e modelli di esecuzione durevole sono fortemente allineati alla direzione del runtime. La differenza è l’ambito. L’architettura non è solo esecuzione a grafo. Rende artefatti degli strumenti, memorie compatte, visibilità dei partecipanti, ascendenza dei rami, assemblaggi del contesto e decisioni di policy record espliciti.
Portable Agent Memory e MemORAI sono vicini sul tema della provenienza della memoria. Sostengono l’idea che le memorie debbano portare collegamenti alle fonti e metadati di integrità. L’architettura applica questa logica agli artefatti degli strumenti e al contesto della generazione, non solo agli oggetti di memoria portabili.
Il lavoro sull’event sourcing è vicino sui temi di audit e riproposizione. Sostiene cronologie di eventi con sole aggiunte in coda ed esecuzione ricostruibile. L’architettura richiede quella cronologia temporale, ma anche relazioni a grafo tra rami, partecipanti, artefatti, memorie e regole.
ARGUS e il lavoro correlato sulla sicurezza consapevole della provenienza sono vicini sul lato della sicurezza. Trattano le decisioni degli strumenti come influenzate dal contesto precedente e usano la provenienza per ragionare sulle azioni non sicure. L’architettura generalizza quell’intuizione: la provenienza dovrebbe determinare non solo i controlli di sicurezza, ma anche la normale inclusione nel contesto, il reinserimento dei dati grezzi, la gestione delle contraddizioni e l’audit.
MCP è pertinente perché rende esplicite chiamate agli strumenti e fonti del contesto. Ma MCP è un protocollo di integrazione, non una policy di conservazione, provenienza, ramo, partecipante o assemblaggio del contesto.
6.5 ZDR e stato gestito dall’applicazione
I vincoli di Zero Data Retention e di mancata conservazione da parte del provider rendono più importante la separazione tra trascrizione e contesto.
Se la persistenza presso il provider non è disponibile o desiderabile, il titolare dell’applicazione ha comunque bisogno di record interni di audit, stato di recupero, riferimenti ai file generati, provenienza delle chiamate agli strumenti, decisioni di visibilità dei partecipanti, policy di eliminazione e conservazione e un modo per ricostruire ciò che ha visto il modello.
Questo riporta la titolarità dello stato nel runtime del prodotto. Il provider diventa un punto di esecuzione. L’applicazione diventa responsabile di decidere che cosa conservare, oscurare, omettere e inviare a ogni richiesta.
L’architettura si adatta a questo modello. Non si affida a thread gestiti dal provider come fonte di verità persistente. Il backend conserva il proprio stato a grafo e assembla da quello le richieste al provider.
7. Complessità delle policy e come gestirla
La principale sfida ingegneristica è che l’assemblaggio governato da policy introduce un livello decisionale da progettare, verificare e osservare.
La riproposizione della trascrizione è semplice da comprendere. Se il messaggio è nella finestra, il modello lo vede. Se è stato tagliato, non lo vede.
L’assemblaggio del contesto governato da policy è più potente e questa potenza ha bisogno di protezioni. Il livello delle policy deve prevenire omissioni di prove utili, inclusione di memorie obsolete, fughe di stato privato, occultamento di errori cruciali per i nuovi tentativi, reinserimento eccessivo dei dati grezzi, recupero insufficiente di prove esatte, errori nell’ascendenza dei rami, eccessiva fiducia nei riepiloghi derivati dal modello, latenza eccessiva delle interrogazioni del grafo e verificabilità superficiale.
È questo il compromesso centrale. L’architettura scambia l’eredità accidentale della trascrizione con policy esplicite. È meglio solo se le policy sono verificabili, osservabili e delimitate.
L’architettura è più solida quando i flussi degli strumenti sono lunghi o ricchi di artefatti, le prove grezze contano, privacy o vincoli dei provider contano, rami, sottoagenti o esecuzioni multimodello sono comuni, i fatti obsoleti possono causare veri errori, la verificabilità è preziosa e il costo del contesto conta.
È meno pertinente quando le chat sono brevi, gli strumenti rari, i risultati non richiedono audit, tutto lo stato può essere condiviso in sicurezza, non servono mai prove esatte in seguito o le risorse ingegneristiche non possono sostenere test delle policy e telemetria.
Per un chatbot semplice, la riproposizione della trascrizione può bastare. Per uno spazio di lavoro con agenti che usano intensamente gli strumenti, la complessità esiste già. L’architettura la rende esplicita e verificabile.
8. Rischi e modalità di errore
R1: Errori nelle policy
L’assemblatore può omettere prove necessarie o includere contesto vietato.
Mitigazioni: test deterministici degli scenari, riepiloghi delle omissioni, versionamento delle policy, valutazione prima e dopo e log campionati degli assemblaggi.
R2: Crescita dello spazio di archiviazione
Gli artefatti grezzi possono crescere rapidamente, soprattutto con file, contenuti API, stdout/stderr e risultati generati.
Mitigazioni: classi di conservazione, criteri di ammissibilità alla garbage collection, pulizia all’eliminazione dell’account, riferimenti di archiviazione, hashing e policy di conservazione per il solo audit.
R3: Fughe di dati verso provider e violazioni della privacy
Gli artefatti archiviati possono contenere dati derivati da OAuth, dati Google, dati di documenti, file del runtime o contenuti connessi a segreti.
Mitigazioni: classificazione di privacy, policy di instradamento verso i provider, controlli sul reinserimento dei dati grezzi, riepiloghi con soli metadati e omissione in caso di dubbio.
R4: Falsa sicurezza dalle memorie compatte
I riepiloghi possono essere sbagliati, obsoleti o incompleti.
Mitigazioni: fonte dell’attendibilità, localizzatori di provenienza, classe di freschezza, collegamenti di contraddizione, limiti e percorsi di reinserimento dei dati grezzi.
R5: Memoria obsoleta
Il modello può affidarsi a vecchie osservazioni esterne come verità attuali.
Mitigazioni: observedAt, staleAfter, classe di freschezza, strumenti di riconvalida, indicatori di obsolescenza e policy di omissione.
R6: Contaminazione tra rami
Gli artefatti dei rami fratelli possono sottrarre posto allo stato del ramo attivo.
Mitigazioni: interrogazione dell’ascendenza del ramo attivo, visibilità esplicita della conversazione o condivisa e telemetria delle esclusioni per ramo.
R7: Fughe tra partecipanti
Un modello partecipante può vedere lo stato privato degli strumenti di un altro partecipante.
Mitigazioni: ID del partecipante titolare, ID dell’esecuzione del modello titolare, ambito di visibilità, policy di isolamento del runtime, elenchi di condivisione e decisioni di promozione.
R8: Aumento della latenza
Interrogazioni del grafo, correzione della provenienza e reinserimento dall’archivio possono diventare costosi.
Mitigazioni: insiemi delimitati di candidati, reinserimento in due passaggi dopo la selezione secondo le policy, telemetria dei tempi, limiti ai tentativi di correzione e controlli sulla latenza.
R9: Affermazioni eccessive sulla durevolezza
Artefatti e punti di ripristino aiutano con recupero e audit, ma non equivalgono a un’esecuzione durevole distribuita completa.
Mitigazioni: linguaggio preciso, idempotenza dove necessaria, punti di ripristino per la continuazione, contratti per i nuovi tentativi e orchestrazione esterna per garanzie più forti sui flussi di lavoro.
R10: Possibilità di diagnosticare le omissioni
Il modello può fallire perché uno stato pertinente è stato omesso, non perché sia stato incluso uno stato errato.
Mitigazioni: conteggi dei motivi di esclusione, tracce dettagliate deterministiche, telemetria delle esclusioni per ramo, log campionati degli assemblaggi e interrogazioni di audit e debug che possano esaminare i candidati oltre ai record selezionati.
R11: Deriva della promozione
La logica dell’estrattore può promuovere troppo nella memoria persistente o troppo poco nella memoria visibile al modello.
Mitigazioni: promotionPolicy esplicita, test dell’estrattore, provenienza dell’attendibilità, policy di declassamento per la privacy e recupero degli artefatti grezzi quando una memoria non è stata promossa.
R12: Abuso del reinserimento dei dati grezzi
Il reinserimento dei dati grezzi può diventare un percorso nascosto attraverso cui contenuti grandi o sensibili entrano nel contesto del provider.
Mitigazioni: selezione in due passaggi, controlli di privacy prima delle letture dall’archivio, budget di byte, controlli sull’instradamento verso i provider e omissione in caso di dubbio per dati OAuth, Google o connessi a segreti.
9. Misurazioni dell’implementazione
Sebbene la validazione completa del comportamento richieda benchmark più ampi, alcune affermazioni possono essere valutate direttamente dall’attuale implementazione di NanthAI:Edge. In particolare, il codice permette di confrontare un contesto del sistema precedente basato sulla riproposizione della trascrizione con un contesto assemblato dal grafo per scenari fissi con uso intenso di strumenti.
Queste misurazioni quantificano il lato dell’economia del contesto dell’argomento: quanto materiale del prompt rivolto al modello si evita sostituendo i vecchi contenuti degli strumenti con memorie compatte, contesto selezionato dal grafo, filtri di privacy e titolarità e stato grezzo irrisolto protetto.
La struttura del confronto era semplice. Il passaggio del sistema precedente usava la riproposizione della trascrizione e dei messaggi degli strumenti, con il rumore dei contenuti grezzi. Il passaggio assemblato usava memoria compatta degli strumenti, contesto selezionato dal grafo, filtri di privacy e titolarità e stato grezzo irrisolto protetto degli strumenti.
Sono misurazioni dell’implementazione, non un benchmark pubblico né un’affermazione di miglioramento universale nella riuscita dei compiti.
9.1 Riduzione del contesto del prompt
Le differenze nei token del prompt erano fortemente negative negli scenari comparativi dal vivo verificati.
- Il contesto del selettore di documenti differito è sceso da 1020 a 142 token, una riduzione dell’86,1%.
- La generazione di file con più strumenti è scesa da 1905 a 221 token, una riduzione dell’88,4%.
- La memoria obsoleta delle app collegate è scesa da 1051 a 145 token, una riduzione dell’86,2%.
- Lo stato del runtime con più skill è sceso da 1008 a 179 token, una riduzione dell’82,2%.
- La visibilità dei partecipanti è scesa da 961 a 161 token, una riduzione dell’83,2%.
- Contraddizione e sostituzione sono scese da 1986 a 197 token, una riduzione del 90,1%.
Questo sostiene la prima affermazione dell’architettura sull’economia del contesto: i vecchi cicli riusciti degli strumenti non devono restare nel percorso di riproposizione come bagaglio grezzo della trascrizione. Possono diventare memorie compatte collegate alla provenienza, mentre le prove grezze restano recuperabili fuori dal prompt.
9.2 Conservazione del recupero e della provenienza
La riduzione dei token è utile solo se non si perde stato importante. Gli scenari verificati includevano quindi casi di recupero, provenienza, privacy, rami e confini tra partecipanti: stato del selettore di documenti differito, file generati, memoria obsoleta delle app collegate, stato del runtime con più skill, visibilità dei partecipanti, contraddizione e sostituzione, correzione della provenienza interrotta, reinserimento esatto del CSV grezzo, isolamento dei rami, errori cruciali per i nuovi tentativi, omissione dei dati Google per privacy, stato di continuazione dei sottoagenti, attribuzione nella discussione autonoma, acquisizione degli artefatti dei sottoagenti figli, metadati di ripresa del padre, compatibilità delle attività pianificate e compatibilità degli invii nei rami.
Il percorso assemblato ha migliorato il comportamento nei punti in cui la riproposizione della trascrizione era strutturalmente debole. Ha tenuto nascosti gli appunti privati dei partecipanti, corretto la provenienza anziché inventare ID sostitutivi, selezionato lo stato del ramo attivo, conservato gli errori cruciali per i nuovi tentativi, omesso i contenuti grezzi Google quando la policy lo richiedeva e recuperato gli artefatti grezzi esatti quando la policy lo consentiva.
9.3 Copertura delle modalità del runtime
La stessa architettura deve funzionare attraverso le modalità di generazione, non solo nel semplice ciclo della chat. Un normale turno di chat, un turno multimodello, una discussione autonoma, l’esecuzione di un sottoagente figlio, una ripresa del padre, un’attività pianificata e un invio in un ramo hanno tutti confini di contesto diversi.
La lezione importante dell’implementazione è che l’assemblaggio del grafo deve essere verificato su quei confini. Lo stato del sottoagente figlio dovrebbe restare privato fino alla promozione. La ripresa del padre dovrebbe usare un punto di ripristino deterministico. La discussione autonoma dovrebbe conservare etichette degli interlocutori e istruzioni del moderatore. Gli invii nei rami dovrebbero ereditare l’ascendenza attiva senza trascinare artefatti dei rami fratelli.
È qui che il modello a grafo conta di più. Il grafo non riduce solo i token: dà al runtime un vocabolario per decidere quale stato appartiene a quale modalità di generazione.
9.4 Che cosa ha mostrato la validazione interna
La validazione interna aveva due livelli.
- Il livello deterministico verificava che le policy di assemblaggio conservassero lo stato non negoziabile del runtime. Gli artefatti grezzi degli strumenti venivano resi persistenti prima del troncamento a livello di messaggio. Lo stato degli strumenti irrisolto, differito, fallito e cruciale per i nuovi tentativi restava visibile al modello. Lo stato privato dei partecipanti non veniva reso visibile ai partecipanti fratelli. Le memorie obsolete venivano contrassegnate o omesse anziché trattate silenziosamente come verità attuali. Le memorie sostituite venivano omesse mentre i rimpiazzi correnti restavano selezionabili. La provenienza interrotta veniva corretta o contrassegnata come obsoleta senza inventare ID sostitutivi. Artefatti e memorie locali al ramo venivano selezionati dall’ascendenza attiva anziché dai rami fratelli recenti. I contenuti grezzi limitati per privacy venivano omessi, mentre riepiloghi sicuri e suggerimenti di riconvalida restavano disponibili.
- Il livello di confronto dal vivo rappresentava poi gli stessi scenari in due forme: riproposizione della trascrizione del sistema precedente e contesto assemblato dal grafo. Il percorso assemblato conservava i fatti necessari per recupero e provenienza riducendo nettamente il contenuto esposto nel prompt.
Negli scenari dal vivo misurati sopra, le riduzioni andavano dall’82,2% al 90,1%.
9.5 Interpretazione
Queste misurazioni convalidano la premessa di riduzione del contesto negli scenari verificati dell’implementazione. Mostrano che il percorso assemblato di NanthAI:Edge può ridurre sensibilmente la riproposizione predefinita dei contenuti storici degli strumenti, l’esposizione dello stato provvisorio privato dei partecipanti, lo stato obsoleto delle app collegate trattato come verità attuale, la contaminazione da percorsi di rami fratelli, la perdita dello stato degli strumenti cruciale per i nuovi tentativi e la provenienza inventata quando i localizzatori si interrompono.
Le misurazioni rispondono a una domanda:
L’assemblaggio del contesto governato da policy riduce il contesto esposto al modello conservando lo stato importante di recupero e provenienza negli scenari verificati?
La risposta è sì.
10. Discussione
Lo schema che ricaverei dall’architettura è questo: mantenere la trascrizione come cronologia per le persone, archiviare gli artefatti grezzi degli strumenti prima del troncamento, ricavare memorie compatte dagli artefatti anziché da riepiloghi scollegati, conservare la provenienza fino alle prove grezze, tenere traccia di freschezza e sostituzione, delimitare lo stato del runtime per partecipante e ramo, assemblare il contesto del modello attraverso policy anziché in base all’età dei messaggi, registrare abbastanza della decisione di assemblaggio per spiegare che cosa è successo, reinserire gli artefatti grezzi solo quando servono prove esatte ed è consentito e tenere la cognizione del runtime fuori dall’esperienza utente, a meno che l’utente non chieda una vista di audit.
È questa l’architettura effettiva.
Per i team di implementazione, le regole pratiche sono altrettanto dirette. Stabilire un’unica policy di assemblaggio immutabile prima di selezionare i candidati dal grafo. Recuperare l’ascendenza del ramo attivo prima di riempire gli spazi con candidati condivisi o con ambito di conversazione. Reinserire i contenuti grezzi conservati nell’archivio solo dopo che le policy di privacy e budget li hanno selezionati. Trattare lo stato dei sottoagenti figli come privato o riservato all’audit fino alla promozione esplicita. Registrare perché i record sono stati omessi, non solo ciò che è stato incluso.
Non “memoria a lungo termine”. Non “GraphRAG”. Non “finestre di contesto più grandi”.
Un runtime governato da policy che decide che cosa merita di entrare nella chiamata successiva al modello.
Questo ha diverse implicazioni:
- L’assemblaggio del contesto diventa una primitiva del runtime. Dovrebbe essere verificato e versionato come qualsiasi altro contratto critico del backend.
- La memoria diventa verificabile. Una memoria senza metadati di provenienza, freschezza e attendibilità non basta per flussi di lavoro impegnativi con gli strumenti.
- I risultati degli strumenti smettono di essere bagaglio della trascrizione. Gli artefatti grezzi possono essere conservati per recupero e audit senza essere riproposti per sempre.
- I confini tra partecipanti diventano espliciti. I sistemi multimodello e con sottoagenti devono distinguere i risultati visibili dallo stato privato del runtime.
- La ramificazione diventa strutturale. Un ramo non è solo navigazione dell’interfaccia: vincola quali artefatti e memorie dovrebbero influenzare la chiamata successiva al modello.
- L’audit passa dai log alle spiegazioni. L’obiettivo non è solo archiviare eventi, ma ricostruire perché un modello ha visto un particolare contesto.
È questa la direzione che stiamo seguendo in NanthAI:Edge: la cronologia dell’agente dovrebbe essere persistente senza essere riproposta ciecamente e il contesto del modello dovrebbe essere assemblato dallo stato del grafo governato da policy anziché ereditato dall’ordine dei messaggi.
11. Conclusione
Il settore sta passando dai chatbot agli agenti che usano strumenti. Questo cambia il problema dello stato. Un chatbot può spesso cavarsela con la riproposizione della trascrizione.
Un agente che scrive file, legge documenti, richiama API, cerca sul web, avvia sottoagenti, esegue attività pianificate, ramifica conversazioni e confronta modelli non può trattare la trascrizione come l’intero runtime.
La trascrizione è una proiezione. È necessaria, ma incompleta. Il modello ha bisogno di contesto. L’utente ha bisogno di cronologia.
Il sistema ha bisogno di prove. Chi esegue l’audit ha bisogno di provenienza. Il ciclo dei nuovi tentativi ha bisogno di stato di recupero. Il livello della privacy ha bisogno di regole.
Il prodotto ha bisogno che tutto questo coesista senza trasformare ogni richiesta al modello in una discarica di vecchi contenuti degli strumenti.
È questo che fa l’architettura: dà alla cronologia dell’agente una forma persistente nel runtime senza trasformare ogni futura richiesta al modello in una riproposizione di vecchi contenuti degli strumenti.
Le capacità di un agente non dovrebbero crescere linearmente con la dimensione del prompt.
La cronologia di un agente non dovrebbe crescere linearmente con la riproposizione della trascrizione.
Il livello successivo è l’assemblaggio del contesto governato da policy.
Riferimenti
- Anthropic. Effective context engineering for AI agents. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Haystack. Context engineering. https://haystack.deepset.ai/blog/context-engineering
- Atlan. How to structure context for LLM applications. https://atlan.com/know/how-to-structure-context-for-llm-applications/
- LangGraph. Persistence. https://docs.langchain.com/oss/python/langgraph/persistence
- LangGraph. Durable execution. https://docs.langchain.com/oss/python/langgraph/durable-execution
- LangGraph. Add memory. https://docs.langchain.com/oss/python/langgraph/add-memory
- Databricks. Memory scaling for AI agents. https://www.databricks.com/blog/memory-scaling-ai-agents
- Google Cloud. What is Model Context Protocol? https://cloud.google.com/discover/what-is-model-context-protocol
- Portable Agent Memory. https://arxiv.org/html/2605.11032v1
- MemORAI. https://arxiv.org/html/2605.01386v1
- ESAA: Event Sourcing for Autonomous Agents in LLM-Based Systems. https://arxiv.org/abs/2602.23193
- Audit Trails for Accountability in Large Language Models. https://arxiv.org/html/2601.20727v1
- STALE. https://arxiv.org/html/2605.06527v1
- Evaluating the Long-Term Memory of Large Language Models. https://aclanthology.org/2025.findings-acl.1014/
- OWASP Agent Memory Guard. https://owasp.org/www-project-agent-memory-guard/
- OWASP. LLM Prompt Injection Prevention Cheat Sheet. https://cheatsheetseries.owasp.org/cheatsheets/LLM_Prompt_Injection_Prevention_Cheat_Sheet.html
- ARGUS. https://arxiv.org/html/2605.11053v1
- Beyond RAG for Agent Memory. https://arxiv.org/html/2602.02007v2
- LongMemEval-V2. https://arxiv.org/html/2605.12493v1
- Agentic Memory. https://arxiv.org/html/2601.01885v2
- Governing Evolving Memory in LLM Agents. https://arxiv.org/html/2603.11768v1
- Giskard. Cross-session leak: when your AI assistant becomes a data breach. https://www.giskard.ai/knowledge/cross-session-leak-when-your-ai-assistant-becomes-a-data-breach
- Unit42. Indirect prompt injection poisons AI long-term memory. https://unit42.paloaltonetworks.com/indirect-prompt-injection-poisons-ai-longterm-memory/
- Diagrid. Checkpoints are not durable execution. https://www.diagrid.io/blog/checkpoints-are-not-durable-execution-why-langgraph-crewai-google-adk-and-others-fall-short-for-production-agent-workflows
- Zero Data Retention in LLM-based Enterprise AI Assistants. https://arxiv.org/abs/2510.11558
Pubblicato anche su LinkedIn.