Une étude de cas technique de NanthAI:Edge.
La plupart des agents IA utilisant des outils font croître l’historique de la mauvaise manière : chaque appel d’outil, résultat, fichier généré, nouvelle tentative, résumé, erreur et reprise repasse par l’historique visible du chat jusqu’à être tronqué, compacté ou perdu.
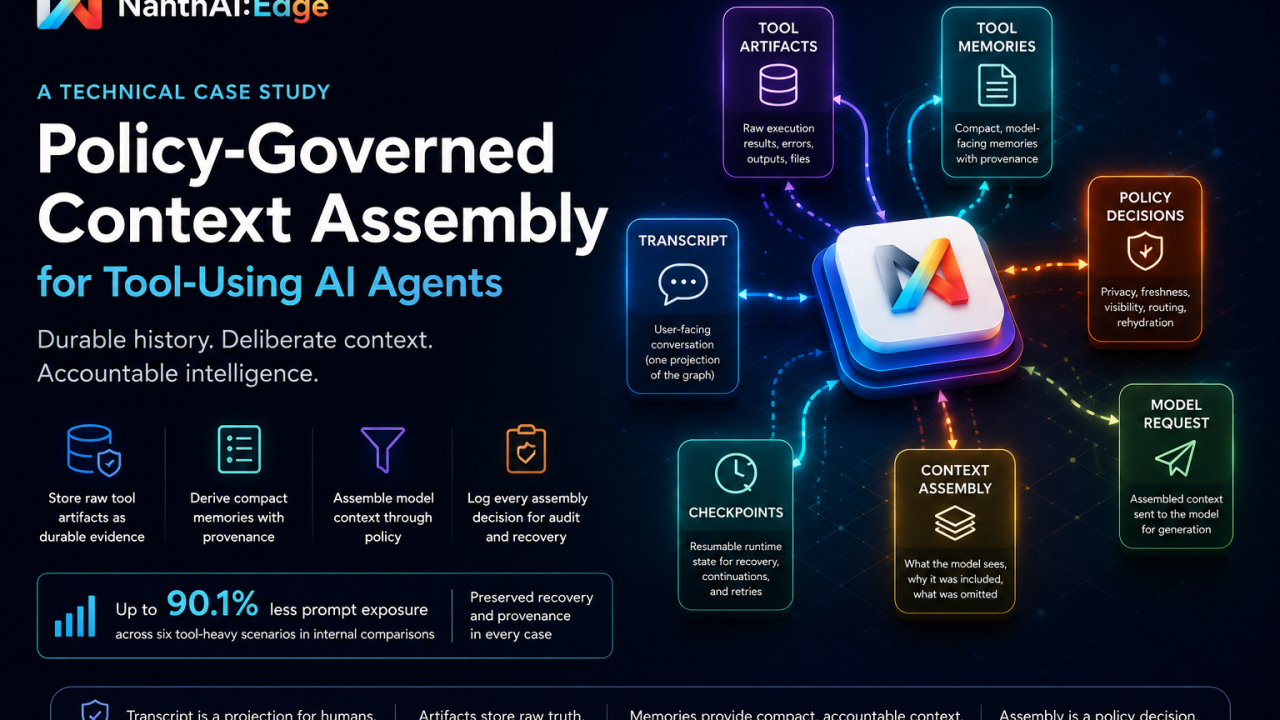
Dans NanthAI:Edge, ce n’est pas qu’une théorie. Dans des tests comparatifs internes, le contexte assemblé à partir du graphe a réduit le contenu exposé au prompt de 1 905 à 221 tokens pour un processus de génération de fichiers utilisant plusieurs outils, de 1 986 à 197 tokens pour un processus de contradiction/remplacement et de 1 020 à 142 tokens pour un processus de sélecteur de documents différé. Cela ne prouve pas une meilleure réussite des tâches, mais prouve que la surface de contexte présentée au modèle peut être sensiblement réduite tout en préservant l’état de récupération et de provenance.
La manière la plus simple de construire un agent IA reste d’ajouter toujours plus de choses au chat.
L’utilisateur pose une question. Le modèle appelle un outil. L’outil renvoie un résultat. Le résultat est inséré dans la conversation. Le modèle appelle un autre outil. Un autre résultat est ajouté. L’agent écrit un fichier, rencontre une erreur, réessaie, résume, crée une branche, reprend plus tard, lance peut-être un sous-agent, et l’historique continue de grandir.
Au début, cela paraît naturel. L’historique est là. Il est ordonné. Il est lisible. Il ressemble à une mémoire. Mais pour les agents utilisant des outils, l’historique est un piège.
L’historique de conversation est ce que l’utilisateur doit pouvoir lire. Ce n’est pas la même chose que ce que le modèle doit voir ensuite. Dès qu’un agent exécute des outils, manipule des fichiers, appelle des API, travaille sur plusieurs branches, compare des modèles ou porte un état privé du runtime, le journal visible du chat devient une mauvaise source de vérité. Il mélange expérience produit, éléments probants, mémoire, état de nouvelle tentative, frontières de confidentialité, observations périmées et traces d’audit dans un flux chronologique unique.
La meilleure approche consiste à traiter l’historique comme une projection d’un graphe de runtime plus riche. Les sorties brutes des outils sont stockées comme des artefacts persistants. Des mémoires compactes en sont dérivées. La provenance relie la mémoire aux éléments probants. Branches, participants, exécutions de modèles, appels d’outils, points de reprise et décisions de politique sont des entités distinctes. Chaque requête au modèle reçoit un assemblage du contexte de ce graphe gouverné par des politiques, et non une réinjection aveugle des anciens messages.
C’est l’architecture que défend cet article : ni « plus de mémoire », ni « utilisez simplement une plus grande fenêtre de contexte », ni « GraphRAG pour tout ». L’idée est plus précise : l’historique d’un agent doit être persistant sans être réinjecté indéfiniment, et le contexte du modèle doit être assemblé délibérément plutôt qu’hérité de l’ordre des messages.
Résumé
Les agents fondés sur de grands modèles de langage (LLM) utilisant des outils font face à une tension structurelle entre historique conversationnel, état du runtime, éléments probants issus des outils, mémoire, confidentialité et économie de contexte. Un schéma courant traite l’historique visible à la fois comme trace destinée à l’utilisateur et comme contexte destiné au modèle : les anciens messages, appels et résultats d’outils, résumés, erreurs et artefacts générés sont réinjectés dans les requêtes ultérieures jusqu’à être tronqués, compactés ou perdus. Cette approche est simple, mais elle couple l’expérience utilisateur à la cognition du runtime et fait de la sélection du contexte un sous-produit accidentel de l’ordre des messages.
Cet article développe le modèle d’assemblage du contexte gouverné par des politiques, où l’historique est traité comme une projection d’un graphe de runtime plus riche plutôt que comme la source de vérité du modèle. Le runtime stocke les artefacts bruts des outils séparément des mémoires compactes, préserve la provenance de la mémoire dérivée jusqu’aux éléments probants, suit l’appartenance aux participants et aux branches, et consigne les décisions d’assemblage sous des versions explicites de politiques.
L’article situe ce modèle par rapport aux travaux sur l’ingénierie du contexte, la mémoire des agents, l’état en graphe, l’event sourcing, la mémoire tenant compte de sa provenance, les défaillances de mémoire périmée, l’injection de prompt et les pistes d’audit des agents. Il utilise ensuite NanthAI:Edge comme exemple d’implémentation.
L’article soutient que la contribution la plus forte est le contrat intégré du runtime : artefacts d’outils persistants, mémoires d’outils compactes, assemblages de contexte comme entités à part entière, décisions de politique, appartenance de l’état du runtime limitée au participant, sélection dans le graphe tenant compte des branches, politiques de fraîcheur et de remplacement, rechargement des artefacts bruts et frontière délibérée entre cognition du runtime et historique de conversation visible par l’utilisateur.
La contribution comprend un cadre conceptuel de séparation entre historique de conversation et contexte dans les agents utilisant des outils, une analyse de l’architecture d’artefacts persistants et d’assemblage du contexte de NanthAI:Edge orientée vers la mise en œuvre, une comparaison avec les travaux antérieurs en ingénierie du contexte et en runtimes à graphe, un catalogue de risques de la couche de politiques et des mesures tirées de scénarios comparatifs internes.
1. Introduction
Dans le précédent article NanthAI, j’ai décrit l’utilisation des compétences comme portes d’accès aux outils. Le problème était l’encombrement des capacités. À mesure qu’un agent acquiert des méthodes de travail, des intégrations et des consignes métier, l’approche naïve consiste à ajouter toujours plus de texte au prompt et de schémas d’outils à chaque requête. NanthAI:Edge l’évite en exposant d’abord un catalogue compact de compétences, puis en chargeant les consignes complètes et en étendant le registre d’outils exécutables uniquement lorsqu’une tâche le justifie. Cela résout une moitié du problème du contexte. L’autre apparaît après l’exécution des outils.
Les appels d’outils produisent des résultats de recherche, des fichiers, des citations, des charges utiles d’API, des données obtenues via OAuth, des erreurs, des résultats partiels, un état de nouvelle tentative, des artefacts générés, un état de brouillon privé, des observations externes périmées, un état de sous-agent et des points de reprise. Si le runtime continue de tout réinjecter par l’historique visible du chat, le contexte du modèle devient coûteux, bruité et parfois erroné.
Cela crée deux problèmes liés.
- L’encombrement de l’historique apparaît lorsque les anciens appels et résultats d’outils, artefacts générés, résumés, nouvelles tentatives et états opérationnels s’accumulent dans l’historique et sont renvoyés au modèle à répétition.
- L’ambiguïté de l’état du runtime apparaît lorsque l’historique doit servir simultanément de trace pour l’utilisateur, de mémoire du modèle, de piste d’audit, d’état de nouvelle tentative, de frontière de confidentialité et de stockage d’éléments probants issus des outils.
Les deux coûtent cher. Ils consomment des tokens d’entrée, augmentent la latence et le coût, compliquent le routage des fournisseurs et rendent plus difficile de déterminer ce que le modèle savait réellement lorsqu’il a généré une réponse.
Surtout, ils peuvent dégrader l’exactitude. Un modèle peut prendre une sortie d’outil périmée pour une vérité actuelle. Une erreur indispensable à une nouvelle tentative peut disparaître dans un résumé. Une branche peut hériter du fichier généré d’une branche sœur. Le bloc-notes privé d’un participant peut se retrouver dans le contexte d’un autre modèle. Un résumé compact peut perdre la valeur exacte nécessaire plus tard pour un audit ou un rechargement.
Cet article examine une autre approche structurée : l’assemblage du contexte gouverné par des politiques à partir d’un graphe de runtime.
Le principe est simple : traiter l’historique de conversation comme la vue destinée à l’humain, stocker les artefacts bruts des outils séparément des messages, en dériver des mémoires compactes, préserver la provenance de la mémoire jusqu’aux éléments probants bruts, assembler chaque requête au modèle à partir de l’état du graphe selon une politique explicite et consigner assez de détails pour expliquer ce que le modèle a vu et pourquoi.
Dans NanthAI:Edge, l’interface publique du chat n’a pas eu besoin de changer pour que l’architecture fonctionne. Les utilisateurs voient toujours les messages, les cartes d’outils, les fichiers générés, les citations, les branches, les nouvelles tentatives, les reprises et les réponses des modèles. En arrière-plan, le runtime sépare historique de conversation, artefacts, mémoires, décisions de politique et assemblages du contexte.
La même frontière s’applique entre les modes du runtime. Un tour de chat normal, une comparaison multi-modèles, une discussion autonome, une exécution enfant de sous-agent, la reprise d’un parent après des sous-agents, une tâche planifiée et un envoi dans une branche n’ont pas tous le même contrat de contexte. Une discussion autonome de type débat doit préserver les noms des intervenants et les directives du modérateur. Un sous-agent enfant ne doit pas transmettre par défaut l’état brut de son espace de travail à son parent. La reprise du parent doit respecter son point de reprise déterministe plutôt que d’interroger aveuglément l’historique. L’assemblage du contexte doit tenir compte du mode du runtime.
L’article apporte un vocabulaire pour séparer historique de conversation, contexte, artefact, mémoire et politique ; une architecture concrète d’artefacts d’outils persistants et de mémoires compactes ; une analyse de l’état du runtime limité au participant dans les processus multi-modèles et à sous-agents ; une comparaison avec les travaux antérieurs ; et une interprétation des mesures de l’implémentation et de leurs limites.
TRANSCRIPT PROJECTION (User-Facing UI)
Ordered messages · Tool cards (truncated) · Generated files · Citations · Branches · Model responses
One projection of the same runtime graph
RUNTIME GRAPH (Durable State)
- MESSAGE (User/Assistant): User prompts; Assistant prose; Tool call / result messages (truncated for UI); Visible transcript
- MODEL RUN (Generation Attempt): Provider; Model & parameters; Participant; Message / Job ownership; Runtime mode
- TOOL CALL (Requested): Tool name; Arguments; Call ID; Status (requested / pending / failed); Model run linkage
- TOOL ARTIFACT (Raw Execution): Full arguments; Raw result or error; Status, timing; Tool version; Privacy classification; Storage handles; Hashes / byte size
- TOOL MEMORY (Compact, Model-Facing): Summary / structured data; Source artifact ID(s); Confidence + source; Freshness & stale-after; Provenance locators; Contradictions / supersession; Revalidation tools
- CONTEXT ASSEMBLY (Policy-Governed): Policy version; Assembler version; Selected memories; Rehydrated artifacts; Legacy vs assembled tokens; Omission summaries; Timing & telemetry
- MODEL REQUEST (Provider Prompt): System / instructions; Selected messages; Selected memories; Rehydrated raw (if any); Skill state; Recovery state; Provider + settings
KEY RELATIONSHIPS
Primary execution flow →
Artifacts produced by calls
Memories derived from artifacts
Policy selection & assembly
UI projection (readable view)
WHAT HAPPENS WHERE
ToolCall → ToolArtifact: Execute the tool and capture raw evidence.
ToolArtifact → ToolMemory: Extract, summarize, classify, link provenance.
ToolMemory → ContextAssembly: Policy decides what to include.
ContextAssembly → Model Request: Serialize the selected context.
Transcript Projection: Human-readable view, not the source of truth.
POLICY CONSIDERS
Ownership (participant / model run / branch)
Visibility (private / branch / conversation / audit)
Privacy & provider-routing constraints
Freshness, staleness, revalidation needs
Promotion, contradiction, supersession
Recovery state & retry protection
Context budget & raw rehydration bounds
Retention, deletion, and safety rules
OUTCOME
The model sees a deliberate, policy-governed context assembled from durable runtime state — not a blind replay of the transcript.
Smaller context. Better signal. Preserved evidence. Clear auditability.
Core Principle: Transcript is a projection for humans. Artifacts are raw truth. Memories provide compact, accountable context. Assembly is a policy decision.
2. Contexte : ingénierie du contexte, mémoire et état des outils
2.1 Ingénierie du contexte
L’ingénierie du contexte consiste à décider quelles informations entrent dans le contexte du modèle. Elle dépasse la rédaction des prompts. Elle comprend les consignes système, l’historique de conversation, les éléments probants retrouvés, les sorties d’outils, la mémoire, les politiques, l’état de la tâche et la mise en forme.
Les recommandations modernes d’ingénierie du contexte soutiennent l’idée que le contexte du modèle doit être assemblé explicitement plutôt que traité comme un historique brut. Anthropic décrit l’ingénierie du contexte comme le travail de gestion de l’information fournie aux agents. Haystack et Atlan décrivent aussi le contexte comme des zones structurées : consignes, historique, récupération, sorties d’outils et mémoire.
Cette distinction compte parce que les classes de contexte ont des durées de vie et des propriétés de confiance différentes. Un message utilisateur, un identifiant de fichier généré, une charge utile OAuth, un résultat de recherche périmé, une erreur d’outil qui appelle une nouvelle tentative et une citation de document ne doivent pas être élagués, résumés, conservés ou exposés selon la même règle.
L’historique est particulièrement trompeur parce qu’il paraît complet. Il contient une trace chronologique du fait que quelque chose s’est produit. Il ne contient pas nécessairement l’élément brut qui s’est produit, la politique qui l’a autorisé, la branche à laquelle il appartenait, le participant qui l’a vu ou la raison pour laquelle les tours suivants devraient encore lui faire confiance. Pour un simple produit de chat, la chronologie peut suffire comme approximation du contexte. Pour les agents utilisant des outils, elle n’est qu’un axe parmi d’autres.
C’est pourquoi l’architecture traite le contexte comme une projection assemblée. Cette projection peut inclure des tours récents, des mémoires d’outils sélectionnées, un état d’outil non résolu, l’état des compétences chargées, des contraintes de fournisseur et de confidentialité, et des artefacts bruts sélectionnés. Elle peut aussi omettre les enregistrements périmés, privés, remplacés, non admissibles dans la branche, au-delà du budget ou inadaptés au fournisseur sélectionné du point de vue de la sécurité. L’inclusion est une décision, pas un hasard lié à l’âge du message.
2.2 Mémoire des agents
La recherche sur la mémoire des agents distingue généralement mémoire de travail, mémoire épisodique, mémoire sémantique, mémoire procédurale et mémoire à long terme. Des frameworks comme LangGraph distinguent mémoire à court et à long terme. Les synthèses sur la mémoire des agents LLM soulignent que le domaine reste fragmenté : aucun schéma commun entre frameworks ne fait consensus pour la représentation de la mémoire, la provenance, la fraîcheur, la contradiction ou la conservation.
Cette fragmentation est importante. « Mémoire » sert souvent de terme général pour des choses très différentes : préférences utilisateur, faits extraits de conversations antérieures, résumés d’anciens dialogues, observations d’outils, références de fichiers générés, documents récupérés, plans de tâche, traces d’exécution et références de provenance.
L’architecture sépare la mémoire utilisateur de la mémoire d’outil. La première gère la personnalisation. La seconde gère les éléments probants du runtime dérivés des artefacts d’outils.
Cette séparation dépasse une simple taxonomie produit. Elle empêche qu’une observation du runtime devienne un fait utilisateur durable simplement parce qu’elle est apparue dans un chat. Si un outil lit un fil Slack, cela peut créer une mémoire utile et délimitée de l’état du fil. Cela ne doit pas devenir une préférence utilisateur permanente. Si un outil de génération de documents crée un fichier, sa référence peut être un état opérationnel persistant. Ce n’est pas le même type de mémoire que « l’utilisateur préfère les réponses concises ».
La mémoire d’outil a donc besoin de champs dont la mémoire ordinaire de personnalisation n’a souvent pas besoin : identifiants d’artefacts, noms des outils sources, classe de confidentialité, classe de fraîcheur, localisateurs de provenance, source de la confiance, tentatives de réparation, liens de contradiction, liens de remplacement et politique de promotion. Dans cette architecture, la mémoire n’est pas « ce que le modèle pourrait vouloir retenir ». C’est une représentation compacte, gouvernée par des politiques, d’éléments probants dont le runtime peut rendre compte.
2.3 Les traces d’outils comme état
Les agents utilisant des outils créent de l’état à chaque appel. Les arguments, le résultat, l’erreur, les temps, le fournisseur, le runtime, l’état des compétences actives et le contexte d’appartenance peuvent tous compter plus tard.
L’industrie et la recherche le reconnaissent de plus en plus. Databricks présente les trajectoires d’appels d’outils et les résultats d’exécution comme un état d’agent. LangGraph conserve l’état du graphe et les points de reprise. MCP rend les outils et les sources de contexte explicites et structurellement journalisables. Les travaux sur l’event sourcing soutiennent que les agents autonomes ont besoin d’enregistrements par ajout uniquement, permettant reconstruction et audit.
La déduction essentielle est que les résultats d’outils ne devraient pas exister seulement comme messages de l’historique. Les messages sont utiles à l’affichage. Ils constituent une couche de stockage médiocre pour les éléments probants bruts.
Un message de l’historique est généralement optimisé pour la lisibilité humaine et la compatibilité des clients. Il peut être tronqué, expurgé, résumé, réordonné pour la présentation ou supprimé par compaction. C’est exactement ce dont une interface produit a besoin. Ce n’est pas ce dont un système de récupération a besoin lorsque l’utilisateur demande plus tard « utilisez exactement le CSV de tout à l’heure », ou lorsqu’un audit demande pourquoi un identifiant de fichier a été cité.
L’architecture capture l’artefact avant cette transformation orientée vers l’affichage. Le message peut toujours montrer une carte d’outil claire ou un résultat compact. Le stockage d’artefacts conserve les arguments bruts, le résultat brut ou l’erreur, les empreintes, les tailles en octets, les références de stockage, le propriétaire dans le runtime, la classification de confidentialité et les métadonnées de version d’outil nécessaires à la récupération et à l’audit.
2.4 Mémoire périmée et contradiction
La mémoire persistante introduit un mode de défaillance : l’agent peut continuer de s’appuyer sur des informations périmées, contredites ou remplacées. Des tests comme STALE et des études comme LOCCO illustrent que la mémoire à long terme n’est pas automatiquement fiable. Retenir davantage peut dégrader le système si d’anciens faits sont traités comme des vérités actuelles.
Cela justifie une politique explicite de fraîcheur et de remplacement. Un résumé de fil Slack, un instantané de CRM, un résultat de disponibilité de calendrier, une référence de fichier généré et une version immuable de document ne doivent pas vieillir de la même façon.
Le problème de la mémoire périmée ne tient pas seulement au fait que d’anciens faits deviennent faux. Le modèle les reçoit souvent sans marqueur d’expiration visible. Un résultat de disponibilité vieux de six semaines et un identifiant de version immuable de document peuvent tous deux apparaître comme un « contexte antérieur » si le runtime ne fait que réinjecter des messages. L’architecture explicite cette différence avec des classes de fraîcheur et des métadonnées de date de péremption.
La contradiction est le mode de défaillance associé. Deux mémoires peuvent provenir d’artefacts réels et néanmoins se contredire parce qu’elles viennent de versions de document, de branches, de fournisseurs ou de méthodes d’extraction différents. Le système ne devrait pas fusionner ces enregistrements en un résumé où la dernière écriture l’emporte, sauf si une politique dispose d’assez d’informations de provenance et de confiance pour justifier cette résolution.
2.5 Provenance et audit
La mémoire tenant compte de sa provenance est un thème émergent. MemORAI relie les mémoires en graphe aux tours sources. Portable Agent Memory propose des objets mémoire à provenance vérifiée. ARGUS utilise des graphes de provenance d’influence pour raisonner sur les appels d’outils dangereux. Les travaux sur les pistes d’audit et l’event sourcing soutiennent aussi que les systèmes d’IA ont besoin d’historiques reconstituables des événements de données, de modèles, d’outils et de décisions.
Pour un runtime d’agent, la question d’audit importante est :
Pourquoi le modèle a-t-il dit cela ?
L’historique seul ne peut pas répondre. Il faut savoir quel contexte a été assemblé, quelles mémoires ont été incluses, quels artefacts bruts ont été rechargés, quelles politiques ont omis des données et à quel participant ou à quelle branche l’état appartenait. Une seconde question d’audit est tout aussi importante :
Pourquoi le modèle n’a-t-il pas vu un élément ?
C’est ici que l’assemblage gouverné par des politiques diffère d’une journalisation ordinaire. Un incident de production peut ne pas venir d’un mauvais résultat d’outil. Il peut venir d’un résultat utile exclu parce qu’il était périmé, au-delà du budget, non admissible dans la branche, privé pour un autre participant, classé comme dérivé de Google ou interdit au rechargement brut. L’architecture consigne des résumés compacts des omissions pour permettre d’examiner l’absence, pas seulement la présence.
3. Assemblage du contexte gouverné par des politiques
L’assemblage du contexte gouverné par des politiques traite le contexte du modèle comme une projection de l’état du runtime. L’historique n’est pas abandonné. Il reste la vue destinée à l’humain. Mais on ne lui demande plus de porter toutes les responsabilités du runtime.
Le runtime distingue messages de l’historique, exécutions de modèles, appels d’outils, artefacts bruts, mémoires compactes, état des compétences chargées, points de reprise, lignée des branches, appartenance aux participants, décisions de politique et journaux d’assemblage du contexte. Un assembleur peut alors choisir ce que voit le modèle selon la tâche, la branche, le participant, le fournisseur, la politique de confidentialité, la politique de fraîcheur et l’état de récupération actuels.
Ce modèle sépare quatre surfaces souvent confondues. L’historique est destiné à l’utilisateur : lisible, stable et adapté au produit. Le stockage d’artefacts est destiné au runtime et à l’audit : éléments bruts, récupérabilité et politique de conservation. La mémoire d’outil est destinée au contexte du modèle : compacte, liée à la provenance et attentive à la fraîcheur. L’assemblage du contexte est destiné à la requête elle-même : la sélection gouvernée par des politiques pour une génération.
La relation la plus importante est :
l’exécution d’un outil crée d’abord des artefacts ; la mémoire est une décision de politique qui s’y superpose.
C’est le cœur conceptuel de l’architecture. La seconde relation est :
l’assemblage du contexte est une requête sur le graphe contrainte par des politiques, pas une transformation de l’historique.
L’assembleur part de la frontière de génération active : le chat actuel, le message utilisateur source, la lignée des branches, le participant, le type de runtime, l’état de reprise, le fournisseur choisi, les compétences chargées et la disponibilité des outils. Il sélectionne ensuite les enregistrements admissibles du graphe et décide comment chacun doit apparaître. Un message récent peut rester du contexte conversationnel. Une observation d’outil peut entrer comme mémoire compacte. Un enregistrement périmé peut n’apparaître que comme marqueur de péremption et indication de revalidation. Un artefact brut peut être rechargé lorsqu’une preuve exacte est requise. Un appel d’outil non résolu peut être protégé comme état de récupération. Un enregistrement privé, périmé, remplacé, non admissible dans la branche ou restreint par fournisseur peut être omis, avec le motif journalisé sans exposer le contenu.
Cette conception n’exige pas que chaque récupération utilise une base de données graphe. Le graphe est le modèle du runtime : conversations, branches, participants, exécutions de modèles, appels d’outils, artefacts, mémoires, points de reprise, assemblages et décisions de politique reliés. Recherche vectorielle, requêtes sur tables indexées, lectures de stockage et parcours de graphe peuvent tous servir de techniques de mise en œuvre au sein de ce modèle.
Une représentation utile est :
Historique visible par l’utilisateur = projection lisible de nœuds Message sélectionnés
Contexte destiné au modèle = projection sélectionnée par politique sur Message + ToolMemory + ToolArtifact + SkillState + ContinuationCheckpoint + PolicyDecision + lignée des branches
La différence n’est pas théorique. Un historique répond à « Qu’ont semblé dire l’utilisateur et l’assistant ? » Un graphe de runtime répond aux questions auxquelles l’historique ne peut pas répondre : quelle exécution a produit la réponse, quels outils elle a demandés, quels artefacts ces outils ont produits, quelles mémoires en ont été dérivées, à quelle branche et à quel participant l’état appartenait, quelle politique a autorisé ou omis chaque enregistrement, et quelles anciennes mémoires étaient périmées, contredites ou remplacées.
Ces questions font l’intérêt de l’approche en graphe. Elle transforme la sélection du contexte en requête sur des relations typées plutôt qu’en stratégie de troncature d’une liste de messages.
En pratique, l’approche en graphe a trois rôles. Elle préserve les éléments probants en gardant les artefacts bruts hors de l’historique, sous réserve des politiques de conservation et de confidentialité. Elle crée un contexte compact et utilisable en transformant le contenu utile des artefacts en mémoires d’outils pour les appels ordinaires au modèle. Et elle explique la sélection en consignant pourquoi le modèle a vu une projection du graphe plutôt qu’une autre.
Le graphe n’a pas besoin d’être visible pour les utilisateurs. L’utilisateur voit la conversation. Le runtime utilise le graphe pour décider de ce que le prochain appel au modèle doit savoir.
TRADITIONAL TRANSCRIPT REPLAY
- Message
- Message
- Message
- Message
- LARGE PROMPT
Replays old tool calls and results
Includes stale, private, and noisy data
Loses important structure and provenance
Wasteful, expensive, error-prone
POLICY-GOVERNED ASSEMBLY
- RAW ARTIFACTS
- COMPACT MEMORIES
- SELECTED CONTEXT
- MODEL REQUEST
Keeps raw evidence out of the prompt
Includes only relevant, current, and allowed data
Preserves provenance and recovery state
Smaller, faster, safer, and more reliable
4. Modèle de mise en œuvre
Cette section décrit la forme concrète du modèle implémenté dans NanthAI:Edge. Ces détails sont utiles parce qu’ils montrent ce qui doit exister une fois que l’historique n’est plus la source de vérité du contexte du modèle.
4.1 Modèle du graphe de runtime
Le graphe de runtime commence par expliciter les entités importantes. Une Conversation est le conteneur de chat appartenant à l’utilisateur. Une Branch est un chemin ordonné dans ce graphe de conversation, qui hérite de l’historique partagé antérieur. Un Participant est la configuration de modèle ou de profil Persona active pour une exécution. Un Message est le nœud de l’historique visible par l’utilisateur. Un ModelRun est une tentative de génération auprès d’un fournisseur pour un participant, un message ou une tâche.
Le travail des outils possède ensuite son propre vocabulaire. Un ToolCall est l’appel de fonction demandé par le modèle, avec ses arguments et son identifiant. Un ToolArtifact est le relevé brut persistant d’exécution de cet appel ou résultat. Une ToolMemory est la mémoire compacte destinée au modèle dérivée d’un ou plusieurs artefacts. SkillState capture les compétences chargées, les profils actifs, les outils directs et l’état des intégrations visibles pour une exécution. Un ContinuationCheckpoint stocke un état de runtime reprenable entre les frontières d’actions.
La couche d’assemblage est aussi explicite. Un ContextAssembly est le relevé versionné des décisions d’un assemblage de prompt destiné au modèle. Une PolicyDecision consigne les décisions de confidentialité, de fraîcheur, d’élagage, de rechargement, de routage de fournisseur ou de récupération.
Les relations canoniques sont simples.
- Le contenu de l’assistant affiché dans l’historique est généré par un ModelRun précis.
- Un ModelRun demande un ou plusieurs enregistrements ToolCall.
- Chaque ToolCall exécuté, échoué, en attente ou différé produit un ToolArtifact persistant.
- Une ToolMemory est dérivée de cet artefact, en préservant la provenance jusqu’aux éléments bruts.
- Les branches héritent des précédentes sans recopier tout l’état.
- Un ContextAssembly consigne les mémoires incluses et les artefacts bruts rechargés.
- Un ContinuationCheckpoint restaure l’état du runtime plutôt que les seuls messages de l’historique.
- Une PolicyDecision contraint l’assemblage afin d’expliciter les choix de confidentialité, de fournisseur, de fraîcheur, d’élagage et de récupération.
Runtime graph
- Conversation
- Branch
- Participant
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- Participant
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- ToolCall → ToolArtifact → ToolMemory
- Message → ModelRun
- Participant
- Branch
Tool memories across the active lineage → ContextAssembly → PolicyDecision → Checkpoint
Relationships
Conversation contains / has Branches; Branches inherit from the conversation.
Branches contain Participants; Participants contain Messages; Messages generate ModelRuns.
ModelRun requests ToolCall; ToolCall produces ToolArtifact; ToolMemory is derived from ToolArtifact.
ToolMemory is assembled into ContextAssembly. ContextAssembly is constrained by PolicyDecision. Checkpoint restores state.
Legend: contains / has; inherits from; generates; requests; derived from; assembled into; constrained by; restores.
4.2 Artefacts d’outils persistants
Un ToolArtifact est le relevé brut persistant d’une exécution d’outil.
Il capture l’identifiant de l’appel, le nom de l’outil, les arguments, le résultat brut ou l’erreur, le statut, l’appartenance au message et à la tâche, au participant et à l’exécution de modèle, la portée de branche, la classification de confidentialité, les compétences et profils d’outils actifs, les métadonnées de fournisseur et de runtime, et les références de stockage des arguments ou résultats trop volumineux.
Les résultats d’outils au niveau des messages peuvent toujours exister pour la compatibilité des clients et le rendu. Ils peuvent être tronqués, résumés ou adaptés à l’interface. Cela convient à l’affichage. Cela ne suffit pas aux flux de travail de longue durée, à l’audit, aux nouvelles tentatives ou à le rechargement exact.
L’étape importante consiste à capturer les artefacts complets avant la troncature au niveau des messages. L’interface peut rester compacte tandis que le backend garde des éléments probants récupérables.
Cela compte lorsqu’un tour ultérieur nécessite exactement le CSV d’un appel précédent, qu’un appel échoué doit être réessayé, qu’un sélecteur différé doit continuer, qu’un document cité doit être expliqué, qu’un identifiant de fichier généré doit survivre, que la sortie d’un sous-agent doit être auditée ou qu’une charge utile privée doit rester hors du contexte des modèles frères.
4.3 Mémoires d’outils
Une ToolMemory est un enregistrement compact destiné au modèle, dérivé d’un ou plusieurs artefacts.
Les mémoires d’outils sont distinctes des mémoires utilisateur. Ces dernières représentent la personnalisation et les faits durables sur l’utilisateur. Les mémoires d’outils représentent les éléments probants du runtime et l’état dérivé des outils.
Les mémoires d’outils portent les identifiants des artefacts sources, les noms des outils sources, un résumé, des charges utiles structurées, la confiance, sa source et sa justification, des notes d’ambiguïté et de limites, la classification de confidentialité, la classe de fraîcheur, la date de péremption, les outils de revalidation, les localisateurs de provenance, le dernier statut de résolution, les tentatives de réparation, les liens de contradiction et de remplacement et la politique de promotion.
L’objectif n’est pas que le modèle retienne tout. Il est de rendre la mémoire justifiable. Une mémoire compacte doit garder assez de provenance pour que le système puisse expliquer plus tard son origine, sa validité actuelle et si les éléments bruts exacts peuvent ou doivent être rechargés.
- 1. USER REQUEST: User asks a question or gives a task
- 2. MODEL RUN: Model decides to call one or more tools
- 3. TOOL CALL(S): Tool(s) executed with arguments from the model
- 4. TOOL ARTIFACT: Raw result or error captured as durable evidence (artifact)
- 5. TOOL MEMORY: Compact memory derived from artifact(s) with provenance
- 6. CONTEXT ASSEMBLY: Policy selects what to include, what to rehydrate, what to omit, and why
- 7. MODEL REQUEST: Assembled context sent to the model for the next generation
FEEDBACK LOOPS (as needed)
Revalidation · Retries · Continuations · Checkpoints · Branches · Subagent Promotion
Feedback returns to the relevant execution and context stages.
4.4 ContextAssembly
ContextAssembly est l’enregistrement à part entière de ce qui est entré dans une requête précise au modèle.
Il stocke le nombre de messages selon l’ancien mécanisme, le nombre de messages assemblés, l’écart estimé de tokens, le nombre d’artefacts bruts, de mémoires sélectionnées et d’artefacts rechargés, la version de politique et d’assembleur, les références sélectionnées du graphe, les résumés d’omission, les décisions de sécurité et de confidentialité, les durées de requête du graphe, d’évaluation des politiques et de sérialisation.
La question d’audit est :
Pourquoi le modèle a-t-il vu ce contexte ?
La réponse ne devrait pas être « parce qu’il était dans les N derniers messages ». Elle devrait plutôt ressembler à :
Cette réponse incluait ToolMemory_123, dérivée de ToolArtifact_88, héritée de la branche active, visible pour ce participant, assemblée sous la version 4 de la politique, sans rechargement de l’artefact brut car la mémoire compacte suffisait.
Ou :
Cette réponse omettait une charge utile brute dérivée de Google parce que la politique de routage de fournisseur et de confidentialité la classait comme restreinte, mais incluait un résumé sûr et une indication d’outil de revalidation.
4.5 PolicyDecision
L’assemblage du contexte est une évaluation de politiques, pas seulement une réduction de longueur.
- La politique d’appartenance détermine à quel participant ou exécution de modèle appartient un enregistrement.
- La politique de visibilité décide s’il est privé pour le participant, visible dans la branche, visible dans la conversation ou réservé à l’audit.
- La politique de confidentialité détermine si les données peuvent être envoyées au modèle ou fournisseur choisi.
- La politique de fraîcheur décide si un enregistrement est actuel, périmé, durable ou à revalider.
- La politique de promotion décide si un artefact doit devenir une mémoire destinée au modèle.
- La politique de rechargement décide si une mémoire compacte suffit ou si des éléments bruts exacts sont nécessaires.
- Les politiques de contradiction et de remplacement résolvent les conflits et les remplacements.
- La politique de récupération protège l’état non résolu, échoué, différé ou indispensable aux nouvelles tentatives.
- La politique de conservation décide si l’enregistrement doit être gardé, élagué, archivé ou supprimé.
L’implémentation consigne des résumés compacts des politiques et le nombre d’omissions plutôt que des traces détaillées par enregistrement à chaque assemblage en production. Les traces détaillées restent disponibles dans les tests et les audits ciblés.
| Scenario | Policy Decision | Action | In Context? | Why |
|---|---|---|---|---|
| Google Gmail body (ZDR provider) | Privacy / Provider Restriction | Omit raw body, include safe summary + revalidation tool | Partial | Provider cannot receive Google content |
| Slack thread summary (2 weeks old) | Freshness (Bounded) | Include as stale marker + revalidation tool | Stale | May be outdated, needs recheck |
| Generated CSV file handle | Durability (Session) | Include compact memory (file ID, schema) | Yes | Still valid in session, low risk |
| Sibling branch analysis result | Branch Visibility (Branch-Private) | Omit from active branch context | No | Different branch, not relevant |
| Failed tool call (retry needed) | Recovery (Protected) | Include error + retry state | Yes | Required for recovery |
Every inclusion or omission is logged with policy version, reason, and scope.
4.6 Classes de contexte
Le contexte est classé selon la manière dont il doit être élagué, conservé, résumé, rechargé et exposé.
- Le contexte conversationnel comprend les textes de l’utilisateur et de l’assistant ou les discussions propres à une branche, et peut être fenêtré et résumé.
- Le contexte opérationnel comprend les arguments et résultats d’outils, les chemins de l’espace de travail et les identifiants de fichiers générés ; il doit être préservé sous forme d’artefacts avant d’être résumé.
- Le contexte épistémique comprend les affirmations, constats et faits extraits, et a sa place dans la mémoire d’outil avec des métadonnées de confiance et de fraîcheur.
- Le contexte de provenance comprend les identifiants d’artefacts, de documents et les citations, et doit être préservé pour l’audit ou rechargé lorsque des affirmations en dépendent.
- Le contexte de politique comprend les contraintes des fournisseurs, la portée OAuth et les droits d’accès, et doit être appliqué avant l’assemblage.
- Le contexte de récupération comprend les erreurs, l’état différé et les contrats de nouvelle tentative, et ne doit pas être élagué tant qu’il n’est pas résolu.
- Le contexte de planification comprend les compétences chargées, les profils actifs et la décomposition des tâches pour l’exécution ou la reprise en cours.
Cela empêche l’âge des messages de devenir la seule règle d’élagage.
4.7 Fraîcheur et péremption
Les mémoires d’outils ne doivent pas devenir silencieusement des vérités éternelles. Chaque mémoire d’outil reçoit une classe de fraîcheur :
- Les mémoires volatiles couvrent notamment les compteurs de messages non lus, les disponibilités et les classements de recherche.
- Les mémoires de session couvrent les fichiers temporaires du runtime, les répertoires de travail et l’état de brouillon.
- Les mémoires à validité limitée couvrent des instantanés comme les fiches CRM, les résumés de fils Slack ou l’état de pages Notion.
- Les mémoires durables couvrent les métadonnées de fichiers générés, les citations de documents et les identifiants explicites d’entités chez les fournisseurs.
- Les mémoires permanentes couvrent les identifiants de versions immuables de documents ou les identités d’artefacts de stockage générés.
L’assembleur n’injecte pas par défaut les mémoires volatiles ou à validité limitée périmées comme des faits actuels. Il peut les inclure comme contexte périmé, exposer un chemin de revalidation, les omettre ou choisir un rechargement brut lorsque des éléments exacts sont nécessaires et autorisés.
4.8 Contradiction et remplacement
Cette approche évite autant que possible une mémoire où la dernière écriture l’emporte.
Les mémoires d’outils peuvent se contredire. Une branche peut analyser un brouillon de document et produire une conclusion. Une autre peut analyser une version ultérieure. Une recherche chez un fournisseur peut indiquer un effectif qu’une recherche ultérieure contredit. Un modèle peut mal résumer une source tandis qu’un autre extrait la valeur exacte du fichier brut.
Le runtime suit les liens de conflit, de remplacement, la confiance, sa source, les artefacts sources, les limites et les notes d’ambiguïté. Les champs importants sont directionnels : conflictsWith marque un désaccord, supersedes signifie que la mémoire actuelle remplace les précédentes, et supersededBy relie une mémoire obsolète à celle qui la remplace.
La politique est prudente. Les mémoires contradictoires restent des enregistrements séparés. Les mémoires remplacées sont normalement omises du contexte actuel, tandis que leur remplacement reste sélectionnable. Les deux côtés d’une contradiction peuvent être inclus lorsque l’incertitude compte. La résolution exige provenance et confiance, pas seulement récence.
Un détail pratique compte : supersedes doit signifier « cette mémoire actuelle remplace des mémoires plus anciennes ». La direction inverse doit utiliser un champ distinct comme supersededBy.
Cela paraît mineur, mais l’ambiguïté peut ici provoquer de vrais bugs. Un assembleur qui supprime la mémoire de remplacement plutôt que l’obsolète peut faire raisonner le modèle à partir d’un état périmé tout en croyant être prudent.
4.9 Appartenance aux participants et au runtime
NanthAI:Edge prend en charge les exécutions multi-modèles, les discussions autonomes, les sous-agents, les branches, les tâches planifiées et les reprises riches en outils. L’appartenance de l’état est donc importante.
Un message visible de l’assistant peut devenir un contexte de conversation partagé.
Mais l’état brut du runtime ne doit pas devenir automatiquement partagé simplement parce qu’il est apparu dans le même chat.
Dans cette architecture, les artefacts d’outils, les mémoires d’outils, les assemblages de contexte et les points de reprise portent des métadonnées d’appartenance telles que visibilityScope, ownerParticipantId, ownerModelRunId, sharedWithParticipants, runtimeIsolationPolicy et runtimeKind.
La politique par défaut est que l’état d’une exécution de modèle est limité au participant et isolé. La sortie visible de l’assistant peut devenir un contexte de branche ou de conversation après finalisation. L’état de brouillon privé n’est pas transmis aux participants frères. Les appels d’outils non résolus restent visibles pour leur participant propriétaire et les reprises nécessaires. Les artefacts des sous-agents enfants restent privés ou réservés à l’audit jusqu’à leur promotion explicite.
C’est l’un des aspects les moins documentés de l’architecture des agents.
De nombreux exemples multi-agents parlent de collaboration. Moins définissent la frontière entre ce qu’un modèle a dit visiblement, ce qu’il a vu en privé, ce que ses outils ont renvoyé, ce qu’un sous-agent enfant a découvert, ce que le parent peut utiliser plus tard et ce qui reste réservé à l’audit.
Cette architecture explicite cette frontière.
4.10 Assemblage du graphe tenant compte des branches
Les conversations NanthAI peuvent se ramifier. L’assemblage du contexte ne peut donc pas se limiter à « récupérer les mémoires récentes par identifiant de chat ». Si deux branches produisent des identifiants de documents, des fichiers générés ou des résultats d’analyse différents, les artefacts plus récents d’une branche sœur ne doivent pas polluer la branche active.
La solution consiste à rendre l’assemblage tenant compte des branches. Les candidats sont d’abord sélectionnés dans la lignée de la branche active. Les enregistrements explicitement partagés ou à portée de conversation peuvent toujours remplir les places restantes, mais l’état privé d’une branche sœur n’évince pas le contexte de la branche active.
Les journaux d’assemblage consignent les exclusions de branches séparément des omissions ordinaires dues au budget de contexte. Cela compte parce que les bugs de branche sont subtils. Le modèle peut répondre avec assurance avec un fichier, une citation ou un identifiant de document appartenant à une autre branche. L’interface semblera correcte. L’historique semblera plausible. Mais le runtime aura mélangé deux chemins incompatibles.
L’assemblage tenant compte des branches traite la conversation comme un graphe, pas comme une liste de messages à plat.
BROKEN: TRANSCRIPT REPLAY (BRANCH POLLUTION)
- Root conversation → Branch Point (User question)
- Branch A (Active) → Generates File_A.csv
- Branch B (Sibling) → Generates File_B.csv
- Active Branch A – Next Call Context: Root conversation; Branch A messages; File_A.csv (correct); Branch B messages (leaked); File_B.csv (incorrectly included)
Linear transcripts can leak sibling branch artifacts into the active branch.
POLLUTION EXAMPLE: When Branch A asks a follow-up, transcript replay includes everything in the history — including artifacts from Branch B.
Result: Sibling branch contamination, higher token cost, and incorrect or confusing model context.
CORRECT: BRANCH-AWARE ASSEMBLY
- Root conversation → Branch Point (User question)
- Branch A (Active) → File_A.csv
- Branch B (Sibling) → File_B.csv (Private to B); Explicit Share (Optional) → Branch A
- Active Branch A – Next Call Context: Root conversation; Branch A messages; File_A.csv (correct); Shared from B (if any); Branch B private items (excluded)
Assembler selects only active lineage and explicitly shared records.
ASSEMBLY RULES (Examples): Include active lineage only; Include explicitly shared records; Respect branch-private boundaries; Apply policy and freshness rules; Avoid sibling branch leakage.
Result: Clean, relevant context. Lower token cost. No branch leakage. Policy-governed and auditable.
Legend: Active Branch; Sibling Branch; Branch Point; Message; Artifact / Generated File; Explicitly Shared; Branch-Private (Not Visible); Active Lineage; Sibling Lineage; Explicit Share; Leak / Pollution (Bad).
4.11 Rechargement brut
Une mémoire compacte suffit généralement. Parfois, non. Si l’utilisateur demande « utilisez exactement le CSV précédent », un résumé ne suffit pas. Le runtime doit récupérer l’artefact brut.
L’architecture permet un rechargement brut délimitée. Le mot important est délimitée. Les artefacts bruts adossés au stockage ne sont rechargés qu’après sélection par politique, pas d’emblée.
L’assembleur vérifie si le détail exact est nécessaire, si l’artefact a été sélectionné, si la classification de confidentialité est autorisée, si le budget en octets est acceptable, si la voie fournisseur est autorisée et si l’enregistrement est non résolu ou essentiel à la récupération.
- Si oui, l’artefact brut peut être inclus.
- Sinon, l’assembleur peut inclure une mémoire compacte, une référence, un marqueur de péremption, une indication de revalidation ou rien.
Cela évite deux extrêmes indésirables : réinjecter indéfiniment des charges utiles brutes d’outils, et résumer jusqu’à faire disparaître des éléments dont les tours ultérieurs ont besoin à l’identique.
POLICY-GOVERNED ASSEMBLY
- RAW ARTIFACTS
- COMPACT MEMORIES
- SELECTED CONTEXT
- MODEL REQUEST
Keeps raw evidence out of the prompt
Includes only relevant, current, and allowed data
Preserves provenance and recovery state
Smaller, faster, safer, and more reliable
4.12 La cognition du runtime n’est pas l’UX
Cette architecture ajoute beaucoup d’état interne au runtime. Cet état n’a pas automatiquement sa place dans l’interface de chat. Les mémoires d’outils, assemblages de contexte, décisions de politique, enregistrements de réparation de provenance, décomptes d’omissions et traces de requêtes du graphe relèvent de la cognition du runtime.
Ils ne doivent pas devenir de la prose conversationnelle sauf si l’utilisateur demande une explication d’audit ou de débogage, ou ouvre volontairement un inspecteur.
Cette frontière est importante. Beaucoup de produits IA la brouillent. L’assistant commence à raconter dans la conversation sa mémoire, ses politiques, son état interne et sa comptabilité des outils.
Cela rend l’historique plus bruité et souvent moins digne de confiance. Dans NanthAI:Edge, l’historique destiné à l’utilisateur reste la surface du produit. Le graphe de runtime reste la surface d’exécution.
La provenance peut apparaître par des citations, des cartes de fichiers générés, des vues de débogage ou un futur inspecteur « pourquoi le modèle a-t-il dit cela ? ».
Mais le runtime ne doit pas réécrire l’historique de conversation pour s’expliquer.
4.13 Frontières entre modes du runtime
Les modes du runtime nécessitent des règles d’assemblage différentes. Le chat normal et le chat multi-modèles utilisent un contexte assemblé tenant compte des branches pour le participant actif. La discussion autonome préserve la forme du prompt de débat, les directives du modérateur, les noms des intervenants et les contenus non textuels pris en charge, tout en ajoutant le contexte assemblé visible par le participant. Une exécution enfant de sous-agent capture ses artefacts et mémoires d’outils locaux avec une appartenance à l’enfant, privés ou réservés à l’audit par défaut. La reprise d’un parent conserve son point de reprise déterministe, joint les références d’assemblage sélectionnées et journalise la décision de restauration plutôt que d’interroger aveuglément l’historique. Les tâches planifiées utilisent la voie normale de génération du backend lorsque la tâche crée des tours de chat et les route vers la génération. Les envois dans les branches d’Ideascape utilisent la même voie tenant compte des branches après que le client a envoyé les identifiants explicites des parents.
C’était une étape de bouclage importante, car les bugs de contexte les plus difficiles se trouvent souvent aux limites de l’orchestration. Un tour normal de chat peut utiliser directement la branche et le participant actifs. La reprise d’un parent après des sous-agents est différente : le parent doit recevoir les résumés promus des enfants, les références de fichiers générés, le statut des enfants échoués et l’état pertinent pour réessayer, mais pas les charges utiles brutes de l’espace de travail des enfants, sauf promotion explicite.
Cela nécessite au besoin des métadonnées comme le type de runtime, les identifiants de lot et d’exécution de sous-agent, les identifiants de message ou de tâche parent, les identifiants d’appel d’outil parent et les décisions de promotion. Le but n’est pas de créer davantage de schéma pour le plaisir. Il est de rendre représentables les décisions d’appartenance et de promotion avant que l’assembleur sérialise quoi que ce soit dans une requête fournisseur.
4.14 Frontières de promotion des sous-agents
Les sous-agents rendent concrète la séparation entre historique de conversation et contexte.
Un sous-agent enfant peut appeler des outils, lire des documents, générer des fichiers intermédiaires, rencontrer des erreurs et maintenir un état de brouillon privé. Le parent peut n’avoir besoin que du rapport final de l’enfant, d’une référence de fichier généré, d’un résumé compact d’erreur ou du statut d’un lot. Si le runtime ne stocke l’état de l’enfant que comme des messages de conversation, il est tentant d’en réinjecter trop dans le parent. S’il abandonne l’état après résumé, l’audit et la récupération en pâtissent.
Le runtime utilise une sémantique de promotion. Les arguments et résultats bruts des outils enfants sont propres à l’enfant ou réservés à l’audit par défaut. Les références de fichiers générés deviennent visibles par le parent après la promotion de l’enfant à l’état terminal. Le rapport final de l’enfant est visible à la reprise du parent. Le statut d’un enfant échoué ou ayant dépassé le délai peut être promu comme contexte compact de récupération. Les détails du brouillon ou de l’espace de travail de l’enfant ne sont pas visibles par le parent sans promotion explicite.
Cela donne au parent assez de contexte pour continuer sans transformer chaque exécution enfant en bagage brut d’historique.
Parent Agent (Orchestrator) — Before Subagent Call
- User request: “Research ACME Corp and prepare a report.”
- Subagent Call: Task scope, inputs, and constraints
Parent State (continues): Conversation history; Long-term memories; Policy & preferences; Runtime checkpoints
Child Subagent (Isolated Runtime) — Owns private runtime state and working context
Does Private Work: Tool Calls — Executes tools and external API calls; Raw Tool Payloads — Full results, responses, files, logs (verbose); Scratch / Intermediate State — Notes, reasoning, partial results, drafts, retries; Temporary Artifacts — Working files, temp exports, debug data.
Private to Subagent: Not visible to parent.
Produces Outputs: Final Report / Answer — Curated, high-quality result for the parent; Generated File Handle — Compact reference (file ID, schema, hash, storage pointer); Compact Memories — Summaries with provenance, TTL, and freshness; Audit Trail (Optional) — Tool call list, key decisions, policy summary (not raw data).
Isolation Boundary: Subagent state is not accessible to the parent at any time.
Promotion Gate
Policy-driven promotion of explicit outputs only. Everything else stays private.
Parent Resumes (after subagent completion)
- Receives Promoted Outputs Only: Final Report / Answer; Generated File Handle; Compact Memories; Audit Trail (if provided)
- Parent State (updated): Adds promoted memories; Stores file handle reference; Records audit summary; Continues conversation
- Next Steps: Parent decides what to do next (e.g., follow-up questions, new tasks, branch, or additional subagents).
What gets promoted?
Final Report / Answer: Curated output intended for the parent.
Generated File Handle: Stable reference to large or expensive artifacts.
Compact Memories: Bounded, policy-checked context for future turns.
Audit Trail (Optional): High-level trace for accountability (no raw data unless allowed).
What stays private?
Raw tool payloads
Scratch / intermediate state
Temporary artifacts
All internal tool activity
Only promoted outputs cross the boundary.
Isolation Guarantees
No raw data leakage: Parent never sees raw tool payloads or scratch state.
Least-privilege promotion: Only explicit, policy-approved outputs are shared.
Bounded lifetime: Subagent state is discarded after completion.
Clean parent context: Parent resumes with only promoted, relevant context.
Auditability preserved: Policy decisions and summaries are recorded for traceability.
4.15 Conservation et nettoyage automatique
Les artefacts persistants créent une responsabilité de stockage. L’architecture ne signifie pas « tout stocker pour toujours ». Elle signifie que la conservation devient explicite.
Le modèle de conservation doit équilibrer auditabilité et confidentialité. Les artefacts bruts peuvent être conservés, archivés, expurgés, hachés, stockés séparément ou supprimés selon les politiques. Les contextAssemblyLogs échantillonnés doivent être élagués sans ménagement. La suppression du compte doit nettoyer les artefacts, mémoires et journaux d’assemblage. Les artefacts réservés à l’audit doivent rester hors du contexte normal du modèle. Les charges utiles adossées au stockage ne doivent être rechargées qu’après vérifications de confidentialité et de budget en octets. Les références de fichiers générés et de documents nécessitent un nettoyage qui les préserve, pour ne pas casser les citations et références de fichiers actives.
C’est l’une des raisons pour lesquelles cette architecture se justifie surtout pour des travaux substantiels avec des outils.
Conserver les éléments bruts améliore la récupération et l’audit, mais augmente aussi la charge de classification, de chiffrement, de contrôle d’accès, de suppression et de discipline du routage des fournisseurs.
5. Analyse de l’architecture
5.1 Modèle de coût en tokens
Avec la réinjection de l’historique, le coût présenté au modèle d’une conversation riche en outils est approximativement :
conversation_window + historical_tool_calls + historical_tool_results + summaries + retry_state
Avec l’assemblage du contexte fondé sur le graphe, le coût est approximativement :
conversation_window + selected_tool_memories + protected_recovery_state + selected_skill_state + optional_raw_rehydration
La différence essentielle est ce qui croît avec le volume historique d’outils. Dans la réinjection de l’historique, les anciennes charges utiles peuvent rester dans le circuit jusqu’à être tronquées ou résumées. Dans cette architecture, les artefacts bruts sont conservés séparément, et seuls les mémoires compactes, l’état non résolu protégé ou les éléments explicitement rechargés entrent dans le contexte du modèle.
C’est le cœur économique de l’architecture.
5.2 Artefacts bruts et mémoires compactes
La séparation entre artefacts bruts et mémoire crée deux couches. La couche d’éléments probants contient les arguments complets, les sorties brutes, les erreurs, les empreintes, les références de stockage, la provenance et les métadonnées du runtime. La couche de contexte contient les résumés compacts, les faits structurés, les références de fichiers générés, les marqueurs de péremption, les métadonnées de confiance et les indications de revalidation.
Cela permet de réduire la taille du contexte sans perdre l’auditabilité. Un résumé peut être peu coûteux et utile, mais il ne doit pas être le seul enregistrement survivant.
5.3 ContextAssembly comme frontière de cache et d’audit
L’assemblage du contexte crée une frontière stable entre l’état stocké et la sérialisation des requêtes fournisseur. Le runtime peut changer sa sérialisation des messages, mais le relevé d’assemblage capture toujours les références du graphe sélectionnées et la version de politique qui les a sélectionnées.
L’architecture vise une reproductibilité versionnée par politique, pas une réinjection éternellement identique octet par octet. Cela signifie qu’une même version de politique appliquée au même instantané du graphe doit sélectionner les mêmes ensembles d’artefacts et de mémoires, le même état brut protégé et les mêmes décisions de politique. Cela ne garantit ni une tokenisation identique ni une sortie identique d’un modèle réel chez des fournisseurs non déterministes.
5.4 Contexte limité au participant
Dans le chat multi-modèles, le partage de l’historique et le partage du runtime sont deux choses différentes.
Si deux modèles répondent au même prompt utilisateur, celui-ci peut voir leurs sorties finales côte à côte. Cela ne signifie pas que le bloc-notes privé, les erreurs d’outils ou les charges utiles brutes obtenues via OAuth du modèle A doivent être visibles par le modèle B.
L’architecture explicite cette distinction au moyen de la portée de visibilité et de la politique d’isolation du runtime.
C’est un avantage d’évaluation considérable. Les échecs peuvent être décomposés par couche : enregistrement visible dans la branche, privé au participant, réservé à l’audit, promu, périmé, omis par politique de fournisseur ou de confidentialité, ou rechargé parce que des éléments exacts étaient nécessaires.
5.5 L’assemblage du contexte comme requête sur le graphe
L’architecture présente l’assemblage du contexte comme une requête sur les entités du runtime, contrainte par la lignée de la branche active, la visibilité du participant, l’isolation du runtime, la classification de confidentialité, la politique de promotion, la politique de fraîcheur, la provenance de la confiance, les contradictions et remplacements, l’état de reprise, la protection des nouvelles tentatives et de la récupération, le budget de contexte et les limites de rechargement brut.
C’est pourquoi « GraphRAG » n’est pas le bon cadre principal. GraphRAG porte généralement sur la récupération de connaissances métier ou de relations documentaires. Le graphe du runtime inclut l’état d’exécution, les politiques, les participants, les branches, les artefacts, les mémoires et les assemblages du contexte.
Le graphe du runtime est plus large qu’un graphe de connaissances.
5.6 Déterminisme et reproductibilité
L’architecture vise une reproductibilité versionnée par politique, pas une réinjection de prompt éternellement identique octet par octet.
Cette distinction est importante. Un SDK fournisseur peut changer la sérialisation. Le routage OpenRouter peut changer le modèle derrière une route automatique. La tokenisation peut différer selon les fournisseurs. Un appel réel au modèle peut être non déterministe même avec une entrée identique.
La cible de reproductibilité est plus restreinte et plus utile. La même version de politique appliquée au même instantané du graphe doit sélectionner les mêmes ensembles d’artefacts et de mémoires, le même état brut protégé et les mêmes décisions de politique. Les décisions de confidentialité, de routage de fournisseur, de portée de branche, de nouvelle tentative et de reprise doivent être explicables à partir de l’état stocké. Un assemblage antérieur doit pouvoir être reconstitué dans ses éléments substantiels pour l’audit et le débogage. Des changements de format inoffensifs ne doivent pas détruire l’auditabilité sémantique.
C’est pourquoi policyVersion, assemblerVersion, les références sélectionnées, les résumés d’omission et les champs de durée comptent. Ils définissent la frontière entre l’état du runtime et la sérialisation des messages fournisseur.
5.7 Pourquoi il ne suffit pas d’un contexte plus grand
Les grandes fenêtres de contexte aident, mais ne résolvent pas le problème architectural.
Une fenêtre plus grande peut contenir plus d’éléments périmés, d’état de brouillon privé, de bruit de branches sœurs, d’anciennes erreurs d’outils et de charges utiles brutes obtenues via OAuth. Elle peut retarder le moment où la troncature devient visible, mais ne décide pas de ce qui mérite d’être inclus.
L’architecture n’est pas un argument contre les modèles à grand contexte. Elle défend un remplissage délibéré de leurs fenêtres. L’assembleur peut toujours utiliser une grande fenêtre lorsque la tâche le nécessite. La différence est que les artefacts bruts, mémoires compactes, états de récupération et contraintes de politique sont mis en concurrence par des règles explicites au lieu de survivre par la chronologie.
6. Comparaison avec les travaux antérieurs
L’architecture s’inscrit dans une solide lignée de travaux sur l’ingénierie du contexte, les runtimes à graphe, la mémoire, la provenance et l’audit.
- L’ingénierie du contexte est désormais un concept courant de conception d’agents. Anthropic, Haystack, Atlan et d’autres ont défendu l’assemblage explicite du contexte à partir de consignes, d’historique, de données récupérées, d’outils, de mémoire et d’état de tâche, plutôt que son traitement comme une chaîne de prompt.
- LangGraph constitue un précédent fort pour l’état en graphe, les fils, les points de reprise, les instantanés, le rejeu et les modèles d’exécution durable.
- Les systèmes de mémoire des agents distinguent mémoires à court terme, à long terme, épisodique, sémantique, procédurale et de travail.
- MCP et les frameworks d’utilisation d’outils rendent ces outils explicites et journalisables.
- Les travaux sur l’event sourcing et les pistes d’audit soutiennent les relevés d’exécution par ajout uniquement et les historiques reconstituables.
- La recherche sur la mémoire tenant compte de sa provenance, notamment MemORAI et Portable Agent Memory, va vers une mémoire liée aux sources.
- Les travaux de sécurité sur l’injection de prompt, l’empoisonnement de mémoire, les fuites entre sessions et la sécurité des outils fondée sur la provenance soutiennent des frontières de politique plus strictes.
La contribution de NanthAI consiste à intégrer ces modèles convergents dans un contrat de runtime unique : artefacts d’outils persistants, mémoires compactes, provenance, appartenance aux participants, assemblage du graphe tenant compte des branches, décisions de politique et séparation entre historique de conversation et contexte.
Cette intégration est le point central. Elle transforme un ensemble de techniques utiles en un modèle de runtime rigoureux pour les agents riches en outils.
6.1 Ce qui semble standard
Plusieurs idées sont déjà standard ou presque : mémoire à court et à long terme, compaction de l’ancien contexte, utilisation des sorties d’outils aux tours suivants, points de reprise de l’état de l’agent, traitement des contenus récupérés, issus d’outils ou d’utilisateurs, comme potentiellement non fiables, gestion explicite du contexte plutôt que simple rédaction de prompts, et stockage des journaux pour le débogage et l’observabilité.
6.2 Ce qui semble émergent
D’autres idées sont visibles dans la littérature et les frameworks avancés, sans être stabilisées : mémoire d’agent tenant compte de sa provenance, détection de mémoire périmée, gestion des contradictions et remplacements, objets mémoire portables, rechargement d’artefacts bruts à partir de mémoires compactes, stockage d’état géré par l’application pour répondre aux contraintes de non-conservation des fournisseurs, assemblage du contexte gouverné par des politiques et mémoire comme surface d’attaque.
L’architecture suit cette direction, mais donne à ces idées un contrat concret de runtime produit.
6.3 Ce qui semble peu documenté
Les idées les plus intéressantes sont plus précises : ContextAssembly comme enregistrement persistant à part entière, PolicyDecision liée à chaque génération, ToolArtifact brut et persistant séparé de ToolMemory compacte, état du runtime privé au participant en chat multi-modèles, artefacts de sous-agents enfants privés jusqu’à promotion, assemblage du contexte tenant compte des branches sur la lignée de conversation, sémantique de promotion entre observation et mémoire, et cognition du runtime séparée de l’historique visible par l’utilisateur.
C’est là que cette architecture me semble la plus utile. Pas parce que chaque champ est individuellement surprenant. Parce que leur combinaison donne au runtime un vocabulaire pour des décisions qui resteraient sinon implicites.
6.4 Précédents les plus proches
Le précédent le plus proche parmi les frameworks est LangGraph : état en graphe, fils, points de reprise, rejeu, retour dans le temps et modèles d’exécution durable correspondent étroitement à la direction du runtime. La différence est la portée. L’architecture ne concerne pas seulement l’exécution en graphe. Elle fait des artefacts d’outils, mémoires compactes, visibilité des participants, lignées de branches, assemblages de contexte et décisions de politique des enregistrements à part entière.
Portable Agent Memory et MemORAI sont proches sur la provenance de la mémoire. Ils soutiennent l’idée que les mémoires doivent porter des liens aux sources et des métadonnées d’intégrité. L’architecture applique cette logique aux artefacts d’outils et au contexte de génération, pas seulement aux objets mémoire portables.
Les travaux sur l’event sourcing sont proches pour l’audit et le rejeu. Ils soutiennent les historiques d’événements par ajout uniquement et l’exécution reconstituable. L’architecture a besoin de cet historique temporel, mais aussi des relations en graphe entre branches, participants, artefacts, mémoires et politiques.
ARGUS et les travaux de sécurité apparentés fondés sur la provenance sont proches sur le plan de la sécurité. Ils considèrent que les décisions d’outils sont influencées par le contexte antérieur et utilisent la provenance pour raisonner sur les actions dangereuses. L’architecture généralise cette intuition : la provenance doit façonner non seulement les contrôles de sécurité, mais aussi l’inclusion ordinaire dans le contexte, le rechargement, la gestion des contradictions et l’audit.
MCP est pertinent parce que les appels d’outils et les sources de contexte deviennent explicites. Mais MCP est un protocole d’intégration, pas une politique de conservation, de provenance, de branche, de participant ou d’assemblage du contexte.
6.5 ZDR et état géré par l’application
Les contraintes de conservation nulle des données et de non-conservation côté fournisseur rendent la séparation entre historique de conversation et contexte plus importante.
Si la persistance côté fournisseur est indisponible ou indésirable, le propriétaire de l’application a toujours besoin de relevés d’audit internes, d’un état de récupération, de références de fichiers générés, de provenance des appels d’outils, de décisions de visibilité des participants, de politiques de suppression et de conservation, et d’un moyen de reconstituer ce que le modèle a vu.
Cela ramène la responsabilité de l’état dans le runtime du produit. Le fournisseur devient un point d’exécution. L’application devient responsable de décider quoi conserver, expurger, omettre et envoyer à chaque requête.
L’architecture correspond à ce modèle. Elle ne s’appuie pas sur les fils gérés par le fournisseur comme source de vérité persistante. Le backend conserve son propre état en graphe et assemble les requêtes fournisseur à partir de cet état.
7. Complexité des politiques et moyens de la gérer
Le principal défi d’ingénierie est que l’assemblage gouverné par des politiques introduit une couche de décision qu’il faut concevoir, tester et observer.
La réinjection de l’historique est simple à comprendre. Si le message est dans la fenêtre, le modèle le voit. S’il a été retiré, le modèle ne le voit pas.
L’assemblage du contexte gouverné par des politiques est plus puissant, et cette puissance nécessite des garde-fous. La couche de politiques doit empêcher l’omission d’éléments utiles, l’inclusion de mémoires périmées, les fuites d’état privé, les erreurs cachées indispensables aux nouvelles tentatives, le rechargement brut excessif, la récupération insuffisante d’éléments exacts, les erreurs de lignée de branche, la confiance excessive dans les résumés dérivés du modèle, la latence excessive des requêtes du graphe et une auditabilité superficielle.
C’est le compromis central. L’architecture échange l’héritage accidentel de l’historique contre des politiques explicites. Ce n’est mieux que si ces politiques sont testables, observables et délimitées.
L’architecture est la plus pertinente lorsque les processus d’outils sont longs ou riches en artefacts, que les éléments bruts comptent, que les contraintes de confidentialité ou de fournisseur comptent, que branches, sous-agents ou exécutions multi-modèles sont fréquents, que des faits périmés peuvent provoquer de vraies erreurs, que l’auditabilité a de la valeur et que le coût du contexte compte.
Elle l’est moins lorsque les chats sont courts, les outils rares, les sorties sans besoin d’audit, tout l’état partageable sans risque, les éléments exacts jamais nécessaires plus tard, ou les ressources d’ingénierie insuffisantes pour prendre en charge les tests de politiques et la télémétrie.
Pour un simple chatbot, la réinjection de l’historique peut suffire. Pour un espace de travail d’agent riche en outils, la complexité existe déjà. L’architecture la rend explicite et testable.
8. Risques et modes de défaillance
R1 : bugs de politique
L’assembleur peut omettre des éléments nécessaires ou inclure un contexte interdit.
Mesures d’atténuation : tests de scénarios déterministes, résumés d’omission, versionnement des politiques, évaluation avant/après et journaux d’assemblage échantillonnés.
R2 : croissance du stockage
Les artefacts bruts peuvent croître rapidement, notamment avec les fichiers, les charges utiles d’API, stdout/stderr et les sorties générées.
Mesures d’atténuation : classes de conservation, critères d’admissibilité au nettoyage automatique, nettoyage à la suppression du compte, références de stockage, hachage et politique de conservation réservée à l’audit.
R3 : fuites de confidentialité et vers les fournisseurs
Les artefacts stockés peuvent contenir des données obtenues via OAuth, des données Google, des données documentaires, des fichiers du runtime ou des charges utiles proches de secrets.
Mesures d’atténuation : classification de confidentialité, politique de routage des fournisseurs, contrôles de rechargement brut, résumés limités aux métadonnées et omission par défaut en cas d’incertitude.
R4 : fausse confiance issue des mémoires compactes
Les résumés peuvent être erronés, périmés ou incomplets.
Mesures d’atténuation : source de la confiance, localisateurs de provenance, classe de fraîcheur, liens de contradiction, limites et chemins de rechargement brut.
R5 : mémoire périmée
Le modèle peut s’appuyer sur d’anciennes observations externes comme sur des vérités actuelles.
Mesures d’atténuation : observedAt, staleAfter, classe de fraîcheur, outils de revalidation, marqueurs de péremption et politique d’omission.
R6 : pollution entre branches
Les artefacts de branches sœurs peuvent évincer l’état de la branche active.
Mesures d’atténuation : requête sur la lignée de la branche active, visibilité explicite de conversation ou de partage et télémétrie des exclusions de branches.
R7 : fuites entre participants
Un modèle participant peut voir l’état d’outil privé d’un autre participant.
Mesures d’atténuation : identifiants du participant et de l’exécution propriétaires, portée de visibilité, politique d’isolation du runtime, listes de partage et décisions de promotion.
R8 : dérive de la latence
Les requêtes du graphe, la réparation de provenance et le rechargement depuis le stockage peuvent devenir coûteuses.
Mesures d’atténuation : ensembles de candidats bornés, rechargement en deux passes après sélection par politique, télémétrie des durées, limites de tentatives de réparation et contrôles de latence.
R9 : promesses excessives de durabilité
Les artefacts et points de reprise aident à la récupération et à l’audit, mais n’équivalent pas à une exécution distribuée pleinement durable.
Mesures d’atténuation : langage précis, idempotence au besoin, points de reprise, contrats de nouvelle tentative et orchestration externe pour des garanties de processus plus fortes.
R10 : capacité à déboguer les omissions
Le modèle peut échouer parce qu’un état pertinent a été omis, et non parce qu’un mauvais état a été inclus.
Mesures d’atténuation : décomptes des motifs d’exclusion, traces détaillées déterministes, télémétrie des exclusions de branches, journaux d’assemblage échantillonnés et requêtes d’audit ou de débogage permettant d’inspecter les candidats autant que les enregistrements sélectionnés.
R11 : dérive de la promotion
La logique d’extraction peut promouvoir trop d’éléments en mémoire durable ou trop peu en mémoire visible par le modèle.
Mesures d’atténuation : promotionPolicy explicite, tests d’extracteurs, provenance de la confiance, règles de réduction du niveau de confidentialité et récupération de l’artefact brut lorsqu’une mémoire n’a pas été promue.
R12 : abus de rechargement
Le rechargement brut peut devenir une voie cachée permettant à des charges utiles volumineuses ou sensibles d’entrer dans le contexte du fournisseur.
Mesures d’atténuation : sélection en deux passes, contrôles de confidentialité avant les lectures de stockage, budgets en octets, contrôles de routage des fournisseurs et omission par défaut des données OAuth, Google ou proches de secrets en cas d’incertitude.
9. Mesures de l’implémentation
Si une validation comportementale complète nécessite des tests de référence plus larges, certaines affirmations peuvent être évaluées directement à partir de l’implémentation actuelle de NanthAI:Edge. Le code permet notamment de comparer un ancien contexte de réinjection de l’historique avec un contexte assemblé à partir du graphe pour des scénarios fixes riches en outils.
Ces mesures quantifient le volet d’économie de contexte de l’argument : quelle quantité de contenu de prompt destiné au modèle est évitée lorsque les anciennes charges utiles d’outils sont remplacées par des mémoires compactes, un contexte sélectionné dans le graphe, un filtrage de confidentialité et d’appartenance, et un état brut non résolu protégé.
La comparaison était simple. L’ancienne voie utilisait la réinjection de l’historique et des messages d’outils avec le bruit des charges utiles brutes. La voie assemblée utilisait des mémoires d’outils compactes, un contexte sélectionné dans le graphe, un filtrage de confidentialité et d’appartenance, et un état brut d’outil non résolu protégé.
Ce sont des mesures d’implémentation, pas un test de référence public ni une affirmation d’amélioration universelle de la réussite des tâches.
9.1 Réduction du contexte du prompt
Les écarts de tokens du prompt étaient fortement négatifs dans les scénarios comparatifs testés en conditions réelles.
- Le contexte du sélecteur de documents différé est passé de 1 020 à 142 tokens, soit une réduction de 86,1 %.
- La génération de fichiers avec plusieurs outils est passée de 1 905 à 221 tokens, soit une réduction de 88,4 %.
- La mémoire périmée d’application connectée est passée de 1 051 à 145 tokens, soit une réduction de 86,2 %.
- L’état du runtime avec plusieurs compétences est passé de 1 008 à 179 tokens, soit une réduction de 82,2 %.
- La visibilité des participants est passée de 961 à 161 tokens, soit une réduction de 83,2 %.
- La contradiction et le remplacement sont passés de 1 986 à 197 tokens, soit une réduction de 90,1 %.
Cela soutient la première affirmation d’économie de contexte de l’architecture : les anciens tours d’outils réussis n’ont pas besoin de rester dans le circuit de réinjection comme du bagage brut d’historique. Ils peuvent devenir des mémoires compactes liées à leur provenance, tandis que les éléments bruts restent récupérables hors du prompt.
9.2 Préservation de la récupération et de la provenance
Réduire les tokens n’est utile que si l’état important n’est pas perdu. Les scénarios testés comprenaient donc des cas de récupération, de provenance, de confidentialité et de frontières de branches et de participants : état de sélecteur de documents différé, fichiers générés, mémoire périmée d’application connectée, état de runtime avec plusieurs compétences, visibilité des participants, contradiction et remplacement, réparation de provenance cassée, rechargement exact de CSV brut, isolation des branches, erreurs indispensables aux nouvelles tentatives, omission de données Google pour confidentialité, état de reprise de sous-agent, attribution des interventions en discussion autonome, capture des artefacts des sous-agents enfants, métadonnées de reprise du parent après des sous-agents, compatibilité des tâches planifiées et compatibilité des envois de branche.
La voie assemblée a amélioré le comportement là où la réinjection de l’historique était structurellement faible. Elle a gardé à l’écart l’état du bloc-notes privé de chaque participant, réparé la provenance au lieu d’inventer des identifiants de remplacement, sélectionné l’état de la branche active, préservé les erreurs indispensables aux nouvelles tentatives, omis les contenus bruts Google lorsque la politique l’exigeait et récupéré les artefacts bruts exacts lorsque la politique l’autorisait.
9.3 Couverture des modes du runtime
La même architecture doit fonctionner dans tous les modes de génération, pas seulement dans la boucle de chat simple. Un tour normal, un tour multi-modèles, une discussion autonome, une exécution enfant de sous-agent, une reprise du parent, une tâche planifiée et un envoi de branche ont tous des frontières de contexte différentes.
La leçon importante de l’implémentation est qu’il faut tester l’assemblage du graphe à ces frontières. L’état d’un enfant sous-agent doit rester privé jusqu’à promotion. La reprise du parent doit utiliser un point de reprise déterministe. La discussion autonome doit préserver les noms des intervenants et les consignes du modérateur. Les envois de branche doivent hériter de la lignée active sans intégrer les artefacts des branches sœurs.
C’est là que le modèle en graphe compte le plus. Le graphe ne réduit pas seulement les tokens ; il donne au runtime un vocabulaire pour décider quel état appartient à quel mode de génération.
9.4 Ce qu’a montré la validation interne
La validation interne comportait deux couches.
- La couche déterministe vérifiait que la politique d’assemblage préservait l’état non négociable du runtime. Les artefacts bruts des outils étaient persistés avant la troncature au niveau des messages. L’état non résolu, différé, échoué et indispensable aux nouvelles tentatives restait visible par le modèle. L’état privé d’un participant n’était pas transmis aux participants frères. Les mémoires périmées étaient marquées ou omises plutôt que traitées silencieusement comme des vérités actuelles. Les mémoires remplacées étaient omises tandis que les mémoires actuelles de remplacement restaient sélectionnables. La provenance cassée était réparée ou marquée périmée sans invention d’identifiants de remplacement. Les artefacts et mémoires propres aux branches étaient sélectionnés dans la lignée active plutôt que dans les branches sœurs récentes. Les charges utiles brutes restreintes pour confidentialité étaient omises, tandis que les résumés sûrs et indications de revalidation restaient disponibles.
- La couche comparative en conditions réelles représentait ensuite les mêmes scénarios sous deux formes : ancienne réinjection de l’historique et contexte assemblé du graphe. La voie assemblée préservait les faits nécessaires à la récupération et à la provenance tout en réduisant fortement le contenu exposé au prompt.
Dans les scénarios réels mesurés ci-dessus, les réductions allaient de 82,2 % à 90,1 %.
9.5 Interprétation
Ces mesures valident le postulat de réduction du contexte dans les scénarios d’implémentation testés. Elles montrent que la voie assemblée de NanthAI:Edge peut réduire sensiblement la réinjection par défaut des charges utiles historiques des outils, l’exposition de l’état de brouillon privé des participants, le traitement d’un état périmé d’application connectée comme vérité actuelle, la pollution entre branches sœurs, la perte d’état indispensable aux nouvelles tentatives et l’invention de provenance lorsque les localisateurs sont cassés.
Les mesures répondent à une question :
L’assemblage du contexte gouverné par des politiques réduit-il le contexte exposé au modèle tout en préservant l’état important de récupération et de provenance dans les scénarios testés ?
La réponse est oui.
10. Discussion
Le principe que je retiendrais de cette architecture est le suivant : garder l’historique de conversation comme vue destinée à l’humain, stocker les artefacts bruts avant troncature, dériver des mémoires compactes des artefacts plutôt que des résumés détachés, préserver la provenance jusqu’aux éléments bruts, suivre fraîcheur et remplacement, limiter l’état du runtime par participant et par branche, assembler le contexte selon des politiques plutôt que l’âge des messages, journaliser assez d’éléments de la décision d’assemblage pour expliquer ce qui s’est passé, recharger les artefacts bruts uniquement lorsque des éléments exacts sont nécessaires et autorisés, et garder la cognition du runtime hors de l’UX sauf demande d’une vue d’audit par l’utilisateur.
C’est cela, l’architecture réelle.
Pour les équipes qui l’implémentent, les règles pratiques sont tout aussi directes. Résoudre une politique d’assemblage immuable avant de sélectionner les candidats du graphe. Récupérer la lignée de la branche active avant de compléter avec des candidats partagés ou à portée de conversation. Recharger les charges utiles brutes du stockage uniquement après leur sélection par les politiques de confidentialité et de budget. Traiter l’état d’un sous-agent enfant comme privé ou réservé à l’audit jusqu’à promotion explicite. Journaliser pourquoi les enregistrements ont été omis, pas seulement ce qui a été inclus.
Ni « mémoire à long terme ». Ni « GraphRAG ». Ni « fenêtres de contexte plus grandes ».
Un runtime gouverné par des politiques qui décide de ce qui mérite d’entrer dans le prochain appel au modèle.
Cela a plusieurs conséquences :
- L’assemblage du contexte devient une primitive du runtime. Il doit être testé et versionné comme tout autre contrat critique du backend.
- La mémoire devient justifiable. Une mémoire sans métadonnées de provenance, de fraîcheur et de confiance ne suffit pas aux travaux substantiels utilisant des outils.
- Les sorties d’outils cessent d’être du bagage d’historique. Les artefacts bruts peuvent être conservés pour la récupération et l’audit sans être réinjectés indéfiniment.
- Les frontières entre participants deviennent explicites. Les systèmes multi-modèles et à sous-agents doivent distinguer les sorties visibles de l’état privé du runtime.
- La ramification devient structurelle. Une branche n’est pas seulement une navigation dans l’interface ; elle contraint les artefacts et mémoires qui doivent influencer le prochain appel au modèle.
- L’audit passe des journaux aux explications. L’objectif n’est pas seulement de stocker les événements, mais de reconstituer pourquoi un modèle a vu un contexte précis.
C’est la direction que nous prenons dans NanthAI:Edge : l’historique d’un agent doit être persistant sans être réinjecté aveuglément, et le contexte du modèle doit être assemblé à partir d’un état en graphe gouverné par des politiques plutôt qu’hérité de l’ordre des messages.
11. Conclusion
L’industrie passe des chatbots aux agents utilisant des outils. Cela change le problème de l’état. Un chatbot peut souvent se contenter de réinjecter l’historique.
Un agent qui écrit des fichiers, lit des documents, appelle des API, recherche sur le web, lance des sous-agents, exécute des tâches planifiées, ramifie les conversations et compare des modèles ne peut pas traiter l’historique comme l’intégralité du runtime.
L’historique de conversation est une projection. Il est nécessaire, mais incomplet. Le modèle a besoin de contexte. L’utilisateur a besoin d’historique.
Le système a besoin d’éléments probants. L’auditeur a besoin de provenance. La boucle de nouvelle tentative a besoin d’un état de récupération. La couche de confidentialité a besoin de politiques.
Le produit a besoin que tout cela coexiste sans transformer chaque requête au modèle en décharge d’anciennes charges utiles d’outils.
C’est ce que fait l’architecture : elle donne à l’historique de l’agent une forme persistante dans le runtime sans transformer chaque requête future au modèle en réinjection d’anciennes charges utiles d’outils.
Les capacités d’un agent ne devraient pas croître linéairement avec la taille du prompt.
L’historique d’un agent ne devrait pas croître linéairement avec la réinjection de l’historique.
La couche suivante est l’assemblage du contexte gouverné par des politiques.
Références
- Anthropic. Effective context engineering for AI agents. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Haystack. Context engineering. https://haystack.deepset.ai/blog/context-engineering
- Atlan. How to structure context for LLM applications. https://atlan.com/know/how-to-structure-context-for-llm-applications/
- LangGraph. Persistence. https://docs.langchain.com/oss/python/langgraph/persistence
- LangGraph. Durable execution. https://docs.langchain.com/oss/python/langgraph/durable-execution
- LangGraph. Add memory. https://docs.langchain.com/oss/python/langgraph/add-memory
- Databricks. Memory scaling for AI agents. https://www.databricks.com/blog/memory-scaling-ai-agents
- Google Cloud. What is Model Context Protocol? https://cloud.google.com/discover/what-is-model-context-protocol
- Portable Agent Memory. https://arxiv.org/html/2605.11032v1
- MemORAI. https://arxiv.org/html/2605.01386v1
- ESAA: Event Sourcing for Autonomous Agents in LLM-Based Systems. https://arxiv.org/abs/2602.23193
- Audit Trails for Accountability in Large Language Models. https://arxiv.org/html/2601.20727v1
- STALE. https://arxiv.org/html/2605.06527v1
- Evaluating the Long-Term Memory of Large Language Models. https://aclanthology.org/2025.findings-acl.1014/
- OWASP Agent Memory Guard. https://owasp.org/www-project-agent-memory-guard/
- OWASP. LLM Prompt Injection Prevention Cheat Sheet. https://cheatsheetseries.owasp.org/cheatsheets/LLM_Prompt_Injection_Prevention_Cheat_Sheet.html
- ARGUS. https://arxiv.org/html/2605.11053v1
- Beyond RAG for Agent Memory. https://arxiv.org/html/2602.02007v2
- LongMemEval-V2. https://arxiv.org/html/2605.12493v1
- Agentic Memory. https://arxiv.org/html/2601.01885v2
- Governing Evolving Memory in LLM Agents. https://arxiv.org/html/2603.11768v1
- Giskard. Cross-session leak: when your AI assistant becomes a data breach. https://www.giskard.ai/knowledge/cross-session-leak-when-your-ai-assistant-becomes-a-data-breach
- Unit42. Indirect prompt injection poisons AI long-term memory. https://unit42.paloaltonetworks.com/indirect-prompt-injection-poisons-ai-longterm-memory/
- Diagrid. Checkpoints are not durable execution. https://www.diagrid.io/blog/checkpoints-are-not-durable-execution-why-langgraph-crewai-google-adk-and-others-fall-short-for-production-agent-workflows
- Zero Data Retention in LLM-based Enterprise AI Assistants. https://arxiv.org/abs/2510.11558
Également publié sur LinkedIn.